
预印本 DEED(arXiv 2610.40430,2026-10-29,南京大学 Jingxu Gu、Dongze Lian)是一份比赛方案报告:把预训练的 VLA Xiaomi-Robotics-1 适配到 MetaFine 的五项仿真精细操作任务上。它没有提出新的模型结构,改的是两件事:喂给模型的示范怎样分布,以及模型预测的动作块怎样变成机器人指令。作者报告官方总分(Overall)85.55%,同一榜单上公布的 π0 基线为 43.01%。这篇文章更值得读的是它的拆解:五项任务里有两项只有约 64.6%;几组固定策略的对照显示,执行步数、去噪步数和夹爪映射这类部署设置就能让成绩明显变化。以下数字均为作者报告 [R],本站未复现。
MetaFine 测什么,直接微调缺了什么
按论文的介绍,MetaFine 用五项任务考精细操作:部件级抓取、定向移动、拨动开关、物体分拣和字母插入。按论文表 1 的指令,分别对应 T1(部件 cap 或 body)、T2(向前、向左、向右)、T3(红色或蓝色开关)、T4(红、蓝、绿方块)和 T5(字母 C、o、R、L)。评测分三个维度:Perception(P,相机和光照变化下的感知,用成功率曲线下面积 AUSC 计)、Understanding(U,按指令改变行为)和 Controlled Behavior(B,执行过程中的受控行为)。每项任务的分数是 P、U、B 的平均,Overall 是五项任务分数的平均。
作者认为,直接用官方示范微调预训练 VLA 会留下三个缺口:
- 场景与指令混在一起。如果不同指令只出现在不同场景里,策略可能靠认场景而不是读指令来选目标。作者检查 T5 公开的元数据,发现不同字母子集的场景种子互不重叠,存在这种捷径的机会。
- 视觉覆盖不够。示范里的相机位置和光照条件太少。
- 执行接口不匹配。执行步数、逆运动学转换或夹爪语义与仿真器接口对不上时,预测出的动作块可能失败。
示范扩充:同一场景换指令,同一轨迹换画面
指令配对。对同一个初始场景,用官方专家规划器为该场景的每一条指令各生成一条轨迹:初始布局相同,目标和之后的动作随指令而变。只有当一个场景的所有指令版本都成功时,这组示范才被保留。这样,同样的初始画面对应不同的决定,策略要区分它们就只能读指令。
按物理状态重渲染。在基准自带的 ManiSkill3/SAPIEN 仿真器里,恢复一条已保存轨迹的每个状态,在新的相机和光照参数下重新渲染底座相机和手部相机的图像;本体感觉输入和未来动作目标保持不变,仍然对应原来的物理状态。论文强调,只有观测的成像方式变了,所以视角相关的几何关系和动作标签依然对齐。扰动分三档:相机平移上限 0.03、0.06、0.12 m,旋转上限 2°、6°、12°;光照在环境光 RGB 0.5 附近的半宽为 0.10、0.25、0.40。五项任务都用相机和光照扰动,只有 T5 另加了相机与光照的组合扰动,组合渲染覆盖 120 条基础轨迹。
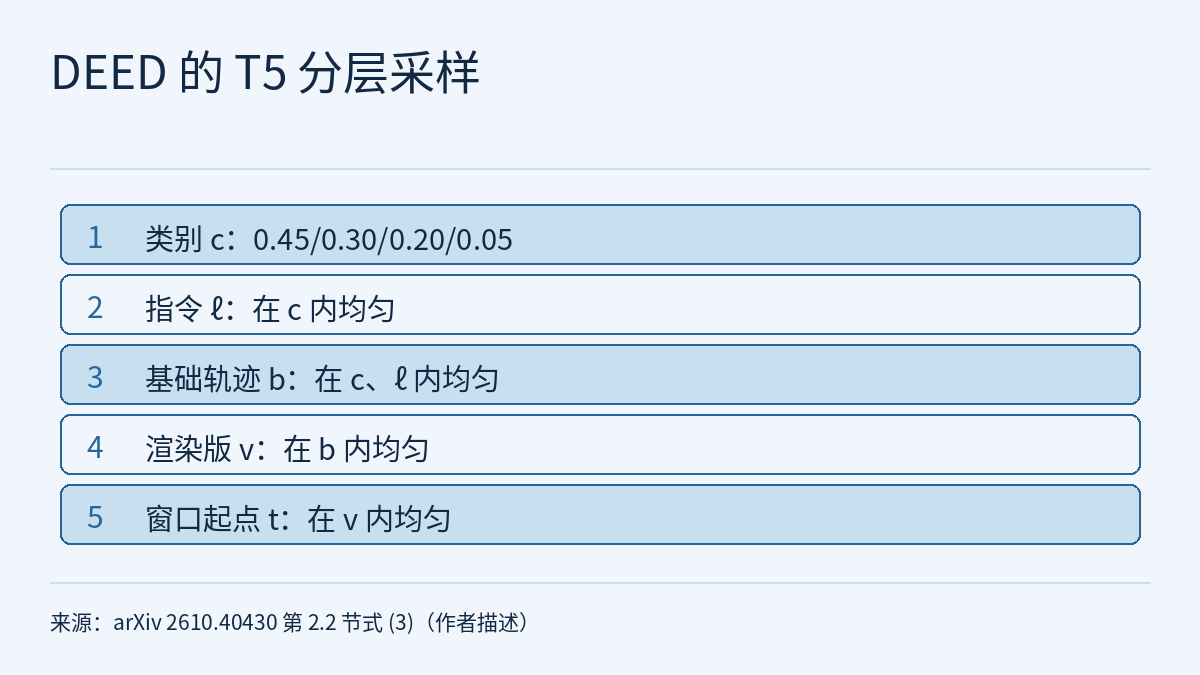
分层采样。扩充之后,渲染副本多的轨迹会被抽得更多。T5 的数据加载器按顺序逐层抽:先按给定概率抽增强类别(干净、相机、光照、组合分别为 0.45、0.30、0.20、0.05),再在该类别内均匀抽指令,再均匀抽基础轨迹,再均匀抽这条轨迹的渲染变体,最后均匀抽训练窗口起点。先抽基础轨迹、后抽渲染变体,所以同一类别和指令下,多渲染几份副本不会提高某条轨迹被抽中的概率。论文特意说明,这个概率是训练数据的抽样分布,不是策略的动作概率。
T5 最终的数据池有 2,800 条不同的成功轨迹,渲染后共 7,840 条记录,其中 2,000 条是从 500 个四指令场景新生成的动作。其余任务的记录数(含渲染变体)为:T1 6,400、T2 3,300、T3 2,080、T4 2,940。
模型输入是任务指令、底座和手眼两路 RGB,以及关节与夹爪状态(7 个臂关节位置加两指位置的平均);一次预测 K = 30 个末端动作,用 flow matching 生成。作者沿用 Xiaomi-Robotics-1 的结构和公开训练实现。T5 最后一轮继续训练用了 12,000 次 BF16 更新(batch 4),余弦学习率从 3 × 10⁻⁶ 降到 5 × 10⁻⁷,预热 300 次。
执行设计:动作块怎样变成关节指令
部署时,策略输出的局部末端偏移先换成世界坐标系下的目标,再由逆运动学算出 7 个关节增量。手指目标被限制在 −0.01 到 0.04 m 之间;低于任务阈值 θ_g 的目标一律映射为完全闭合(−0.01 m),只有 T3 保留连续的夹爪目标。机器人只执行每次 30 步预测里的前 H 步,然后重新观测、重新预测,即滚动时域式的重规划。H、去噪步数 D 和 θ_g 都是按任务分别评测后选定的,没有用一套设置覆盖所有接触(论文表 1):
| 任务 | 配对指令 | 记录数 | H | D | θ_g(mm) |
|---|---|---|---|---|---|
| T1 | cap / body | 6,400 | 10 | 5 | 35 |
| T2 | 向前 / 向左 / 向右 | 3,300 | 25 | 2 | 15 |
| T3 | 红 / 蓝开关 | 2,080 | 25 | 5 | —(连续) |
| T4 | 红 / 蓝 / 绿方块 | 2,940 | 25 | 5 | 35 |
| T5 | C / o / R / L | 7,840 | 25 | 30 | 35 |
结果:一个总分,两种任务
官方最终成绩(论文引用组织方排行榜,更新于 2026-10-24):
| 任务 | P | U | B | 任务分 |
|---|---|---|---|---|
| T1 | 68.96 | 62.50 | 62.50 | 64.65 |
| T2 | 98.47 | 100.00 | 100.00 | 99.49 |
| T3 | 98.96 | 100.00 | 100.00 | 99.65 |
| T4 | 98.15 | 100.00 | 100.00 | 99.38 |
| T5 | 61.15 | 66.25 | 66.25 | 64.55 |
| 平均 | 85.14 | 85.75 | 85.75 | 85.55 |
- 85.55% 是两组任务的平均。T2、T3、T4 都在 99% 以上,部件级抓取 T1 和字母插入 T5 只有 64.65% 和 64.55%。比 π0 基线高 42.54 个百分点,说的是这个总分;所读正文没有给出 π0 的逐项成绩。
- U 和 B 每一行都相同。五项任务的 U 与 B 两列数值完全一致,所读正文没有解释原因,本站也不做推断。
论文另做了几组固定策略的本地对照(权重和归一化在每组比较内固定,flow 噪声种子为 0):
- T1 的执行步数。3 批各 20 个场景,共 60 个场景,每种 H 跑 540 个回合。H = 10 时 P 93.75、U 78.33、SR 90.19;H = 25 为 84.03、69.17、80.93;H = 5 为 85.56、65.83、81.30。SR 把每个场景 2 个干净指令回合和 7 个感知回合按相同权重合并。H = 10 同时高于更长和更短的两档,作者据此说缩短执行窗口并不总是有利。按每个场景 2 个指令回合推算,U 的 78.33% 与 69.17% 约为 120 次中成功 94 次与 83 次(本站换算)。
- T3 的去噪步数。40 个新场景,每种 D 跑 360 个回合。D = 3 与部署用的 D = 5 结果相同(P 98.13、U 97.50、SR 98.06);D = 10 的 P 低 0.83 个百分点,U 低 2.50 个百分点,按上面的推算约为 80 次中少成功 2 次(本站换算)。这组扫描没有测 D = 1。
- 夹爪映射。在一个更早、只做了部分适配的 T1 策略上测了 20 个场景:连续夹爪目标 P = 27.92%、U = 14/40(35.00%);按阈值完全闭合 P = 57.92%、U = 22/40(55.00%)。这组结果来自旧策略,不能直接套到最终提交的策略上。
- 指令有没有被读。在 8 个经专家筛选的 T5 场景上,给正确指令时 32 次成功 21 次(65.63%);把字母指令循环错位后 32 次全部失败(0%),初始状态和图像逐对匹配。本站的读法是:在这 8 个场景里,换掉指令就全部失败,说明成功依赖正确的指令,而不只是认出场景。
读这几组对照要注意,作者自己写明了两点:各设置共用场景种子,但由于仿真环境的历史不同,后续的物理初始状态可能不一样,所以这些是汇总比较,不是初始状态完全匹配的反事实对照;改变 H 也会改变按动作块编号的 flow 噪声序列。此外,本地扫描里 T1 在 H = 10 时 P 为 93.75,官方成绩里 T1 的 P 为 68.96,两者来自不同的评测运行,论文没有解释差距,不能拿本地数字代替官方成绩。
和本站课程与前沿雷达的关系
DEED 的指令配对和重渲染,是 物理AI实验室 1.5:数据从哪来 里“合成”这条来路的一个具体做法,论文也引用了 MimicGen。它补上了 1.5 强调的一点:生成多少条不等于覆盖多少种情况,而 DEED 还额外控制了“同一场景、不同指令”这一维,并用分层采样防止渲染副本悄悄改变训练分布。按物理状态重渲染与 物理AI实验室 2.5:sim2real 的域随机化与系统辨识 讲的域随机化同源(论文引用了 Tobin 等的工作),但这里只随机化了相机和光照,目的是覆盖评测里的视觉扰动,所读正文也没有涉及真机迁移。
“执行前 H 步再重新观测”沿用的是 ACT 的动作分块,见 物理AI实验室 1.6:模仿学习;末端目标经逆运动学换成关节增量,见 物理AI实验室 1.1:坐标系与运动学。前沿雷达|PAV 讨论的也是一个动作块该执行多长,但它在运行时按预测后果逐块决定;DEED 则是离线按任务扫一遍,再给每项任务定一个固定的 H。两篇的基准和策略不同,数字不能互比。至于“共用场景种子却不等于初始状态匹配”“一个平均分盖住逐项差异”,可以对照 物理AI实验室 1.8:评测 里的配对表练一遍。
局限 / 注意
- 这是 arXiv 预印本,全部数字为作者报告 [R]。官方成绩是论文引用的组织方排行榜(论文写明 2026-10-24 更新、2026-10-28 访问),本站没有打开排行榜核对,也没有复现任何结果。
- 所有实验都在 MetaFine 的仿真环境里进行,所读正文没有真机实验,这些结果不是硬件安全验证。
- 重渲染、分层采样和组合扰动的细节主要针对 T5 给出,其余任务的扩充比例只能从表 1 的记录数看出个大概。
- 本地对照每组只用一个 flow 噪声种子,所读正文没有置信区间或显著性检验;夹爪对照来自更早的部分适配策略;指令错位测试只有 8 个场景、每种条件 32 次。
- 论文正文把官方成绩表称为“Table 3”,而该表的标题编号是 Table 2,本地消融表才是 Table 3,属于 HTML 版本里的编号不一致。
- 所读正文没有说明 DEED 的代码或扩充后的数据是否公开。约 94/120、83/120 和 80 次中少 2 次,都是本站按论文给出的回合构成做的换算。
链接
- Improving Fine-Grained Manipulation through Demonstration Expansion and Execution Design(arXiv 2610.40430)
- 论文 HTML 全文
- 物理AI实验室 1.5:数据从哪来,从 SO-101 元数据算出示范时长,再分清三条来路的单位与动作空间
- 物理AI实验室 2.5:sim2real 的域随机化与系统辨识,把两篇论文的数字放回原设定,再从一条推杯轨迹手算摩擦
- 物理AI实验室 1.6:模仿学习,手算误差怎样滚出示范覆盖范围,再把 ACT、扩散策略与数据规模律的数字放回各自条件
- 物理AI实验室 1.1:坐标系与运动学,手算一条两连杆手臂怎样够到杯子
- 物理AI实验室 1.8:评测,把“净增 2”拆成配对表,再给失败标签和随机种子算一笔账
- 前沿雷达|PAV:先在 VLA 自己的表征空间预测每个动作前缀的后果,再决定一个动作块执行多长
- 物理AI实验室:一套每个数字都能核对的物理 AI 课程(课程大纲)


