本节视频
配音由 AI 合成。 视频章节、文字稿与出处
文字稿
文字稿
知行问
给机器人看几遍示范,它就会了?可为什么看了很多遍,有时还是学不会?这一集讲模仿学习:机器人怎么照示范学动作。为什么照着做没那么简单。示范又要给多少才够。
照着做
先说最朴素的想法。看到杯子在左边就往左伸,夹爪对准了就合拢。说白了,就是照着配。这套最基础的做法,叫行为克隆。看得多了,规律自己会浮出来。就像你学骑车。但这里藏着一个坑。机器人一旦走偏,就到了示范里没有的地方。它更不会,于是越走越偏。打个比方。抄写时看错一个字,后面越抄越离谱。机器人走偏,也是这么滚起来的。原来照着做的难处,是错误会滚雪球!
两个办法
研究者想了很多招,这里挑两个有名的。第一个,叫动作分块。不再一步一动,一次给出一小段。一次一小段,机器人就不那么容易在半路走神。抖动少了,错误也没那么容易滚起来。这就是 ACT 的思路。论文称,它学了六个真实任务。像开调料杯、插电池,只用十分钟示范,成功率就到八九成。第二个办法,换个脑子。用扩散模型当策略。它擅长处理:同一个场景,有好几种正确做法。比方绕过障碍,左绕右绕都对。老办法会取个平均,卡在正中间撞上去。扩散策略能各学各的。这叫扩散策略。论文称,在十二个任务上,它跟此前最好的方法比。平均好了近百分之四十七。两个办法路子不同,骨子里都是模仿。都在想同一件事:怎么把错误摁住。分块也好,扩散也好,都在想办法,别让错误滚起来!
给多少才够
还有个实在问题:示范要给多少条?直觉是越多越好。真的吗?一篇论文专门研究了这件事。它发现:每个场景的示范一旦够了,继续增加,作用就很小了。真正管用的是多样性,多换环境、多换物体,比死堆数量强。同一篇论文称,攒够多样数据后,测了两个任务。在新环境、没见过的物体上,成功率约九成。把这画成一条曲线:一开始猛涨,涨到后来就平了。多样性,才是把整条曲线抬高的关键。所以攒数据,别只顾埋头堆数量。多问一句:我覆盖到各种情况了吗?原来不是给得越多越好,是给得越全越好!屏幕上试试。拖动示范条数,再拖场景多样性。看成功率,怎么沿着曲线爬。示范少的时候,策略中途就跑偏,标成琥珀色。示范够多够杂,它稳稳做完,变成绿色。但要当心。这些成功率,都是在测试里测出来的。换个没见过的场景,可能又掉下来。怎么算真的学会了?得换足够多没见过的情况来考。这也是评测的学问,后面还会专门讲。说到底,模仿学的是照做。碰上示范里没有的情况,它就容易懵。这时候,得让它自己试。回顾一下,三个要点。一,模仿学习就是照示范做,但错误会滚雪球。二,动作分块跟扩散策略,让它更稳。三,示范不是越多越好,多样更关键。所以看很多遍还学不会。可能是示范不够杂,或者错误滚了雪球!只会模仿,遇到没见过的怎么办?让它自己试错。下一集见!
证据与出处
80–90% · ACT(动作分块)在开调料杯、插电池等真实任务上的成功率,只用约 10 分钟示范(论文) [R] · arXiv 2304.13705 · ACT / ALOHA
46.9% · Diffusion Policy 在 12 个任务、4 个基准上相对此前最好方法的平均提升(论文) [R] · arXiv 2303.04137 · Diffusion Policy
动手与自测
小测公开,答案与解析在作答后显示;图文课里的练习答案需登录查看。
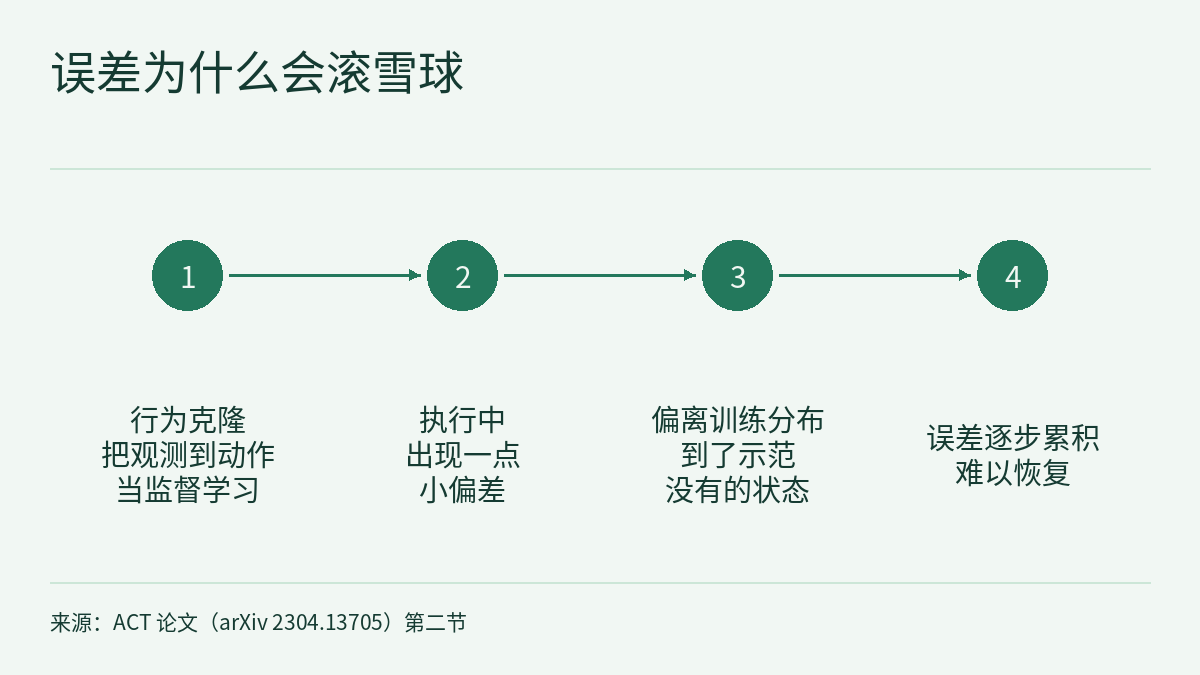
第 1.6 集的视频讲模仿学习:最朴素的做法是行为克隆,把“看到什么、做什么”照着学下来;难处在于机器人一旦走偏,就进入示范里没有的状态,错误越滚越大;动作分块(ACT)和扩散策略(Diffusion Policy)是两个有名的补救办法;示范也不是越多越好,多样性更关键。片中引了三条证据:ACT 论文称,约 10 分钟示范,开调料杯、插电池等真实任务成功率 80–90%;Diffusion Policy 论文称,在 12 个任务上比此前最好的方法平均提升 46.9%;一篇数据规模律论文称,攒够多样数据后,两个任务在新环境、没见过的物体上成功率约 90%。本篇是这一集的图文课与练习,不重复文字稿,而是先把三个数字放回各自论文的实验条件,再用假想数字手算三件事:误差怎样滚出示范覆盖的范围,分块怎样改变“做决定”的次数,两种正确绕法为什么会被平均成一次碰撞;最后把“示范给多少”拆成环境数、物体数和每组示范条数三笔账。贯穿全文的规则:一个成功率只在给出它的那篇论文、那组任务和那套评测里成立。
本节视频、文字稿与出处在本页上方,全季安排见课程大纲。上一课物理AI实验室 1.5:数据从哪来,从 SO-101 元数据算出示范时长,再分清三条来路的单位与动作空间结尾问:数据有了,机器人到底怎么从示范里学会动作?本课接着回答。1.5 第四节已用一组假想的合成方案讲过“生成了多少条”和“覆盖了多少种情况”的区别;本课不再重复,而是看一篇在真实环境里系统改变环境数、物体数和示范数的论文,说了什么、没说什么。
公开小测的 5 道题附完整解析;登录后可完成三项练习:手算一段虚构漂移日志,找出越出示范覆盖范围的那一步,再核对分块与时间集成下的查询次数;算出一组左右绕障的虚构示范为什么被平均成碰撞,并审两个修补方案;审一份虚构的示范采集计划和它的评测说法。每项都附分步解法、常见错误与 20 分评分标准。
一、三条证据,各自的条件
三个数字出自三篇 arXiv 文献,都是作者报告(R 级)。按视频出现的顺序:
| 片中说法 | 出处 | 原文的条件 | 原文没说什么 | 等级 |
|---|---|---|---|---|
| 约 10 分钟示范,开调料杯、插电池等真实任务成功率 80–90% | Zhao、Kumar、Levine、Finn,Learning Fine-Grained Bimanual Manipulation with Low-Cost Hardware(ACT / ALOHA,arXiv 2304.13705,2023-04-23) | 真实世界中的 6 个精细操作任务;80–90% 挂在所举的开半透明调料杯、插电池等例子上;引言写作“10 minutes or 50 demonstration trajectories”;ALOHA 双臂遥操作系统,遥操作与数据记录都是 50 Hz | 所引句子没有说 6 个任务个个都到 80–90%;所引文字没有写明 10 分钟是每个任务各 10 分钟还是合计 | R(作者报告) |
| 12 个任务上比此前最好的方法平均提升近 47% | Diffusion Policy(arXiv 2303.04137,2023-03-07) | 来自 4 个机器人操作基准的 12 个任务,与当时最好的机器人学习方法比较,平均提升 46.9% | 摘要没有说明 46.9% 是相对提升还是百分点,也没有列出 12 个任务中哪些在仿真、哪些在真机 | R(作者报告) |
| 攒够多样数据后,两个任务在新环境、没见过的物体上约 90% | Lin、Hu 等,Data Scaling Laws in Imitation Learning for Robotic Manipulation(arXiv 2410.18647,2024-10-24) | 四名采集者用一个下午采集数据;引言写明这两个任务是 Fold Towels 和 Unplug Charger,每个任务在 8 个新的环境与物体上测试;策略是 Diffusion Policy | 不是所有任务的结果;用来总结规律的另两个任务(Pour Water、Mouse Arrangement)是另一组实验 | R(作者报告) |
三篇论文里对应的原句如下,各自独立摘录:
ACT allows the robot to learn 6 difficult tasks in the real world, such as opening a translucent condiment cup and slotting a battery with 80-90% success, with only 10 minutes worth of demonstrations.
The synergy between these two parts allows learning of 6 fine manipulation skills directly in the real-world, such as opening a translucent condiment cup and slotting a battery with 80-90% success, from only 10 minutes or 50 demonstration trajectories.
We benchmark Diffusion Policy across 12 different tasks from 4 different robot manipulation benchmarks and find that it consistently outperforms existing state-of-the-art robot learning methods with an average improvement of 46.9%.
With four data collectors working for one afternoon, we collect sufficient data to enable the policies for two tasks to achieve approximately 90% success rates in novel environments with unseen objects.
前两句都出自 ACT 论文,第一句在摘要,第二句在引言。读这几句要注意三点:
- 三个百分数不是同一种量。80–90% 是所举真实任务的成功率;46.9% 是相对“此前最好的方法”的平均提升;约 90% 是两个任务在新环境、新物体上的成功率。它们的任务、对照和评测都不同,不能互相比大小,也不能说哪个方法“更好”。
- “10 分钟”和“50 条”是同一句里的两种计量。如果这两个数说的是同一个任务的同一批示范(所引文字没有明说),平均每条约 600 ÷ 50 = 12 s,按 50 Hz 记录约 12 × 50 = 600 个时间步。这是本课的算术,第二节会用到。
- 两种办法后来被放在了一起。数据规模律论文用 Diffusion Policy 建模,又采用了 ACT 提出的时间集成(temporal ensemble)来平滑动作。视频说两个办法路子不同、骨子里都是模仿;在这篇论文里,它们也不是二选一。
登录后继续阅读本课其余各节、自测题与答案。
局限 / 注意
- ACT / ALOHA(arXiv 2304.13705,2023-04-23)、Diffusion Policy(arXiv 2303.04137,2023-03-07)和 Data Scaling Laws in Imitation Learning(arXiv 2410.18647,2024-10-24)的数字都是作者报告,属 R 级。本站没有独立复现其中任何一项。
- 本课依据的是 Diffusion Policy 的摘要、ACT 论文的摘要与正文前几节(摘录在第四节训练流程处截断)、数据规模律论文的摘要与正文前几节(摘录在说明满分的句子中途截断),不含补充材料。ACT 实际使用的 k、时间集成的权重、各任务的逐项成功率,以及数据规模律论文由得分换算成功率的方法,都不在这些文字里。
- 第一节的 12 s 与 600 步,假设“10 分钟”和“50 条”描述的是同一个任务的同一批示范,这一点原文没有明说;第四节的 1,600 条是本课按作者举例做的乘法。这些都是本课的算术,不是来源直接写的数。
- 第二、三、四节的覆盖范围、偏差更新规则、碰撞大小、k = 50、四个关节预测、障碍尺寸、左右比例和 4 × 4 × 100 方案,以及第五节的 R6、示范集 D、方案 A 与 B、团队 D、P1–P3、C1–C5 和全部得分,都是练习用的虚构;算出的 0.8 cm、0.75 cm、第 43 步、0.15 s、−2.4 cm、79%、0.75、0.78 等只在这些假设下成立。偏差模型是教学用的简化,不描述任何真实策略的动力学。
- “各步满分才算完成”、按因素留出测试和直方图检查是教学建议,不是任何来源的定义或结论。纸面计算、浏览器实验页和仿真都不是硬件安全验证。
- 片中实验页的曲线标为示意;本文没有核对实验页的实现。
链接
- 物理AI实验室:一套每个数字都能核对的物理 AI 课程(课程大纲)
- 物理AI实验室 1.5:数据从哪来,从 SO-101 元数据算出示范时长,再分清三条来路的单位与动作空间
- Learning Fine-Grained Bimanual Manipulation with Low-Cost Hardware(ACT / ALOHA,arXiv 2304.13705)
- Diffusion Policy(arXiv 2303.04137)
- Data Scaling Laws in Imitation Learning for Robotic Manipulation(arXiv 2410.18647)