本节视频
配音由 AI 合成。 视频章节、文字稿与出处
文字稿
文字稿
知行问
想让机器人学会抓杯子,得先给它看很多遍示范。这些示范,谁来做?这一集讲清楚,机器人的动作数据,三条来路。远程操控、人类视频、合成。各有各的代价。
遥操作
最直接的办法,是人来带。人替机器人做一遍。它一边做,一边把动作录下来。常见的做法,是主从两只臂。你动主臂,机器人的从臂跟着动。人的手艺,就这样传过去。拿 SO-101 这套抓放数据集举例。五十段示范,每段两路相机。每秒三十帧,还记下六个关节的读数。两路相机,一路朝下、一路侧看。六个关节的读数,就是动作标签。看着画面,就能懂它在学什么。跳到抓起积木那一下,机械手慢慢合拢,六条曲线一起动。这就是干净利落地抓一次,长什么样子。这办法最靠谱,动作干净。可它又慢又贵。一段一段,全得真人来录。怎么办?一篇论文把大家的数据凑一起。二十一家机构、二十二种机器人,五百多种技能。原来一家一家攒太慢,大家拼起来才够用!
人类视频
还有更省的办法。不用机器人,直接看人干活。人在头上绑一台相机,从自己的视角拍下视频。为什么盯着人?因为人天天都在干活。这样的视频,多得几乎取之不尽。量能有多大?二零二六年初,一篇论文用了两万多小时这样的视频。拿来预训练机器人。同一篇论文还发现一件事。用的人类视频越多,模型学得越好。几乎像一条规律。不过原始视频还不够。得先给它标上动作,模型才学得动。这一步,本身就费功夫。还有个难处。人的手,不是机器人的手。视频里没有精确的关节角,也没有力。看人干活能学,但得先把人手,翻译成机器手!
合成
第三条路,是在仿真里造数据。还记得上一集的仿真器吗?让它自动演,就能演出很多。怎么造?先让真人做几条示范。系统再把这几条,自动搬到新场景、新位置。好处是变化多。换个位置、换个物体,都能自动生成。真人一段段地拍,根本跟不上。有多省?研究者用一套系统,拿约两百条人类示范,生成了五万多条。覆盖十八个任务。省是真省。可合成的再多,也逃不过一个问题。它到底像不像真的?三条路我都懂了。可数据越多,就一定越好吗?答案是:不一定。数据不光要多,还要杂、要覆盖各种情况。光堆数量,作用会到头。把三条路排一排。远程操控最准,人类视频最多,合成最灵活。没有一条能单独包打天下。三条路,其实常常混着用。怎么配比,怎么保证质量。这些至今没有定论。屏幕上,我们逐帧翻一段示范。两路相机、六个关节的曲线,一起走。跑偏在哪,一眼看得见。回顾一下,三个要点。一,远程操控最直接,动作干净,但慢又贵。二,人类视频量大,可人手不是机器手。三,合成能放大,但要防它失真。所以数据不是天上掉的,是人一段段带、机器帮着放大出来的!数据有了,机器人到底怎么从示范里学会动作?下一集见!
证据与出处
22 种 · 22 种机器人的数据拼进同一个数据集(21 家机构、527 种技能) [R] · arXiv 2310.08864 · Open X-Embodiment
20,854 小时 · 带动作标注的第一视角人类视频,用来预训练机器人(论文称比此前同类大 20 倍以上,约合连续 2.4 年) [R] · arXiv 2602.16710 · EgoScale
5 万多条 · 用约 200 条人类示范自动生成的示范数(覆盖 18 个任务,仿真中,论文) [R] · arXiv 2310.17596 · MimicGen(CoRL 2023)
动手与自测
小测公开,答案与解析在作答后显示;图文课里的练习答案需登录查看。
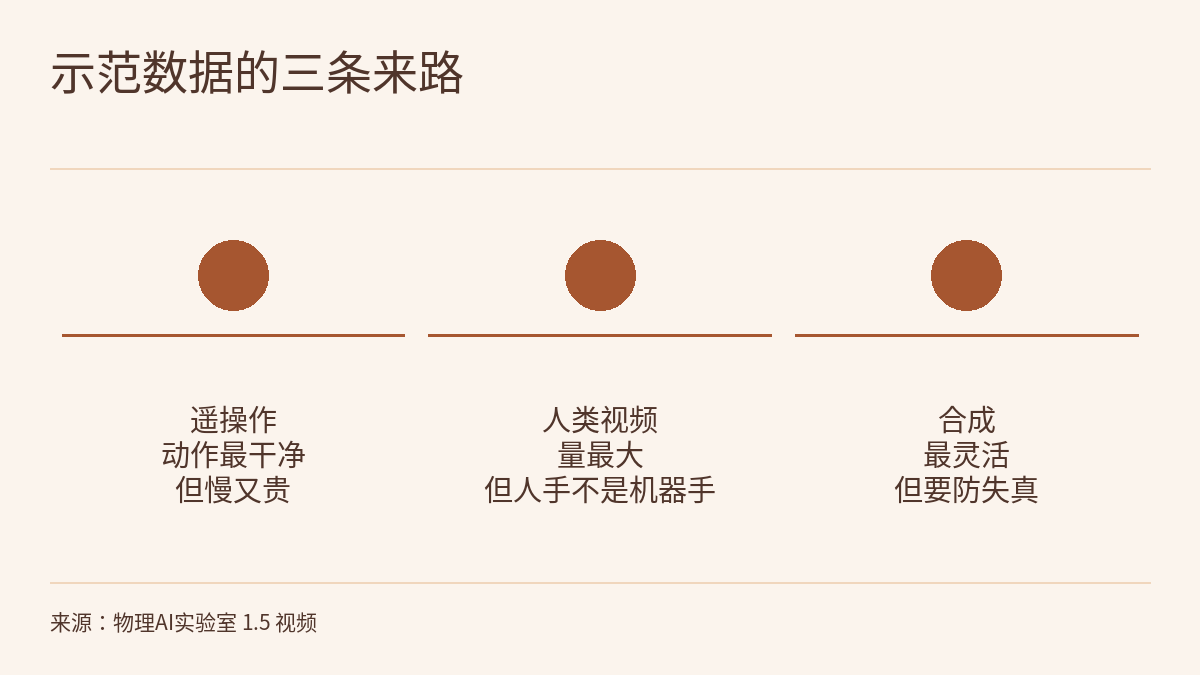
第 1.5 集的视频讲机器人动作数据的三条来路:遥操作动作最干净,但又慢又贵;人类视频量大得多,可人手不是机器手,还得标注、对齐;合成能用少量真示范放大出海量,但要防它失真。片中引了四条证据:SO-101 抓放数据集有 50 段示范,每段两路相机、每秒 30 帧;Open X-Embodiment 把 22 种机器人的数据拼进一个数据集;EgoScale 用了 20,854 小时以上的第一视角人类视频;MimicGen 从约 200 条人类示范生成了 5 万多条。本篇是这一集的图文课与练习,不重复文字稿,而是先打开 SO-101 数据集的元数据文件,算出这 50 段一共录了多久、每一帧存了哪几个数;再看三条来路的数据为什么不能直接倒进同一个训练集:单位、动作空间和“一条示范”的含义各不相同;最后用一组假想数字,分清“生成了多少条”和“覆盖了多少种情况”。贯穿全文的规则:一个数字只描述它自己的数据集,只用它自己的单位。
本节视频、文字稿与出处在本页上方,全季安排见课程大纲。上一课物理AI实验室 1.4:仿真器地图,手算步长代价、找出接触分叉点,再给三个提速数字标清基线结尾问:这些要练的动作数据,最早又是从哪来的?本课接着回答。Open X-Embodiment 和 EgoScale 的规模数字,物理AI实验室 0.2:为什么是现在,数据、模型、算力三条曲线已经讲过,本课不再重复,只补上与本集有关的两点:多机器人数据的动作空间怎样对齐,以及 EgoScale 的缩放关系说的是哪个量。
公开小测的 5 道题附完整解析;登录后可完成三项练习:读一份虚构数据集的元数据,算出时长并按整段切分训练与测试;给一份混用四类数据的虚构计划逐项记账,找出维数相同、含义不同的动作空间;审一份引用本集四条证据的虚构备忘录并逐句改写。每项都附分步解法、常见错误与 20 分评分标准。
一、四条证据,各自数的是什么
片中四个数字分属四份材料,数的对象和单位都不一样:
| 片中说法 | 出处 | 数的是什么 | 单位 | 等级 |
|---|---|---|---|---|
| 50 段、两路相机、每秒 30 帧 | LeRobot 的 svla_so101_pickplace 数据集元数据(固定提交 f641879) | 一个抓放任务的示范回合(视频称为遥操作;元数据未记录录制方式) | 段(episode);帧/秒 | O(数据集元数据) |
| 22 种机器人、21 家机构、527 种技能 | Open X-Embodiment(arXiv 2310.08864) | 拼进同一数据集的机器人本体、合作机构和技能 | 种;家 | R(作者报告) |
| 20,854 小时以上 | EgoScale(arXiv 2602.16710) | 带动作标注的第一视角人类视频 | 小时 | R(作者报告) |
| 约 200 条生成 5 万多条 | MimicGen(arXiv 2310.17596) | 人类示范与自动生成的示范 | 条;覆盖 18 个任务 | R(作者报告) |
三篇论文里对应的原句如下,各自独立摘录:
We assemble a dataset from 22 different robots collected through a collaboration between 21 institutions, demonstrating 527 skills ( 160266 tasks).
We train a Vision Language Action (VLA) model on over 20,854 hours of action labeled egocentric human video, more than 20 times larger than prior efforts, and uncover a log linear scaling law between human data scale and validation loss.
We use MimicGen to generate over 50K demonstrations across 18 tasks with diverse scene configurations, object instances, and robot arms from just ~200 human demonstrations.
读这张表要注意三点:
- 单位不同,不能比大小。段、小时、种、条是四种单位。50 段机器人示范和 20,854 小时人类视频不能相除得出“差多少倍”:前者每一帧都存了关节读数,后者按视频的说法没有精确的关节角,也没有力。
- “22 种”数的是机器人本体,不是示范条数。Open X-Embodiment 论文第三节另写,数据集含 1M+ 条真实机器人轨迹,由全球 34 个机器人研究实验室的 60 个已有数据集合并而成。21 家机构和 34 个实验室也是两种不同的计数,不要混用。
- 5 万多条是生成的,人类示范只有约 200 条。片中数字卡把 MimicGen 的结果标为仿真中、论文报告。生成条数和真人录制的条数不是同一种“条”,第四节会再算一次。
登录后继续阅读本课其余各节、自测题与答案。
局限 / 注意
- Open X-Embodiment(arXiv 2310.08864,2023-10-13)、MimicGen(arXiv 2310.17596,2023-10-26,CoRL 2023)和 EgoScale(arXiv 2602.16710,2026-02-18)的数字都是作者报告,属 R 级;EgoScale 是预印本。本站没有独立复现其中任何一项。本课依据的是 Open X-Embodiment 的摘要和正文前几节(第四节的摘录在 roll 之后截断),以及 MimicGen 和 EgoScale 的摘要,不含补充材料。
- SO-101 的数值来自 svla_so101_pickplace 数据集在固定提交 f641879 的
meta/info.json,属 O 级。本课只读了这份元数据文件,没有下载或核对数据文件和视频;元数据描述的是字段和计数,不说明示范质量、成功与否、录制方式或采集成本。 - 238.78 帧、7.96 s、397.97 s、23,878 张、307,200 像素、71,634 个数和约 250 倍,都是本课按所列数字做的算术,不是来源直接写的数。对数线性关系里的 a、b 是本课为说明写的符号,200、2,000、20,000 小时是举例,不是 EgoScale 的数据点。
- 第四节的团队 T、杯子 C1–C4 和方案 G1、G2,以及第五节的 cup_place_demo、团队 K、机械臂 K1、数据 S1–S4、备忘录 M1–M4,都是练习用的虚构,不是任何数据集、团队或系统的数据。按因素留出、按整段切分和“记一本账”是教学建议,不是任何来源的结论;纸面计算和仿真结果都不是硬件安全验证。
- 本文没有核对视频实验页(逐帧浏览 SO-101 示范)的实现。
链接
- 物理AI实验室:一套每个数字都能核对的物理 AI 课程(课程大纲)
- 物理AI实验室 1.4:仿真器地图,手算步长代价、找出接触分叉点,再给三个提速数字标清基线
- 物理AI实验室 1.1:坐标系与运动学,手算一条两连杆手臂怎样够到杯子
- 物理AI实验室 0.2:为什么是现在,数据、模型、算力三条曲线
- Hugging Face:lerobot/svla_so101_pickplace 数据集
- svla_so101_pickplace 的 meta/info.json(固定提交 f641879)
- Open X-Embodiment: Robotic Learning Datasets and RT-X Models(arXiv 2310.08864)
- EgoScale(arXiv 2602.16710)
- MimicGen(arXiv 2310.17596,CoRL 2023)