本节视频
配音由 AI 合成。 视频章节、文字稿与出处
文字稿
文字稿
知行问
一台机器人,成功率听着挺高。可光凭这一个数字,你敢信吗?这一集,我们把一个成功率拆开,看它没告诉你的三件事。一个数字,好记、好比,也好上头条。可它太干净了,把该问的都盖住了。怎么判断一个策略行不行?我们跑很多次,数一数成功几次。这就是评测。成功率,就是成功次数,除以一共尝试的次数。所以先得知道,到底做了几次。
在什么条件下测的
举个真实的例子。有人拿一个机械臂策略,做了个公开的压力测试。总共跑了三十次。同一个任务,换正常光、暗光、移动摄像头三种条件。每次都有个固定预算。最多一百六十个动作,八秒仿真时间,到点就停。先看光。暗光那组,和正常光比,成功的组合就变了样。他们还做了配对。同一个起始状态,三种条件各跑一遍。这样才好一对一地比。看结果。移动了摄像头,成功数一共多了两次。可拆开看,是三次变好、一次变坏。原来一个“净增”,能把变好和变坏,悄悄抵消掉!所以第一件事,先问清楚。这个成功率,是在什么条件下测的。
失败也分好几种
三十次不算多。样本一少,运气好坏就能把成功率抬高或压低。先看分母。同样这三十次里,十四次失败。全都是用完动作预算才停下的。用完步数才停,说明它没放弃。只是没在规定动作里做完。但失败不等于卡住。实验记录里,末端还在动。最后那段,移动了四十多到一百三十多毫米。一个“失败”标签,把好几种情况混成了一样。卡住不动、还在努力、就差一点,其实很不一样。举一组种子。正常光成功了。可暗光和移动摄像头,都没做完,允许的步数用完了。原来光看成功率,连它是怎么摔的都不知道!别忘了演示的套路。放出来的视频,常常是挑最好的一次剪的。
一次结果不算数
强化学习里到处是随机。初始位置、探索、种子,换一个,结果可能就不同。同样的方法,换个种子,分数就上下跳。少跑几次,很可能只是运气。有论文专门提醒。只跑几次就下结论,很容易看走眼。那份实验做了件好事。把整套原样重跑一遍,三十次结果一次不差。但这只说明,同样条件下能复现。换个任务、换个种子,不一定还这样。多跑几次,把分数的高低范围也报出来。别人才知道,这数字有多稳。所以认真的评测,会多跑几次,报一个区间,而不是只给一个数。还得说清楚。这是个小规模对照实验,不是官方跑分。真实部署会更复杂。所以看到一个成功率,多问四句。条件、次数、怎么失败、能不能重复。你在页面里选一个条件、挑一组种子。把三十次结果,一格格排开看。回顾一下,三个要点。一,成功率要问:在什么条件下测的。二,失败也分好几种,要看它怎么失败。三,一次结果不算数,要重复、要看波动。别被一个漂亮的成功率骗了。要多问几句,它到底是怎么测的!上手这一档,到这儿就修完了。想自己在仿真里搭个抓取场景吗?下一集见!
证据与出处
14 次 · 全部 14 次失败都是用完动作预算才停下(robot-reel 压力实验室) [O] · robot-reel · SmolVLA 压力实验室(README)
动手与自测
小测公开,答案与解析在作答后显示;图文课里的练习答案需登录查看。
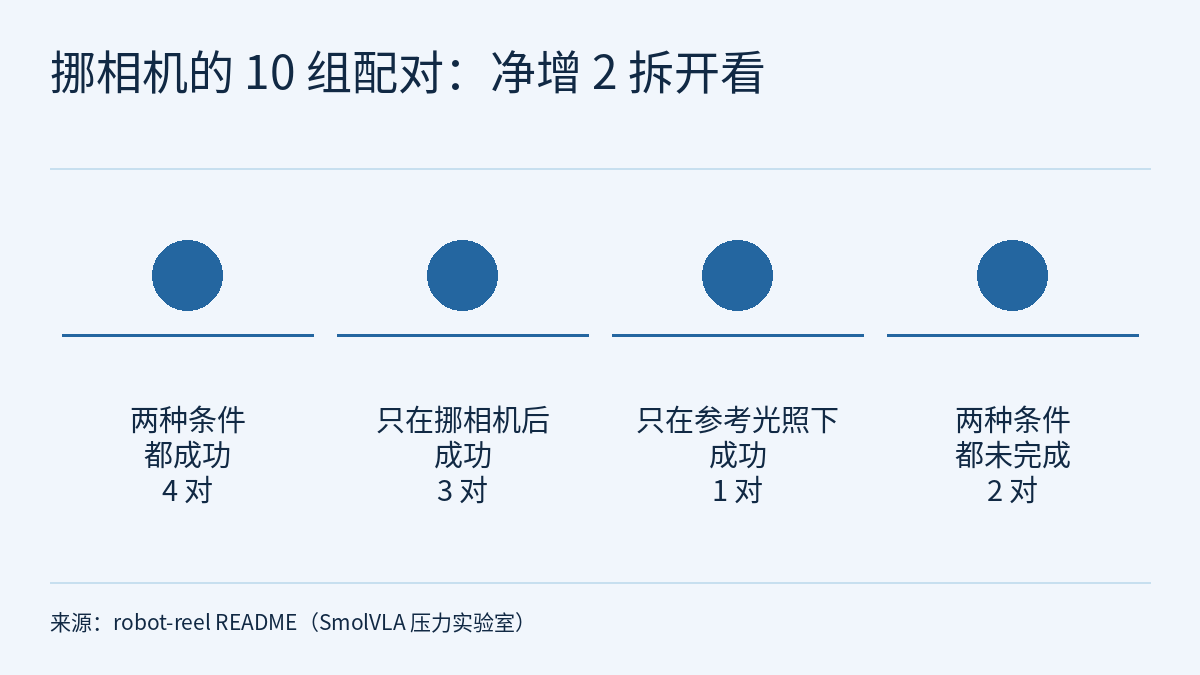
第 1.8 集的视频把一个成功率拆开,问它没告诉你的三件事:在什么条件下测的(一个总数会把变好和变坏抵消掉),失败是哪一种(一个“失败”标签会盖住它怎么失败),结果能不能重复(换个种子分数就跳,要重复、看波动、报区间)。片中贯穿的例子是 robot-reel 的 SmolVLA 压力实验室:同一任务、三种条件、30 次仿真闭环测试;第三章另引了 Henderson 等的 Deep Reinforcement Learning that Matters(arXiv 1709.06560)。本篇是这一集的图文课与练习,不重复文字稿,而是把这些数字背后的计算摊开:先由 README 的几处记录推出每种条件各成功几次,把“净增 2”排成一张配对表,再按 README 报告的精确符号检验数一遍 p 值从哪来;然后看“仍在运动”这个失败标签靠的是哪条 1 mm 判据、换阈值会不会变;最后把“原样重跑一致”和“换种子分数会跳”分成两件事。贯穿全文的规则:一个成功率只属于它自己的任务、条件、预算和次数,一次检验只说明它自己的那组配对。
本节视频、文字稿与出处在本页上方,全季安排见课程大纲。上一课物理AI实验室 1.7:强化学习,手算一局回报看奖励怎样被钻空子,再读论文里的地形课程与超时重置结尾问:它到底有多行?一个成功率,藏着多少没说的?本课接着回答。这个压力实验室作为开源项目的整体介绍见Robot Reel:把机器人策略仿真变成可逐帧核对的回放与三维场景,本课只用其中与评测方法有关的几条记录。需要说明:robot-reel 由 NoteFlowAI 发布,与本课程是同一机构,下文按 O 级(项目自述)对待,本站没有独立复现。
公开小测的 5 道题附完整解析;登录后可完成三项练习:给一份 12 组配对的虚构评测记账并手算精确符号检验、在 4 个停滞阈值下给 8 次虚构失败重新分类并审两句结论、把同一方法的 10 个虚构种子拆成两组并审三句报告。每项都附分步解法、常见错误与 20 分评分标准。
一、两份材料,各自说了什么
片中的 robot-reel 数字都出自项目 README,本课读的是 2026-10-10 抓取的 main 分支版本。第三章的“论文提醒”出自 Peter Henderson、Riashat Islam、Philip Bachman、Joelle Pineau、Doina Precup 和 David Meger 的 arXiv 预印本(v1,2017-09-19 提交),作者来自 McGill University 与 Microsoft Maluuba。README 里的相关原句,按原文顺序各自摘录:
SmolVLA runs the same task under reference lighting, reduced light and a shifted camera. Explore 30 real closed-loop trials across ten paired initial states.
The camera condition’s net gain of two successes includes three gains and one loss.
All 14 unsuccessful trials reached the action limit.
Every trial remained above the 1 mm stall threshold: end-effector travel over the final tenth of each episode ranged from 44.8 mm to 138.6 mm.
One repeat of the full plan on the same L40S matched 30 / 30 outcomes, action counts, recorded robot states and actions, and 360 / 360 rendered frames consumed by policy calls.
Fixed budget: 160 actions / 8 simulation seconds per trial.
Henderson 等论文“Random Seeds and Trials”一节的原句:
We perform 10 experiment trials, for the same hyperparameter configuration, only varying the random seed across all 10 trials. We then split the trials into two sets of 5 and average these two groupings together.
放进一张表,“原文没有说什么”一列同样重要:
| 片中说法 | 出处 | 原文的条件 | 原文没有说什么 | 等级 |
|---|---|---|---|---|
| 30 次,三种条件 | robot-reel README | SmolVLA 做同一任务;参考光照、减弱光照、挪动相机;10 个配对起始状态各跑三种条件;以 NVIDIA L40S / CUDA 推理录制 | README 写明这是受控诊断,不是官方 LIBERO 基准分;只有一个任务 | O(项目自述) |
| 160 个动作 / 8 秒 | 同上 | 每次测试的固定预算 | 预算更大时的任务进度和成功率,README 说需要另行评测 | O |
| 净增 2 = 3 次变好、1 次变坏 | 同上 | 挪相机条件的逐对结果 | README 说这个单一任务不能确立一般的鲁棒性或因果关系 | O |
| 14 次失败,末端仍移动 44.8–138.6 mm | 同上 | 失败都到了动作上限;每次最后十分之一段的末端位移都高于 1 mm 停滞线 | 只说明截止时还在动,不说明任务进度 | O |
| 原样重跑,30 / 30 一致 | 同上 | 在同一块 L40S 上把完整计划重跑一次 | README 说它不确立一般的确定性,也不能单凭它做因果归因 | O |
| 10 次拆成两组各 5 次 | Henderson 等 | 同一套超参数,只换随机种子;论文研究的是 MuJoCo 连续控制任务上的策略梯度方法 | 论文说给不出一个推荐的具体次数 | R(作者报告) |
读这张表要注意三点:
- 两份材料研究的不是同一种随机。robot-reel 评测的是一个已训练的策略(SmolVLA)在固定预算下的测试结果;Henderson 等讨论的是强化学习训练本身的随机性,论文举的来源是环境的随机性和学习过程中随机数生成器带来的随机性(例如权重初始化)。视频第三章把两者放在一起讲“一次结果不算数”,但不能把论文里的方差直接套到 robot-reel 的成功率上。
- robot-reel 的数字都来自同一个任务、同一套仿真。README 还写明,它在 Hugging Face 上的 30 行试验记录和 20 行配对记录是这次试点的表格证据,不是训练数据集,也不是官方基准。
- README 会更新。它是 main 分支上的文件,不是固定提交;本课依据的是 2026-10-10 抓取的版本。
登录后继续阅读本课其余各节、自测题与答案。
局限 / 注意
- robot-reel README 的数字属 O 级项目自述,由 NoteFlowAI 发布,与本课程是同一机构;本站没有独立复现。本课读的是 2026-10-10 抓取的 main 分支 README,没有读它链接的 docs/stress.md 等文件,也没有打开实验页或 Hugging Face 数据集。README 写明这是受控诊断,不是官方 LIBERO 基准分;它只有一个任务,在仿真中运行,用 NVIDIA L40S 推理。
- 参考光照 5 次、减弱光照 4 次、挪相机 7 次成功是本课由 README 三处记录推算的;“失去”“新增”按相对参考光照理解,README 的所引文字没有逐字写出比较对象。README 提到实验页给出每种条件的置信区间,所引文字没有数值和算法,本课没有计算。
- Deep Reinforcement Learning that Matters(arXiv 1709.06560v1,2017-09-19)属 R 级预印本,实验是 OpenAI Gym 的 MuJoCo 环境上的策略梯度方法(TRPO、DDPG、PPO、ACKTR);表 3 的数字是作者报告。本课依据的是论文正文到图 5 说明开头的摘录,不含补充材料。论文讨论的是训练过程的随机性,不是已训练策略在压力测试中的成功率。
- 符号检验的组合数、“至少需要 6 个不一致对”、44.8 mm 高于 5 mm 所以不改标签、区间宽度等都是本课的算术和解释。本站没有运行 README 中的任何命令。
git clone取的是 main 分支,没有固定到某个提交;README 在 PyPI 安装说明里固定的是 robot-reel==0.19.1,而--paired-exact要求 0.17.1 及以上。 - 第五节的策略 P 与 Q、条件 R 与 N、种子 01–12、f1–f10、200 与 300 个动作、方法 M、基线 N、团队 T、所有回报、批次与句子都是练习用的虚构;算出的 58.3%、0.03125、0.0625、2040、1654、1847、2390、68.3% 等只在这些假设下成立。“可用 / 需改写 / 不可用作代表”的分法和实验约定是教学建议,不是任何来源的结论。仿真评测和纸面计算都不是硬件安全验证。
- 本文没有核对片中互动页面的实现。
链接
- 物理AI实验室:一套每个数字都能核对的物理 AI 课程(课程大纲)
- 物理AI实验室 1.7:强化学习,手算一局回报看奖励怎样被钻空子,再读论文里的地形课程与超时重置
- Robot Reel:把机器人策略仿真变成可逐帧核对的回放与三维场景
- 前沿雷达|Beyond Binary Success:真机评测次数有限时,用序贯检验更早分出策略优劣
- 前沿雷达|Is Success All You Need?:成功率相近的两个 VLA,成功轨迹可能差得很远
- robot-reel README(SmolVLA 压力实验室;main 分支,2026-10-10 抓取)
- Deep Reinforcement Learning that Matters(arXiv 1709.06560v1)