この回の動画
ナレーションは AI 合成音声です。 動画の章・文字起こし・出典
文字起こし
文字起こし
知行の問い
ロボットの成功率、けっこう高く聞こえるよね。でも、その数字一つだけで、信じられる?今回は、一つの成功率を分解して、それが教えてくれない三つのことを見ていきます。数字一つは、覚えやすく、比べやすく、見出しにもしやすい。でも、きれいすぎて、聞くべきことを全部隠してしまいます。方策が使えるかどうか、どう判断するのでしょう?何度も走らせて、何回成功したかを数えます。これが評価です。成功率とは、成功した回数を、試した回数の合計で割ったものです。だから、まず何回試したのかを知る必要があります。
どんな条件で測ったのか
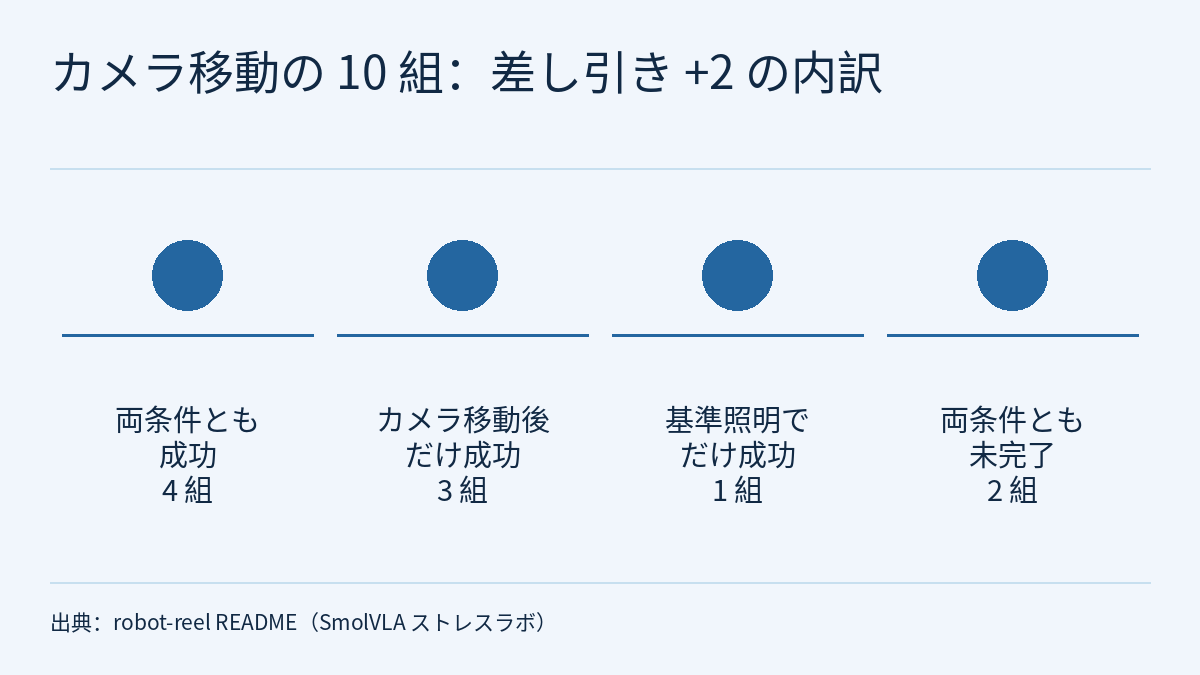
本物の例を見てみましょう。ある人が、ロボットアームの方策に、公開のストレステストをしました。全部で三十回。同じ作業を、ふつうの明るさ、暗い照明、カメラをずらした状態の、三つの条件で走らせました。一回ごとに、決まった予算があります。動作は最大百六十回、シミュレーション時間は八秒。時間が来たら止まります。まずは光です。暗い照明の組では、ふつうの明るさと比べて、成功した組み合わせが変わりました。対応づけもしてあります。同じ初期状態から、三つの条件で一回ずつ走らせる。こうすれば、一対一で比べられます。結果を見ます。カメラをずらすと、成功数は差し引き二回増えました。でも分けてみると、三回良くなって、一回悪くなっています。「差し引き」だけだと、良くなった分と悪くなった分が、こっそり打ち消し合っちゃうんだ!だから、まずはっきり聞くこと。この成功率は、どんな条件で測ったのか。
失敗にもいろいろある
三十回は、多くありません。サンプルが少ないと、運の良し悪しだけで、成功率が上がったり下がったりします。まず、試した回数を見ましょう。同じ三十回のうち、失敗は十四回。どれも、動作の予算を使い切ってから止まっていました。手数を使い切るまで止まらなかったのは、あきらめていない証拠です。決められた動作の中で、終わらなかっただけです。でも、失敗は、動けなくなったのとは違います。記録では、アームの先はまだ動いていました。最後の区間で、四十ミリあまりから、百三十ミリあまり動いています。「失敗」というラベル一つで、いくつもの状況が一緒くたになります。止まって動かない、まだ頑張っている、あと少し。本当は、まるで違います。一組のシードを見てみます。ふつうの明るさでは成功。でも暗い照明とカメラをずらした状態では、終わらないまま、手数を使い切りました。成功率だけじゃ、どうやって失敗したのかも分からないんだ!デモのお決まりも忘れずに。公開される動画は、たいてい、いちばん良かった一回から編集されています。
一回の結果では決まらない
強化学習は、ランダムだらけです。初期位置、探索、シード。どれか一つ変えるだけで、結果が変わるかもしれません。同じ方法でも、シードを変えると、点数が上下にぶれます。少ない回数しか走らせないと、ただの運かもしれません。この点を、はっきり注意している論文もあります。数回だけ走らせて結論を出すと、見誤りやすいのです。あの実験は、良いこともしています。全体をそのまま走らせ直して、三十回の結果が一つ残らず一致しました。ただしこれは、同じ条件なら再現できる、というだけです。作業やシードを変えても同じとは限りません。何回か多めに走らせて、点数の高い低いの幅も報告する。そうすれば、その数字がどれだけ安定しているか、ほかの人にも分かります。だから、しっかりした評価は、何回か走らせて、数字一つではなく、区間で報告します。はっきり言っておくことも必要です。これは小規模な対照実験で、公式のベンチマークではありません。実際の導入は、もっと複雑です。だから、成功率を見たら、四つ聞いてみましょう。条件、回数、失敗の仕方、そして繰り返せるか。ページで、条件を一つ選び、シードを一組選んでください。三十回の結果を、一マスずつ並べて見られます。ふりかえりです。ポイントは三つ。一つ、成功率は、どんな条件で測ったのかを聞く。二つ、失敗にもいろいろある。どう失敗したのかを見る。三つ、一回の結果では決まらない。繰り返して、ぶれを見る。きれいな成功率にだまされないで。本当はどうやって測ったのか、もう少し聞いてみよう!入門の段階は、これでおしまい。シミュレーションで、つかみのシーンを自分で作ってみたくない?また次回!
根拠と出典
14回 · 14回の失敗すべてが、動作の予算を使い切ってから止まった(robot-reel ストレスラボ) [O] · robot-reel · SmolVLA ストレスラボ(README)
練習とセルフチェック
小テストは公開で、回答するとすぐ解説が出ます。読み物の練習問題の答えはログイン会員向けです。
第 1.8 回の動画は、一つの成功率を分解して、それが教えてくれない三つのことを問います。どんな条件で測ったのか(合計では良くなった分と悪くなった分が打ち消し合う)、どんな種類の失敗なのか(「失敗」というラベル一つでは、どう失敗したのかが隠れる)、結果を繰り返せるのか(シードを変えると点数がぶれるので、繰り返し、ばらつきを見て、区間を報告する)、の三つです。全体を通じた例は robot-reel の SmolVLA ストレスラボで、同じ作業・三つの条件・30 回のシミュレーションの閉ループテストです。第 3 章では Henderson らの Deep Reinforcement Learning that Matters(arXiv 1709.06560)も引いています。このページはこの回の解説と練習です。文字起こしを繰り返すのではなく、数字の裏にある計算を広げて見せます。まず README のいくつかの記録から条件ごとの成功回数を求め、「差し引き +2」を対応表に並べ、README が報告する正確な符号検定の p 値がどこから来るのかを数えます。次に、「まだ動いている」という失敗ラベルがどの 1 mm の基準に拠っているのか、しきい値を変えるとラベルが変わるのかを見ます。最後に、「そのまま再実行して一致した」ことと「シードを変えると点数がぶれる」ことを別々のこととして分けます。全体を通じたルールは一つです。成功率はそれ自身の作業・条件・予算・回数にだけ属し、一つの検定はそれ自身の対応の組についてだけ語ります。
この回の動画、文字起こし、出典はこのページの上部にあり、シーズン全体の構成は講座の概要にあります。前回のフィジカルAIラボ 1.7:強化学習――1 回分の収益を手で計算して報酬の抜け道を見つけ、論文の地形カリキュラムとタイムアウト時のリセットを読むは、ロボットは実際どれくらいできるのか、一つの成功率にどれだけ言われていないことがあるのか、という問いで終わりました。今回はその続きです。このストレスラボのオープンソース・プロジェクトとしての全体像はRobot Reel:ロボットの方策シミュレーションを、コマ単位で検証できる再生と 3D シーンにで紹介しています。この回では、評価の方法に関わる記録だけを使います。なお、robot-reel は本講座と同じ組織である NoteFlowAI が公開しているもので、以下では O レベル(プロジェクト自身の説明)として扱います。本サイトでは独立に再現していません。
公開小テストの 5 問には詳しい解説が付いています。ログインすると、三つの練習に取り組めます。12 組の対応づけた架空の評価を記帳し、正確な符号検定を手で計算する。8 回の架空の失敗を 4 つの停滞しきい値で分類し直し、二つの結論を審査する。同じ手法の架空の 10 シードを二組に分け、報告の三つの文を審査する。いずれも段階的な解答例、よくある誤り、20 点満点の採点基準付きです。
1. 二つの資料が、それぞれ何を言っているか
動画に出てくる robot-reel の数字はすべてプロジェクトの README から来ています。この回で読んだのは、2026-10-10 に取得した main ブランチの版です。第 3 章の「論文の注意」は、Peter Henderson、Riashat Islam、Philip Bachman、Joelle Pineau、Doina Precup、David Meger による arXiv のプレプリント(v1、2017-09-19 投稿)で、所属は McGill University と Microsoft Maluuba です。README の該当する文を、原文の順に一つずつ抜粋します。
SmolVLA runs the same task under reference lighting, reduced light and a shifted camera. Explore 30 real closed-loop trials across ten paired initial states.
The camera condition’s net gain of two successes includes three gains and one loss.
All 14 unsuccessful trials reached the action limit.
Every trial remained above the 1 mm stall threshold: end-effector travel over the final tenth of each episode ranged from 44.8 mm to 138.6 mm.
One repeat of the full plan on the same L40S matched 30 / 30 outcomes, action counts, recorded robot states and actions, and 360 / 360 rendered frames consumed by policy calls.
Fixed budget: 160 actions / 8 simulation seconds per trial.
Henderson らの論文の「Random Seeds and Trials」節の文です。
We perform 10 experiment trials, for the same hyperparameter configuration, only varying the random seed across all 10 trials. We then split the trials into two sets of 5 and average these two groupings together.
一つの表にまとめます。「原文が言っていないこと」の列も同じくらい大切です。
| 動画での言い方 | 出典 | 原文の条件 | 原文が言っていないこと | レベル |
|---|---|---|---|---|
| 30 回、三つの条件 | robot-reel README | SmolVLA が同じ作業を行う。基準照明、暗い照明、カメラ移動。10 の対応づけた初期状態それぞれで三条件を走らせる。NVIDIA L40S / CUDA 推論で記録 | README には、これは制御された診断であり、公式の LIBERO ベンチマークスコアではないと書かれている。作業は一つだけ | O(プロジェクト自身の説明) |
| 160 動作 / 8 秒 | 同上 | 1 回ごとの固定予算 | 予算を増やしたときの作業の進み具合と成功率。README は別途評価が必要としている | O |
| 差し引き +2 = 3 回改善、1 回悪化 | 同上 | カメラ移動条件の対応づけた結果 | README は、この単一の作業では一般的な頑健性や因果関係は確立できないとしている | O |
| 14 回の失敗、アームの先はなお 44.8–138.6 mm 移動 | 同上 | 失敗はすべて動作の上限に到達。各回の最後の 10 分の 1 の区間で、先端の移動量はすべて 1 mm の停滞線を上回る | 打ち切りの時点で動いていたことを示すだけで、作業の進み具合は示さない | O |
| そのまま再実行、30 / 30 一致 | 同上 | 同じ L40S で計画全体を 1 回再実行 | README は、一般的な決定性は確立せず、それだけで因果を帰属することもできないとしている | O |
| 10 回を 5 回ずつ二組に分ける | Henderson ら | 同じハイパーパラメータで乱数シードだけを変える。論文が扱うのは MuJoCo の連続制御タスクでの方策勾配法 | 論文は、推奨できる具体的な回数は示せないとしている | R(著者の報告) |
この表を読むときは、三つの点に注意してください。
- 二つの資料が扱うランダム性は種類が違います。robot-reel が評価しているのは、学習済みの方策(SmolVLA)を固定予算でテストした結果です。Henderson らが論じているのは強化学習の学習そのもののランダム性で、論文は環境の確率性と、学習過程の乱数生成器による確率性(たとえば重みの初期化)を挙げています。動画の第 3 章は両者を「一回の結果では決まらない」として一緒に扱っていますが、論文のばらつきを robot-reel の成功率にそのまま当てはめることはできません。
- robot-reel の数字は、すべて一つの作業、一つのシミュレーションから来ています。README には、Hugging Face 上の 30 行の試行記録と 20 行の対応記録は、この試験的な実験の表形式の証拠であり、学習用データセットでも公式ベンチマークでもないとも書かれています。
- README は更新されます。main ブランチ上のファイルで、固定されたコミットではありません。この回が拠っているのは 2026-10-10 に取得した版です。
ログインすると、このレッスンの続きと確認問題、解答を読めます。
制約と注意点
- robot-reel の README の数字は O レベルのプロジェクト自身の説明で、本講座と同じ組織である NoteFlowAI が公開しています。本サイトでは独立に再現していません。この回で読んだのは 2026-10-10 に取得した main ブランチの README で、そこからリンクされた docs/stress.md などのファイルは読んでおらず、ラボのページや Hugging Face のデータセットも開いていません。README には、これは制御された診断であり、公式の LIBERO ベンチマークスコアではないと書かれています。作業は一つで、シミュレーションで実行し、NVIDIA L40S で推論しています。
- 基準照明 5 回、暗い照明 4 回、カメラ移動 7 回という成功回数は、README の三つの記録からこの回が計算したものです。「失った」「得た」は基準照明に対するものとして読んでおり、引用した README の文は比較の相手を文字どおりには書いていません。README はラボのページで条件ごとの信頼区間を示すと述べていますが、引用した文には値も方法もなく、この回では計算していません。
- Deep Reinforcement Learning that Matters(arXiv 1709.06560v1、2017-09-19)は R レベルのプレプリントで、実験は OpenAI Gym の MuJoCo 環境での方策勾配法(TRPO、DDPG、PPO、ACKTR)です。表 3 の数字は著者の報告です。この回が拠っているのは本文の図 5 の説明の冒頭までの抜粋で、補足資料は含みません。論文が論じているのは学習のランダム性であり、学習済みの方策のストレステストでの成功率ではありません。
- 符号検定の組み合わせの数、「不一致の組が少なくとも 6 つ」、「44.8 mm は 5 mm を上回るのでラベルは変わらない」、区間の幅などは、この回の計算と説明です。本サイトは README のコマンドを一つも実行していません。
git cloneは main ブランチを取得し、コミットに固定されていません。README の PyPI のインストール手順は robot-reel==0.19.1 に固定していますが、--paired-exactに必要なのは 0.17.1 以降です。 - 第 5 節の方策 P と Q、条件 R と N、シード 01〜12、f1〜f10、200 動作と 300 動作、手法 M、ベースライン N、チーム T、すべての収益、バッチ、文は練習用の架空の設定です。計算した 58.3%、0.03125、0.0625、2040、1654、1847、2390、68.3% などは、これらの仮定のもとでだけ成り立ちます。「使える/書き直しが必要/代表としては使えない」の分け方と実験の取り決めは教材としての提案で、どの資料の結論でもありません。シミュレーションでの評価も紙の上の計算も、ハードウェアの安全性の検証ではありません。
- この記事では、動画のインタラクティブページの実装は確認していません。
リンク
- フィジカルAIラボ:すべての数字を確認できるフィジカルAI講座(講座の概要)
- フィジカルAIラボ 1.7:強化学習――1 回分の収益を手で計算して報酬の抜け道を見つけ、論文の地形カリキュラムとタイムアウト時のリセットを読む
- Robot Reel:ロボットの方策シミュレーションを、コマ単位で検証できる再生と 3D シーンに
- フロンティア・レーダー|Beyond Binary Success:実機試行が限られるなか、逐次検定で方策の優劣を早く見分ける
- フロンティア・レーダー|Is Success All You Need?:成功率が同程度の 2 つの VLA でも、成功軌道は大きく違いうる
- robot-reel README(SmolVLA ストレスラボ、main ブランチ、2026-10-10 取得)
- Deep Reinforcement Learning that Matters(arXiv 1709.06560v1)