
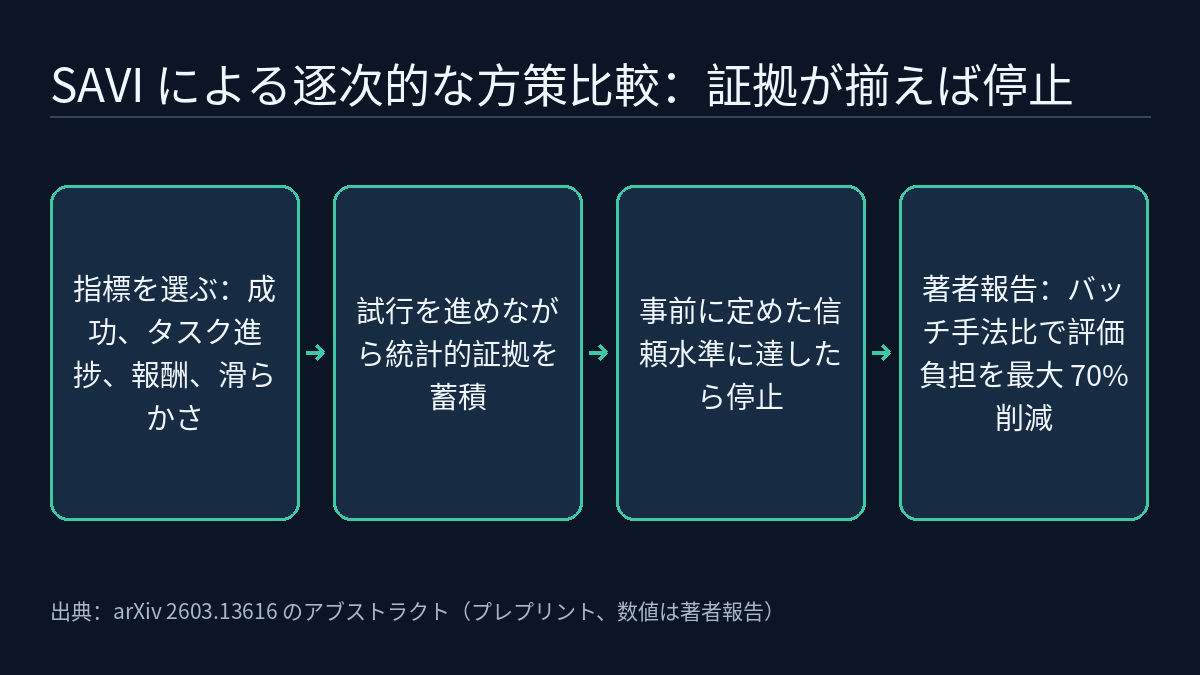
ロボット操作の方策 2 つを実機で比較するとき、いちばんコストがかかるのは試行(rollout)そのものです。回せる回数はわずかなのに、その結果でモデルが進歩したかどうかを判断しなければなりません。トヨタ・リサーチ・インスティテュート(TRI)の研究ページに掲載された論文 Beyond Binary Success(arXiv 2603.13616、v1 の投稿は 2026-03-13、エビデンス区分 [R])は、safe, anytime-valid inference(SAVI)にもとづく逐次的な比較手法を提案しています。評価は試行を重ねながら進み、統計的証拠が十分になった時点で、事前に定めた信頼水準を保ったまま早期に打ち切れます。対象は二値の成功率に限らず、タスク進捗、エピソード報酬、軌道の滑らかさといった指標にも及びます。
解決したい問題:実機の試行が少なすぎる
アブストラクトの出発点は次のとおりです。汎用のロボット操作方策は能力を高めつつあるものの、評価は依然として少数の実機試行に頼るしかありません。著者らは、この資源制約が 2 つのことを同時に求めると述べています。より情報量の多い性能指標と、信頼でき効率のよい評価手順です。両方がそろって初めて、モデルの能力を適切に評価し、分野の進歩を測れるという立場です。
この論文は 2 つの要求を 1 つの枠組みで扱います。同じ検定手順で試行回数を節約しつつ、「成功/失敗」より細かい指標も扱えるようにするというものです。アブストラクトはこの枠組みを、サンプル効率が高く、統計的に厳密で、実務で使われる幅広い評価指標に適用できると説明しています。
手法:証拠が十分になったら止める逐次検定
アブストラクトは新手法を既存の 2 種類のやり方と比べています。1 つは「標準的なバッチ手法」(standard batch methods)で、逐次手法とは対照的に、評価回数をあらかじめ決めてすべて実行してから検定するやり方です。もう 1 つは、これまで二値の成功率向けに設計されてきた逐次手法です。SAVI による手順はそれ自体が逐次的で、評価者は決まった回数を回し切る必要がなく、蓄積した統計的証拠が事前に定めた信頼水準で判断を下すのに十分になった時点で止められます。
アブストラクトには、具体的な検定統計量、停止規則、使用した信頼水準の値は書かれていません。自分の評価パイプラインで使うには論文本文を読む必要があります(arXiv ページの記載は 12 + 9 ページ、図 2 + 5 点)。
成功/失敗だけではない:対象となる指標
著者らは、先行研究が二値の成功を前提に開発されてきたのに対し、自分たちの統一的な手法はより広い範囲の指標を扱い、パラメトリックとノンパラメトリックの両方の比較問題をカバーすると強調しています。アブストラクトに挙げられている例は次のとおりです。
| 値の種類 | アブストラクト中の例 |
|---|---|
| 二値 | 成功 / 失敗(従来の逐次手法の対象範囲) |
| 離散 | 部分点を与えるタスク進捗(partial credit task progress) |
| 連続 | エピソード報酬、軌道の滑らかさ |
すでにタスクの段階や報酬を記録しているチームにとっては、比較の検定を行う前にそうした記録を 1 つの成功率に圧縮しなくてよいということになります。
著者が報告している結果
著者らはシミュレーションと実機の評価データで検証を行い、次の結果を報告しています。いずれも論文のアブストラクトによるものです。
- 標準的なバッチ手法と比べて、評価負担を最大 70% 削減。
- 二値の結果向けに設計された最新の逐次手法と比べて、評価負担を最大 50% 削減。
- これらの削減は「統計的厳密さを損なわずに」達成された。
- 競合する方策どうしは、二値の成功指標よりも細かいタスク進捗を使ったほうが早く見分けられた。
評価設計の観点で最も参考になるのは最後の点です。二値の成功率は「どこまでできたか」という情報を捨ててしまいます。著者らの結果は、サンプルが少ないときにその情報を残しておけば、比較がより早く結論に達することを示しています。本サイトの以前の記事「フロンティア・レーダー特集|シミュレーションと評価:VLA の評価に初期状態成功率以外で欠けているもの」でもこの論文を取り上げており、本記事はそれを単独で掘り下げたものです。
制約と注意点
- これは arXiv のプレプリント(分類 cs.RO、クロスリスト stat.AP)で、arXiv ページには掲載先の会議や論文誌の記載がありません。上記の数値はすべて著者による報告で、本記事が依拠する資料には独立した再現はありません。
- 70% と 50% はいずれも「最大」、つまり最もよい場合の削減幅です。アブストラクトは平均的な削減幅を示しておらず、どのタスク、どの方策、何回の試行という条件で得られたかも述べていません。
- 「統計的に厳密」であることは論文自身の仮定のもとで成り立ちますが、アブストラクトはその仮定を挙げていません。使う前に、自分のデータがそれを満たすか確認してください。
- タスク進捗の段階は人が定義する必要があり、定義が異なる場合に結論どうしを比較できるかどうかは、アブストラクトでは論じられていません。
- 本記事が依拠する資料にはコードリポジトリへのリンクがなく、実装をそのまま再利用できるかはまだわかりません。
リンク
- TRI 研究ページ:Beyond Binary Success
- arXiv 2603.13616:Beyond Binary Success: Sample-Efficient and Statistically Rigorous Robot Policy Comparison(著者:David Snyder、Apurva Badithela、Nikolai Matni、George Pappas、Anirudha Majumdar、Masha Itkina、Haruki Nishimura)
- DOI 10.48550/arXiv.2603.13616


