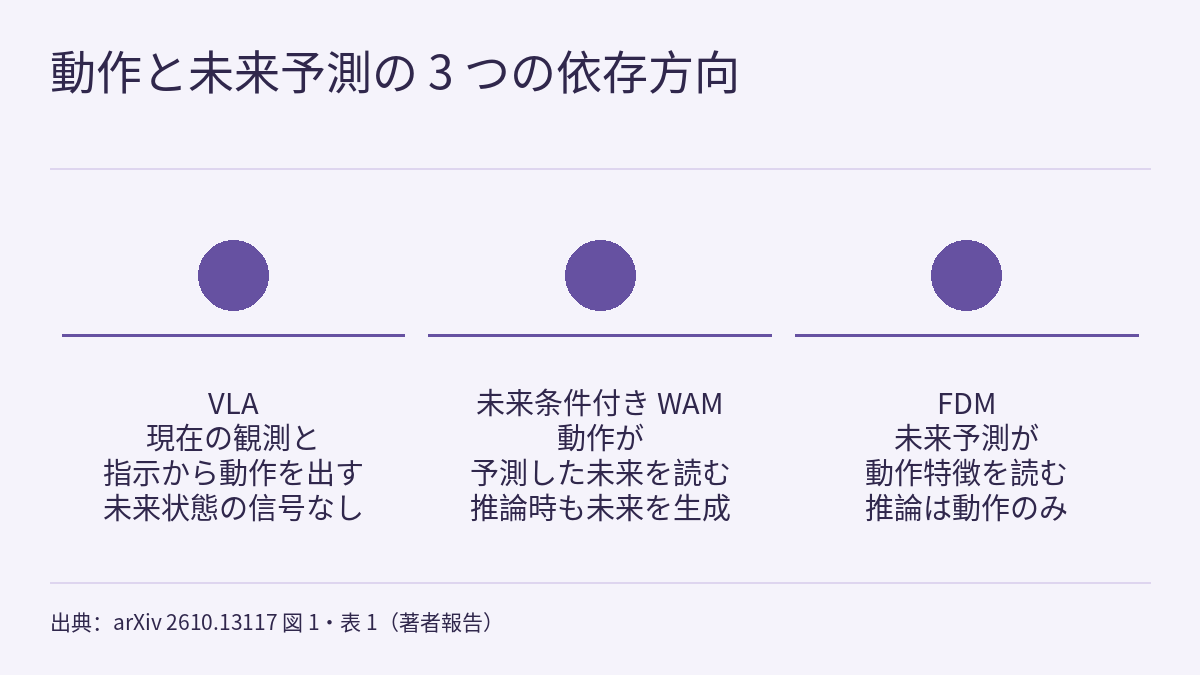
復旦大学データサイエンス学院などに所属する著者によるプレプリント Forward Dynamics Models(FDM、arXiv 2610.13117、2026-10-09)は、ロボットの行動モデルにおける 1 つの設計上の選択を扱っています。動作の予測と未来状態の予測のあいだで、どちらがどちらを読むのかという問題です。VLA は現在の観測と指示から直接動作を出力し、学習時に「次に何が起きるか」の教師信号を受けません。よく使われる未来条件付きの世界行動モデル(WAM)は、まず未来を予測してから動作を推定するため、推論時にも未来を生成する必要があり、その予測誤差が動作に伝わります。FDM は方向を逆にします。学習時には未来予測の分岐が動作特徴を読み、未来の損失がその特徴を通して方策へ逆伝播します。動作の経路は未来の情報を一切読まないので、推論時には未来の生成を完全に省略できます。著者は、LIBERO の平均成功率 99.4%、双腕ロボット ARX-X5 の実機 5 タスクで平均 96%(π0.5 は 83%)と報告しています。以下の数値はすべて著者報告 [R] で、本サイトでは再現していません。
3 つの依存方向
論文の表 1 は、3 つのモデル族を同じ記法で比較しています。C = (O_t, L) は現在の観測とタスク指示、A は動作チャンク、V は未来の世界状態の目標です。
| モデル族 | 学習 | 推論 |
|---|---|---|
| VLA | p(A | C) | p(A | C) |
| 未来条件付き WAM | p(V | C) · p(A | C, V) | p(V | C) · p(A | C, V) |
| FDM | p(A | C) · p(V | C, A) | p(A | C) |
著者は、この分解は依存関係を概念的に示したもので、実際に機能するのは表現レベルの接続だと強調しています。未来予測の分岐が読むのは動作エキスパートの隠れ状態 H_a で、最終的に出力される数値の動作ではありません。未来の損失の H_a に対する勾配は、H_a を生み出す動作エキスパートのパラメータへ戻ります。こうして、実際の未来状態が「動作の生成に使われる内部特徴」を教師として学習させます。
実装では、どちらのインスタンスも mixture-of-transformers(MoT)で複数のエキスパートを層ごとに注意機構でつなぎ、非対称な注意マスクで誰が誰を読めるかを決めています。コンテキストはコンテキストのみ、動作はコンテキストと動作、未来生成は 3 つのグループすべてを読めます。論文は、この制限が間接的な経路にも及ぶことを特に明記しています。動作エキスパートが読めるコンテキスト特徴自体も、生成分岐のトークンに依存してはいけません。
2 つのインスタンス:VLM 版と動画生成モデル版
FDM w/ VLM。 π0.5 に、動作エキスパートと同じ構造でランダム初期化した生成エキスパートを追加します。生成エキスパートは、15 フレーム前の画像と現在の画像の Wan VAE 潜在表現に、コンテキスト特徴と動作特徴を加えて読み込み、カメラ視点ごとに 15 フレーム先の画像の潜在表現を直接回帰します。損失は MSE で、1 回のフォワードパスで行い、視覚の denoising ループはありません。コンテキスト・エキスパートは現在の画像と指示だけを処理するので、過去フレームは学習時の未来予測にのみ使われ、デプロイ時には不要です。デプロイ時には生成エキスパートとその VAE 処理を外せます。
FDM w/ VGM。 動画生成モデル Wan2.2-5B に、ランダム初期化した動作エキスパートを追加します。動画バックボーンがコンテキスト処理と未来生成の両方を担います。現在フレームの潜在表現はクリーンなまま保ち、未来の動画潜在表現にノイズを加えて flow matching で学習し、損失は未来の潜在表現だけで計算します。同じ生成エキスパートの中でも、現在観測のトークンと未来動画のトークンでは注意の権限が異なり、動作エキスパートが読めるのは前者だけです。デプロイ時は現在観測の処理を残し、各層の key/value をキャッシュします。動作の各 denoising ステップでは動作ストリームだけを更新し、未来動画のトークンは確保しません。
両インスタンスとも、総損失は動作の flow matching 損失と未来の損失の和で、重みは λ_a = λ_v = 1 です。学習には NVIDIA H100 を 8 基使い、推論は H100 1 基で行います。どちらの FDM もロボット方策の事前学習を行っていませんが、比較対象の π0、π0.5、Motus、LingBot-VA はいずれも事前学習済みです。
結果:2 つのシミュレーション・ベンチマークと実機 5 タスク
| ベンチマーク | 手法 | 平均成功率(%) | 同じグループの比較対象 |
|---|---|---|---|
| LIBERO(4 スイート) | FDM w/ VLM | 99.4 | π0 94.1、π0.5 96.9 |
| LIBERO(4 スイート) | FDM w/ VGM | 98.1 | Motus 97.7、LingBot-VA 98.5 |
| RoboTwin 2.0(50 タスク) | FDM w/ VLM | 81.20 | π0 62.16、π0.5 79.75 |
| RoboTwin 2.0(50 タスク) | FDM w/ VGM | 89.23 | Motus 87.8、LingBot-VA 92.20 |
アブストラクトの「state-of-the-art 99.4%」は VLM グループの値です。個別に見ると、FDM が最良でない箇所もあります。VGM グループでは LIBERO と RoboTwin の平均がいずれも LingBot-VA を下回り、LIBERO-Long では FDM w/ VGM が 94.2% で、Motus の 97.6%、LingBot-VA の 98.5% より低くなっています。RoboTwin の Clean 条件では FDM w/ VLM が 81.54% で、π0.5 の 82.74% を下回ります。優位はランダム化条件(80.86% 対 76.76%)によるものです。
実機実験は双腕の ARX-X5 で 5 タスクを行います。引き出しへの収納、箱詰めとふた閉め、シャトル 2 個の筒への挿入、カップ積み、ブロック積みで、手法ごと・タスクごとに 20 回試行しています。FDM w/ VLM の平均は 96% で π0.5 は 83%、FDM w/ VGM の平均は 83% で、FastWAM-Joint は 78%、DreamZero は 71% です。本サイトの読みでは、アブストラクトの「実機で最大 13% の絶対向上」は、96% 対 83% の組の 13 ポイント差と一致します。論文はこの対応を明記していません。ここでの FastWAM-Joint は著者自身が実装した未来条件付き WAM で、FDM w/ VGM と同じ構造を持ち、エキスパート間の注意の向きだけを逆にしたものです。比較対照としては明快ですが、他の論文が公開したオリジナルのモデルではありません。
アブレーション:逆伝播の経路にどれだけ価値があるか
著者は実機 5 タスクで、同じ学習シードと動作のみの推論を使って 4 つのバリアントを比較しています。
| バリアント | 未来の教師信号 | 未来分岐が H_a を読む | 未来の損失が H_a を通して逆伝播 | VLM 平均(%) | VGM 平均(%) |
|---|---|---|---|---|---|
| A. 動作のみ | なし | なし | なし | 83 | 66 |
| B. コンテキストのみの未来予測 | あり | なし | なし | 87 | 72 |
| C. stop-gradient | あり | あり | なし | 89 | 78 |
| D. 完全な FDM | あり | あり | あり | 96 | 83 |
C と D はフォワード計算がまったく同じで、違いは学習時に勾配が動作特徴のインターフェースを通るかどうかだけです。そのため、D が C を上回る 7 ポイントと 5 ポイントは、逆伝播による教師信号そのものの価値を示す証拠として著者が挙げているものです。B は A を 4 ポイントと 6 ポイント上回り、未来予測を加えた視覚的な共学習だけでも効果があることを示します。D は B をさらに 9 ポイントと 11 ポイント上回りますが、この差には前向きの読み取りと逆向きの教師信号の両方の効果が混ざっています。著者はまた、動作インターフェースを通って戻る未来の勾配と動作模倣の勾配のコサイン類似度が、おおむね正であったと報告しています。
誤差の伝播と計算コスト
著者は、FastWAM-Joint の同時 denoising の途中で、観測とノイズを加えた動作チャンクはそのままに、未来動画の潜在表現にガウスノイズを 1 回注入しました。摂動強度 α = 1.0 では、動作誤差が LIBERO で 4.44%、RoboTwin で 5.52%、実機 5 タスクで 0.22%(Box)から 1.17%(Cup)増加しました。小さな摂動では、LIBERO と Box でかえって誤差がわずかに下がっています。著者は FDM についてこの項目の測定を報告していません。動作の経路は生成された未来を一切読まないため、パラメータ、入力、サンプリングの乱数を固定すれば、未来を摂動しても動作は変わりません。図中の FDM のゼロ線は構造上の不変性で、測定値ではありません。
| 手法 | 学習ステップ時間(s) | ピークメモリ(GiB/GPU) | 推論レイテンシ(ms/チャンク) |
|---|---|---|---|
| π0.5 | 0.4436 | 67.08 | 203.77 |
| FDM w/ VLM | 0.6305(+42.14%) | 72.04 | 202.98 |
| FastWAM-Joint | 0.9754 | 66.80 | 446.55 |
| FDM w/ VGM | 0.9729(−0.26%) | 66.80 | 253.45(1.76 倍高速) |
2 つの方式では、コストがかかる場所が異なります。VLM 版は推論レイテンシが π0.5 と同等ですが、学習は 1 ステップあたり 42.1% 遅くなります。VGM 版は学習コストがほぼ変わらず、未来動画の生成を省くことで推論が FastWAM-Joint より 1.76 倍速くなります(本文では 1.8 倍と表記)。
本サイトの既存ページとの関係
フィジカルAIラボ 1.6:模倣学習では、行動クローニングと動作のチャンク化を扱いました。方策はお手本から「何を見たら何をするか」を学びます。FDM が指摘するのは、まさにこの学習に「動いた後どうなるか」の信号が欠けている点で、それを補う方法はデプロイ時の動作推論を変えません。推論は引き続き、現在の観測と指示だけから動作チャンクを denoising で生成します。
フロンティア・レーダーで以前紹介した HWAM は別の道をとっています。実行後の身体状態を動作と連結して同時に denoising し、動作チャンネルは途中まで denoising された状態チャンネルを見ることができます。FDM は、動作が未来の情報を読むことを明示的に禁じています。2 つの論文は予測対象(身体状態と、未来の画像・動画の潜在表現)、プラットフォーム、タスクが異なるため、数値は比較できません。並べて見られるのは、依存方向という設計の軸です。
実機の数値を読むときは、フィジカルAIラボ 1.8:評価の問いがそのまま使えます。手法ごと・タスクごとに 20 回、5 タスクで計 100 回です。本サイトが読んだ本文には信頼区間も学習シード間のばらつきもなく、アブレーションのバリアント間の数ポイントの差のうち、どれだけがサンプリング誤差の範囲に収まるかについて、論文は答えていません。
制約と注意点
- arXiv のプレプリントで、数値はすべて著者報告 [R] です。本サイトでは再現していません。論文にはプロジェクトページが記載されていますが、本サイトでは確認していません。
- FastWAM-Joint は著者自身の実装で、摂動分析と効率比較はこれに基づいています。他の公開済み WAM の性能を表すものではありません。
- FDM が未来の摂動に影響されないのは構造上の性質で、実験で測定したものではありません。α = 1.0 での FastWAM-Joint の動作誤差の増加は 0.22% から 5.52% の範囲で、この大きさの増加が閉ループの成功率にどれだけ影響するかは、論文では別途測定されていません。
- FDM はロボット方策の事前学習を行っておらず、ベースラインは行っています。学習の設定が異なるため、表の差をすべて依存方向に帰することはできません。
- 実機は双腕 ARX-X5 1 台・5 タスクのみで、信頼区間は報告されていません。アブレーションは平均成功率だけを比較しています。
- 本サイトが読んだテキストは付録 A.5 で途切れており、付録 C(学習のハイパーパラメータ)、付録 D(ハードウェアとタスクの詳細)、付録 E(RoboTwin のタスク別結果)を含みません。
- 論文の AI 利用声明によると、生成 AI は執筆の補助、LaTeX の整形、情報検索にのみ使われ、手法、実験、コード、データ処理、結果の解釈には使われていません。