この回の動画
ナレーションは AI 合成音声です。 動画の章・文字起こし・出典
文字起こし
文字起こし
知行の問い
ロボットにお手本を何回か見せたら、それでできるの?じゃあ、何度も見たのに、学べないことがあるのはなぜ?今回は模倣学習の話です。ロボットは、お手本からどう動作を学ぶのか。まねするだけが、なぜそう簡単ではないのか。そして、お手本はどれだけあれば足りるのか。
まねをする
まずは、いちばん素朴な考え方から。コップが左にあれば左へ手を伸ばし、グリッパーの位置が合ったら閉じる。要するに、見たものに動きを当てはめるだけです。このいちばん基本のやり方を、行動クローニングと呼びます。たくさん見れば、法則は自然に浮かび上がる。自転車に乗る練習と同じです。でも、ここには落とし穴があります。ロボットが一度ずれると、お手本にない場所に出てしまいます。そこではもっと分からないので、どんどんずれていきます。たとえば、書き写すときに一文字読み違えると、その先はどんどんおかしくなります。ロボットのずれも、こうして転がって大きくなるのです。まねの難しさは、誤りが雪だるま式にふくらむことなんだ!
二つの方法
研究者はいろいろな手を考えました。ここでは有名なものを二つ。一つ目は、動作のチャンク化。一歩ずつ動くのではなく、短いひとまとまりを一度に出します。一度に短いひとまとまりなら、ロボットは途中で気が散りにくくなります。ぶれが減り、誤りも雪だるまになりにくいのです。これがACTの考え方です。論文によると、六つの実際のタスクを学びました。調味料のカップを開ける、電池を差し込むといったタスクでは、成功率が八割から九割に達しました。お手本は、たった十分間です。二つ目の方法は、頭脳を取り替えること。拡散モデルを方策として使います。得意なのは、同じ場面に正しいやり方がいくつもある状況です。たとえば障害物をよけるとき、左から回っても右から回っても正解です。昔の方法は平均をとって、真ん中で止まってぶつかります。拡散方策なら、それぞれを学べます。これを拡散方策といいます。論文によると、十二のタスクで、従来の最良の手法とくらべて、平均で四十七パーセント近く良くなりました。二つの方法は道筋こそ違いますが、根っこはどちらも模倣です。考えているのは同じこと。どうやって誤りを抑え込むか、です。チャンク化でも拡散でも、誤りを転がさないための工夫なんだ!
どれだけ必要か
もう一つ、現実的な問題があります。お手本はいくつあればいいのか?直感では、多いほどいい。本当でしょうか?ある論文が、まさにこれを調べました。分かったのは、場面ごとのお手本がいったん足りれば、さらに足しても効果は小さい、ということです。本当に効くのは、多様性です。環境を変え、物を変える。そのほうが、数をただ積むより強い。同じ論文によると、多様なデータをじゅうぶん集めたあと、成功率は約九割でした。二つのタスクを、新しい環境と見たことのない物で試した結果です。これを曲線にすると、はじめは急に伸び、やがて平らになります。曲線全体を押し上げるカギは、多様性なのです。だからデータを集めるときは、ひたすら集め続けるだけではいけません。一度立ち止まって、自分に聞いてみましょう。いろいろな状況を、網羅できているか?量より、網羅しているかどうかが大事なんだ!画面で試してみましょう。お手本の本数を動かし、次に場面の多様性を動かします。成功率が曲線にそって、どう上がっていくかを見てください。お手本が少ないと、方策は途中でずれてしまい、琥珀色で示されます。お手本がじゅうぶん多く多様なら、しっかりやり遂げて、緑色になります。ただし、注意が必要です。こうした成功率は、どれもテストで測ったもの。見たことのない場面に変えると、また下がるかもしれません。本当に学べたと言えるのは、どんなときか?見たことのない状況をじゅうぶんな数そろえて、試す必要があります。これは評価の学問で、あとで改めて取り上げます。結局、模倣が学ぶのは、まねをすること。お手本にない状況に出会うと、戸惑いやすいのです。そんなときは、自分で試させる必要があります。ふりかえりです。ポイントは三つ。一つ、模倣学習はお手本の通りにやること。でも誤りは雪だるま式にふくらむ。二つ、動作のチャンク化と拡散方策で、より安定する。三つ、お手本は多いほどいいわけではない。多様さのほうが大事。何度見ても学べないのは、お手本の多様さが足りないか、誤りが雪だるまになったせいかも!まねしかできないと、見たことのないものにはどうする?自分で試行錯誤させるんだ。また次回!
根拠と出典
練習とセルフチェック
小テストは公開で、回答するとすぐ解説が出ます。読み物の練習問題の答えはログイン会員向けです。
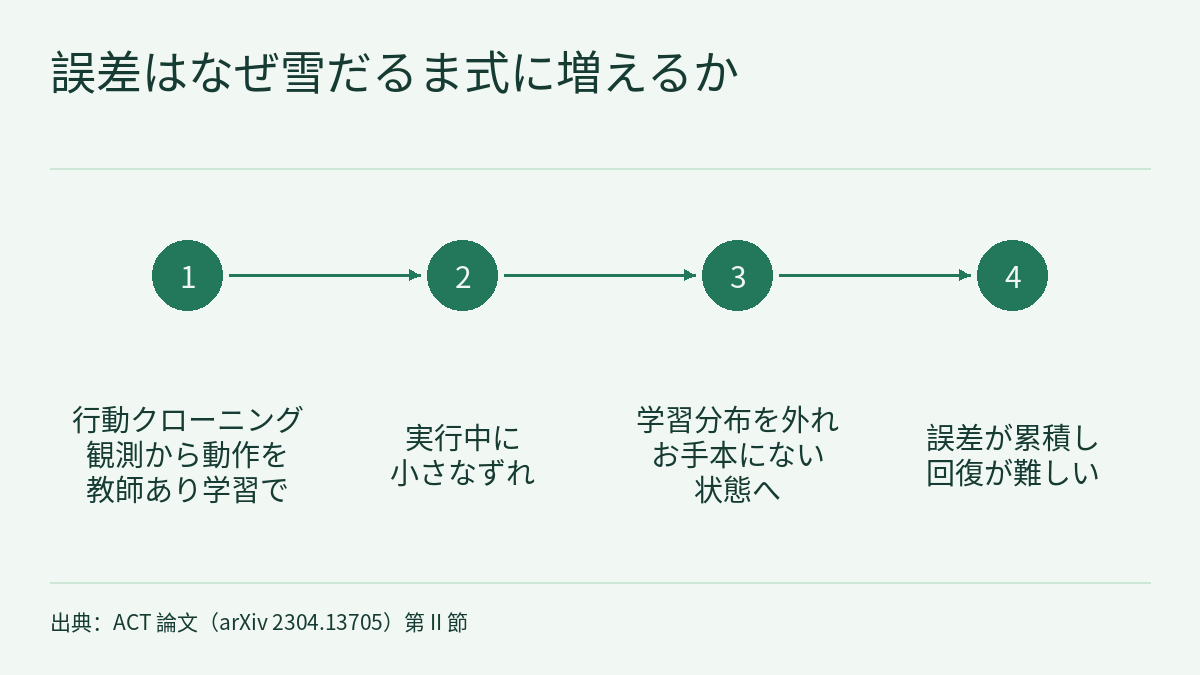
第 1.6 回の動画は模倣学習を取り上げます。いちばん素朴なやり方は行動クローニングで、「何を見たら、何をするか」をお手本どおりに学びます。難しいのは、ロボットが一度ずれるとお手本にない状態に入り、誤りが雪だるま式にふくらむことです。動作のチャンク化(ACT)と拡散方策(Diffusion Policy)は、その対策として有名な二つの方法です。そして、お手本は多いほどいいわけではなく、多様性のほうが大事です。動画が引く証拠は三つです。ACT の論文によると、約 10 分のお手本で、調味料のカップを開ける、電池を差し込むといった実際のタスクの成功率が 80〜90% でした。Diffusion Policy の論文によると、12 のタスクで従来の最良の手法より平均 46.9% 向上しました。データのスケーリング則の論文によると、多様なデータをじゅうぶん集めたあと、二つのタスクで、新しい環境・見たことのない物での成功率が約 90% でした。このページはこの回の解説と練習です。文字起こしを繰り返すのではなく、まず三つの数字をそれぞれの論文の実験条件に照らして読み直します。次に架空の数値を使い、三つのことを手で計算します。誤差がお手本のカバー範囲からどうはみ出していくか、チャンク化で「決める」回数がどう変わるか、障害物をよける二つの正しいやり方がなぜ平均されて衝突になるか、です。最後に「お手本はいくつ必要か」を、環境の数、物体の数、組み合わせごとのお手本の本数という三つの数に分けて考えます。全体を通じたルールは一つです。成功率は、それを出した論文、タスクの組、評価の中でだけ成り立ちます。
この回の動画、文字起こし、出典はこのページの上部にあり、シーズン全体の構成は講座の概要にあります。前回のフィジカルAIラボ 1.5:データはどこから来る?――SO-101 のメタデータからお手本の長さを求め、三つの入手ルートの単位と動作空間を見分けるは、データがそろったら、ロボットはお手本から実際にどう動作を学ぶのか、という問いで終わりました。今回はその続きです。1.5 の第 4 節では、架空の合成計画を使って「何本生成したか」と「何通りの状況をカバーしたか」の違いを扱いました。ここではそれを繰り返さず、実環境で環境の数、物体の数、お手本の数を体系的に変えた論文が、何を言い、何を言っていないかを見ます。
公開小テストの 5 問には詳しい解説が付いています。ログインすると、三つの練習に取り組めます。架空のずれのログを手で計算し、お手本のカバー範囲を外れる一歩を見つけ、チャンク化と時間アンサンブルでの問い合わせ回数を確かめる。左右に障害物をよける架空のお手本がなぜ平均されて衝突になるかを計算し、二つの修正案を審査する。架空のお手本収集計画とその評価についての主張を審査する。いずれも段階的な解答例、よくある誤り、20 点満点の採点基準付きです。
1. 三つの証拠と、それぞれの条件
三つの数字は三本の arXiv 論文によるもので、いずれも著者の報告(R レベル)です。動画に出てくる順に並べます。
| 動画での言い方 | 出典 | 原文の条件 | 原文が言っていないこと | レベル |
|---|---|---|---|---|
| 約 10 分のお手本で、調味料のカップを開ける、電池を差し込むといった実タスクの成功率 80〜90% | Zhao、Kumar、Levine、Finn、Learning Fine-Grained Bimanual Manipulation with Low-Cost Hardware(ACT / ALOHA、arXiv 2304.13705、2023-04-23) | 実世界の精密操作タスク 6 つ。80〜90% は例として挙げた半透明の調味料カップを開ける、電池を差し込むといったタスクに付いている。序論では「10 minutes or 50 demonstration trajectories」と書く。双腕の遠隔操作システム ALOHA で、遠隔操作もデータ記録も 50 Hz | 引用した文は、6 つのタスクがどれも 80〜90% に届いたとは言っていない。10 分がタスクごとか合計かは、引用した文章には書かれていない | R(著者の報告) |
| 12 のタスクで、従来の最良の手法より平均で 47% 近く向上 | Diffusion Policy(arXiv 2303.04137、2023-03-07) | 4 つのロボット操作ベンチマークの 12 タスクで、当時の最良のロボット学習手法と比べ、平均 46.9% 向上 | 要旨は、46.9% が相対的な向上かパーセントポイントかを示しておらず、12 タスクのどれがシミュレーションでどれが実機かも挙げていない | R(著者の報告) |
| 多様なデータをじゅうぶん集めたあと、二つのタスクで新しい環境・見たことのない物での成功率約 90% | Lin、Hu ほか、Data Scaling Laws in Imitation Learning for Robotic Manipulation(arXiv 2410.18647、2024-10-24) | データ収集者 4 人が午後の半日で収集。序論によると二つのタスクは Fold Towels と Unplug Charger で、それぞれ 8 つの新しい環境と物体でテスト。方策は Diffusion Policy | すべてのタスクの結果ではない。法則をまとめるのに使った別の二つのタスク(Pour Water、Mouse Arrangement)は別の実験 | R(著者の報告) |
三本の論文の対応する原文は次のとおりで、それぞれ独立に抜き出しています。
ACT allows the robot to learn 6 difficult tasks in the real world, such as opening a translucent condiment cup and slotting a battery with 80-90% success, with only 10 minutes worth of demonstrations.
The synergy between these two parts allows learning of 6 fine manipulation skills directly in the real-world, such as opening a translucent condiment cup and slotting a battery with 80-90% success, from only 10 minutes or 50 demonstration trajectories.
We benchmark Diffusion Policy across 12 different tasks from 4 different robot manipulation benchmarks and find that it consistently outperforms existing state-of-the-art robot learning methods with an average improvement of 46.9%.
With four data collectors working for one afternoon, we collect sufficient data to enable the policies for two tasks to achieve approximately 90% success rates in novel environments with unseen objects.
最初の二文はどちらも ACT の論文からで、一文目は要旨、二文目は序論です。読むときの注意点は三つです。
- 三つのパーセントは同じ種類の量ではありません。80〜90% は例として挙げた実タスクの成功率、46.9% は「従来の最良の手法」に対する平均の向上、約 90% は二つのタスクの新しい環境・新しい物での成功率です。タスクも比較対象も評価も違うので、大小を比べることも、どの手法が「より良い」と言うこともできません。
- 「10 分」と「50 本」は同じ文の中の二つの数え方です。この二つが一つのタスクの同じお手本の集まりを指すとすると(引用した文章ははっきりそうとは書いていません)、1 本あたり平均約 600 ÷ 50 = 12 秒、50 Hz の記録で約 12 × 50 = 600 タイムステップです。これはこの回の計算で、第 2 節で使います。
- 二つの方法は、のちに組み合わされました。データのスケーリング則の論文は Diffusion Policy でデータをモデル化し、さらに ACT が提案した時間アンサンブル(temporal ensemble)で動作を滑らかにしています。動画は、二つの方法は道筋こそ違っても根っこはどちらも模倣だと言います。この論文でも、二つはどちらか一方を選ぶものではありません。
ログインすると、このレッスンの続きと確認問題、解答を読めます。
制約と注意点
- ACT / ALOHA(arXiv 2304.13705、2023-04-23)、Diffusion Policy(arXiv 2303.04137、2023-03-07)、Data Scaling Laws in Imitation Learning(arXiv 2410.18647、2024-10-24)の数字はいずれも著者の報告で、R レベルです。本サイトはどれも独自に再現していません。
- この回の解説が依拠したのは、Diffusion Policy の要旨、ACT の論文の要旨と本文の冒頭の節(抜粋は第 IV 節の学習手順のところで途切れています)、データのスケーリング則の論文の要旨と本文の冒頭の節(抜粋は満点を述べる文の途中で途切れています)で、補足資料は含みません。ACT が実際に使う k、時間アンサンブルの重み、タスクごとの成功率、データのスケーリング則の論文がスコアを成功率に換算する方法は、これらの文章にはありません。
- 第 1 節の 12 秒と 600 ステップは、「10 分」と「50 本」が一つのタスクの同じお手本の集まりを指すと仮定したもので、原文ははっきりそうとは書いていません。第 4 節の 1,600 本は、著者の例をもとにこの回でかけ算したものです。いずれもこの回の計算で、出典が直接書いている数ではありません。
- 第 2〜4 節のカバー範囲、ずれの更新規則、押される大きさ、k = 50、四つの関節の予測、障害物の寸法、左右の割合、4 × 4 × 100 の計画、そして第 5 節の R6、お手本の集まり D、修正案 A と B、チーム D、P1〜P3、C1〜C5 とすべての得点は、練習用の架空の設定です。求めた 0.8 cm、0.75 cm、ステップ 43、0.15 秒、−2.4 cm、79%、0.75、0.78 などは、これらの仮定のもとでだけ成り立ちます。ずれのモデルは教材用の簡略化で、実在の方策のダイナミクスを表すものではありません。
- 「すべてのステップが満点なら完了」、要因ごとにテスト環境を取り分けること、ヒストグラムによる確認は教材としての提案で、どの出典の定義や結論でもありません。紙の上の計算、ブラウザの実験ページ、シミュレーションは、いずれもハードウェアの安全検証ではありません。
- 動画の実験ページの曲線はイメージ図と明記されています。本ページは実験ページの実装を確認していません。
リンク
- フィジカルAIラボ:すべての数字を確認できるフィジカルAI講座(講座の概要)
- フィジカルAIラボ 1.5:データはどこから来る?――SO-101 のメタデータからお手本の長さを求め、三つの入手ルートの単位と動作空間を見分ける
- Learning Fine-Grained Bimanual Manipulation with Low-Cost Hardware(ACT / ALOHA、arXiv 2304.13705)
- Diffusion Policy(arXiv 2303.04137)
- Data Scaling Laws in Imitation Learning for Robotic Manipulation(arXiv 2410.18647)