
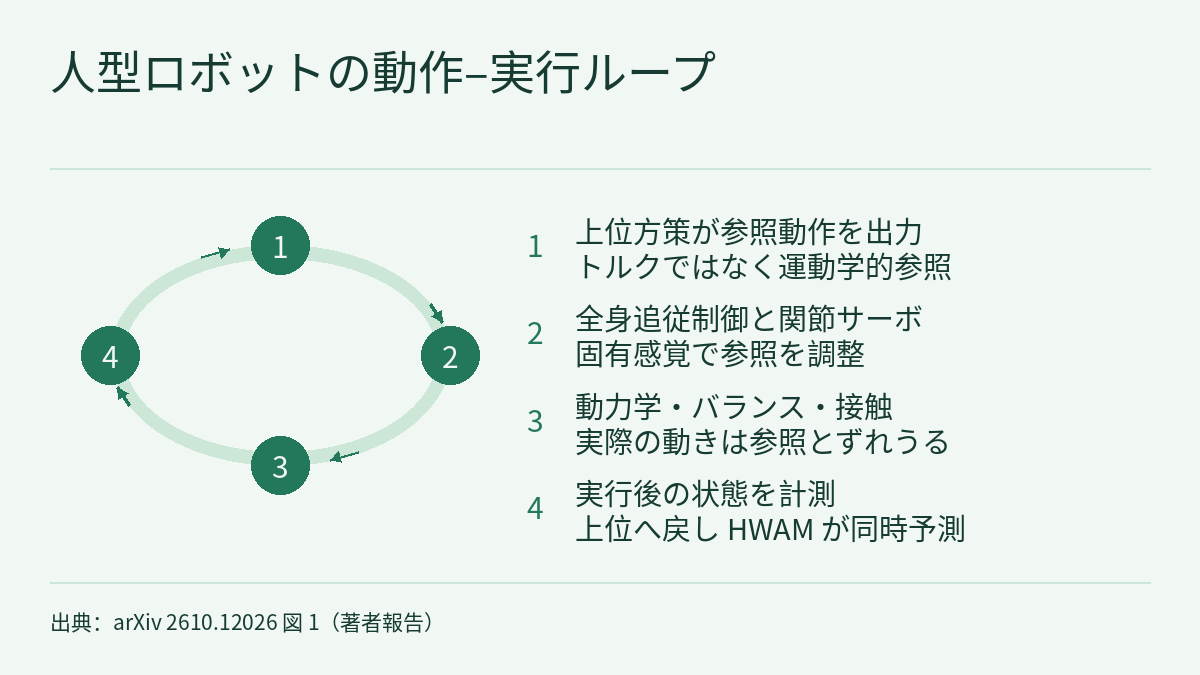
階層型の人型ロボットシステムでは、VLA や世界行動モデル(WAM)が出力するのは下位の全身制御器に渡す参照動作で、ロボットが実際に行う動きはさらに追従制御、動力学、バランス、接触を経るため、両者は一致しないことがあります。LimX Dynamics のチームによるプレプリント HWAM(arXiv 2610.12026、2026-10-08)はこの差を「動作–実行ギャップ」と呼び、参照動作と同時に、実行後に計測される固有感覚状態もモデルに生成させ、順動力学・逆動力学の 2 つの動画経路でこの同時軌道と画像の変化を結び付けます。著者報告では、LimX OLI 人型ロボットの実機 3 タスクすべてで HWAM の成功率が比較手法の中で最も高く、Candy Picking では 70.6%、Fast-WAM は 43.3% でした。以下の数値はすべて著者報告 [R] で、本サイトでは再現していません。
動作–実行ギャップ:上位が出すのは参照であって、実際の動きではない
論文が採用する階層型インターフェースでは、上位の視覚–言語–行動方策が画像、言語指示、現在の固有感覚状態から運動学空間の参照軌道を生成し、下位の全身追従制御器がリアルタイムの固有感覚フィードバックでそれを実行時の動力学に合わせて調整し、関節サーボでロボットを駆動します。したがって論文中の動作 a_t は下位の追従制御器に渡す運動の参照であり、アクチュエータに直接かけるトルクではなく、一点ずつ実現できるとも仮定されていません。著者の例では、参照軌道が胴体の移動と腕の伸展を同時に求めたとき、下位制御器がバランスを保つために胴体を調整すると、接触時の手の軌道も変わります。
著者によれば、実際に到達した身体状態を明示的にモデル化しないと、将来画像の予測は、シーンがどう変わるかと、参照動作と実際の動きがどれだけずれたかという 2 つのことを同時に説明しなければならず、動作とその物理的な結果を対応付けにくくなります。ギャップが実在することを示すため、論文は記録データ中の各関節参照 a_t と、それに対応する実行後の固有感覚状態 s_{t+1} の平均絶対誤差(MAE)を比べています。
| プラットフォーム | 直接 MAE(°) | 定常状態 MAE(°) |
|---|---|---|
| LimX OLI(移動型人型ロボット) | 4.420 | 2.885 |
| ALOHA(据え置き型双腕) | 0.648 | 0.402 |
「定常状態」は、関節参照がほぼ一定のときの同じ組み合わせです。どちらのプラットフォームでも誤差はゼロではなく、移動型人型ロボットのほうがギャップは大きくなっています。著者はこれを、正確な追従を仮定せず実行後の状態をモデル化する動機としています。論文によれば完全な測定手順と関節ごとの統計は付録 A にありますが、本サイトが確認した arXiv の HTML 版には上表の集計値しか示されていません。
手法:実行後の状態を生成対象に入れ、3 つの経路で画像と結び付ける
状態と動作の同時ターゲット
H ステップの予測区間について、HWAM は動作チャンク [a_t, …, a_{t+H-1}] と状態チャンク [s_{t+1}, …, s_{t+H}] を特徴次元方向に連結し、各時刻位置を [s_{t+h+1}; a_{t+h}] とします。状態と動作のチャネルはトークン射影の前に連結され、1 つの状態–動作生成器が共通のノイズレベルでまとめてデノイズします。著者の説明では、これによりデノイズの各ステップで動作チャネルが部分的にデノイズされた状態チャネルを参照でき、状態の教師信号が動作生成に使う表現にも影響します。一方で論文は、この構成は下位の動力学モデルを明示的に学習するものではなく、別個の物理的整合性の制約も課さないこと、また同時ターゲット単体で有効だとは仮定せず、次に述べる視覚経路で接地させることを明記しています。
2 つのエキスパートと 3 つの学習経路
モデルは動画エキスパート(WanVideoDiT)と状態–動作エキスパート(ActionDiT)からなり、パラメータは別々で、経路ごとに変わるマスク付きクロスアテンションで情報をやり取りします。これは Fast-WAM など先行 WAM の混合エキスパート型インターフェースを踏襲したものです。多視点の画像は凍結した因果的 Wan2.2 VAE で現在と将来の視覚潜在表現に符号化され、言語は UMT5-XXL で埋め込まれ、現在の固有感覚状態とともに両エキスパート共通の条件になります。3 つの経路はエキスパートとパラメータを共有し、生成対象と見える条件だけが異なります。
| 経路 | 見える条件 | 生成対象 |
|---|---|---|
| Policy | 現在の画像、言語、現在の固有感覚状態 | 状態–動作軌道。将来動画は生成せず、デプロイ時の条件と一致 |
| 順動力学(FDM) | 現在の画像、状態–動作軌道、条件 | 将来動画 |
| 逆動力学(IDM) | 現在と将来の画像、条件 | 状態–動作軌道 |
2 つの生成モダリティはいずれも条件付き flow matching で学習し、状態と動作の誤差は追加の重みなしで平均します。ミニバッチごとに経路を 1 つ一様に選びます(各 1/3、重みはすべて 1)。FDM は指令だけでなく実際に到達した状態を条件に画像を予測し、IDM は逆に、画像の変化から動作とそれが生む身体状態を推定します。デプロイ時も予測された状態は同時デノイズに加わりますが、下位制御器に送られるのは動作だけです。
実機結果:LimX OLI での 3 タスク
LimX OLI は 31 自由度の全身動作空間(7 自由度の腕 2 本を含む)を持つ等身大の人型ロボットで、BrainCo の多指ハンドを備えます。方策の入力は頭部と手首のカメラの RGB 画像、言語指示、現在の固有感覚状態です。3 タスクのうち、Candy Picking(指示された色のキャンディを取り、割り当てられたトレイ領域に置く)と Object Collection(机上の 4 つの物体をすべてバスケットに入れる)は据え置きでの操作、Plush-Toy Picking は全身の協調を要する移動操作です。学習データはそれぞれ 1,783、4,220、404 エピソードで、Candy Picking にはオフライン診断専用のホールドアウト 422 エピソードが別にあります。両エキスパートは AdamW、学習率 10⁻⁴、グローバルバッチサイズ 128 で 6 エポック微調整され、16 基の A800 GPU を使用し、実装は FluxVLA Engine をベースにしています。
| 手法 | 追加ロボットデータでの事前学習 | Candy Picking | Object Collection | Plush-Toy Picking |
|---|---|---|---|---|
| Cosmos3-Edge | あり | 15.8 | 0.0 | 56.7 |
| GR00T N1.5 | あり | 40.5 | 42.5 | 60.0 |
| π0.5 | あり | 62.5 | 45.0 | 60.7 |
| Fast-WAM | なし | 43.3 | 0.0 | 60.0 |
| DiT4DiT | なし | 52.5 | 15.0 | — |
| HWAM | なし | 70.6 | 46.7 | 73.3 |
表は実機での成功率(%)で、「—」は論文で未報告または未検証の結果です。π0.5 との差は Candy Picking で 8.1、Object Collection で 1.7、Plush-Toy Picking で 12.6 ポイントです。Object Collection では Cosmos3-Edge と Fast-WAM がタスクに必要なバスケットの把持を確立できず、タスク全体の成功率が 0% になっています。著者は Fast-WAM を最も近い WAM ベースラインと位置付けています。Fast-WAM も動画との共学習を使い、デプロイ時には将来動画を合成しません。
試行回数と 95% Wilson 信頼区間が示されているのは Candy Picking だけです。HWAM 84/119(区間 61.9–78.0%)、π0.5 75/120(53.6–70.6%)、Fast-WAM 52/120(34.8–52.3%)、GR00T N1.5 49/121(32.2–49.4%)。著者は、これらの区間は各試行を独立なベルヌーイ試行と仮定しており、学習シード間のばらつきは測っていないと述べています。本サイトの読み方としては、HWAM と π0.5 の区間は重なっており、π0.5 の上限はちょうど HWAM の点推定に一致します。区間の重なりは有意性検定ではありませんが、この試行だけでは 8.1 ポイントの差にまだかなりの不確かさがあることを示しています。残り 2 タスクの試行回数は、本サイトが確認した arXiv の HTML 版には示されていません。
ALOHA での服たたみ
論文は ALOHA 双腕プラットフォームでも Clothes Folding を評価しています。タスク専用の学習データは 640 件のデモンストレーションで、0–100 点で採点し、完了したたたみ段階には部分点を与えます。HWAM は 86.00 点、GR00T N1.5 は 78.75、π0.5 は 77.00、Fast-WAM は 66.25、π0 は 65.00、GR00T N1.7 は 58.75、SmolVLA は 51.25 でした。著者は、これは ALOHA 上でタスク専用に学習した結果であり、OLI からのゼロショット転移ではないと明記しています。
アブレーションとオフライン診断:同時ターゲットは 3 経路の学習と組み合わせて効く
移動操作タスク Plush-Toy Picking で、著者は 2 × 2 のアブレーションを行っています。予測対象は動作のみか状態–動作の同時か、学習方法は VGM/Policy(将来動画生成と Policy 目的関数の同時最適化)か FDM/IDM/Policy かで、それ以外の設定は固定です。
| 予測対象 / 学習方法 | VGM/Policy | FDM/IDM/Policy |
|---|---|---|
| 動作のみ | 60.0 | 55.0 |
| 状態–動作の同時 | 45.5 | 73.3(HWAM) |
状態予測を加えた効果は学習方法によって逆になります。VGM/Policy では成功率が 60.0% から 45.5% に下がり、FDM/IDM/Policy では 55.0% から 73.3% に上がりました。2 つの効果の差は 32.8 ポイントです。著者はこれを、評価した設定では同時ターゲットと 3 経路の学習を組み合わせることの裏付けとしつつ、このアブレーションは組み合わせ全体の評価であり、個々の経路やアーキテクチャ上の選択の寄与を切り分けるものではないと述べています。アブレーション各構成の試行回数は、本サイトが確認した arXiv の HTML 版には示されていません。
オフライン診断は Candy Picking のホールドアウトエピソードで行い、デノイズは 4 ステップ、MAE は最初の 31 の共通関節について度単位で計算しています。32 ステップのチャンク全体で平均すると、HWAM の動作 MAE は 3.816°、動作のみの FDM/IDM/Policy は 4.024° で、著者は評価したすべての学習方法で状態の教師信号を加えると動作 MAE が下がったと報告しています。ただし、開ループ診断と閉ループのアブレーションは別のタスクで行われているため、開ループ MAE の低下から閉ループの成功率向上を直接導くことはできません。実際、VGM/Policy に状態を加えた構成は閉ループのアブレーションで悪化しています。
将来動画の予測は、ホールドアウトの 12 エピソードについて、把持が閉じる直前の時間窓で評価しています。モデル自身が予測した軌道を条件にした場合、PSNR は構成によって 20.345 から 20.844 の範囲で、HWAM は 20.501 と画質上の優位はありません。著者も、これらの数値は閉ループの成功率の差を説明しないと述べています。正解の軌道を条件にした場合は、動作と実行後の状態の両方を条件にした HWAM が 23.336、動作のみのモデルが 20.559 で、著者はこれを「実際に到達した状態を条件にすると画像上の結果を予測しやすくなる」根拠としています。
本サイトのこれまでの記事との関係
講座のフィジカルAIラボ 0.3:見る・考える・動く――3 つの周波数をそれぞれのシステムに戻すでは、ロボットの「考える」と「動く」が別の階層・別の周波数に属することを扱いました。HWAM が補うのは、その境界のもう一方の面です。上位が出した参照は下位でそのまま実行されるとは限らず、上位はそのずれを学ぶ必要があります。フィジカルAIラボ 1.6:模倣学習では動作のチャンク化を扱いました。HWAM の状態–動作チャンクは、動作チャンクの各位置に実行後の状態を並べたものです。
フロンティア・レーダーで以前取り上げたReCoは、四脚ロボットのモバイルマニピュレーションで似たインターフェースの問題を別の方法で扱っています。ReCo は歩行方策が再現性よく応答するよう学習させ、その閉ループ応答モデルを同定して MPC に渡します。HWAM は下位の動力学を同定せず、計測された実行後の状態を動作と一緒に生成する変数として扱い、予測した状態を制御器には送りません。2 本の論文はプラットフォーム、タスク、指標がいずれも異なるため、数値を比べることはできません。
制約と注意点
- arXiv のプレプリントで、数値はすべて著者報告 [R] です。著者は全員 LimX Dynamics の所属(うち 1 名は南方科技大学にも所属)です。論文は評価プラットフォームを LimX OLI 人型ロボットと呼んでいます。本サイトではいずれの結果も再現していません。論文はコード、データセット、プロジェクトページを公開したとしていますが、本サイトでは確認していません。
- 試行回数と信頼区間が示されているのは Candy Picking だけで、その区間も試行のサンプリングだけを反映し、学習シード間のばらつきは反映しません。Object Collection での π0.5 との差は 1.7 ポイントにとどまり、本サイトが確認した arXiv の HTML 版にはこのタスクの試行回数が示されていません。
- アブレーションは 1 タスクのみで、組み合わせ全体を比べているだけなので、FDM、IDM、Policy それぞれの寄与は切り分けられません。
- HWAM は下位の動力学を明示的に同定せず、予測した状態は制御器に送られません。画像予測の品質でも優位はありません。
- Candy Picking の動作方向別・作業領域別の内訳はタスク内の内訳で、空間的にホールドアウトした分割での評価ではありません。ALOHA の結果はタスク専用の学習によるもので、プラットフォーム間のゼロショット転移ではありません。
- 論文の AI 使用に関する声明には、生成 AI ツールをコード実装、原稿の執筆・編集、投稿前の手法と実験報告へのフィードバックに使ったと書かれており、最終的な内容には著者が責任を負うとしています。
リンク
- HWAM: Humanoid World Action Model With Joint State–Action Generation(arXiv 2610.12026)
- 論文 HTML 全文
- フロンティア・レーダー|ReCo:まず歩行方策の指令応答を予測可能にし、MPC で四脚ロボットの胴体とアームを協調させる
- フィジカルAIラボ 0.3:見る・考える・動く――3 つの周波数をそれぞれのシステムに戻す
- フィジカルAIラボ 1.6:模倣学習――誤差がお手本のカバー範囲からはみ出すまでを手で計算し、ACT・拡散方策・データのスケーリング則の数字をそれぞれの条件に照らして読む
- フィジカルAIラボ:すべての数字を確認できるフィジカルAI講座(講座の概要)


