この回の動画
ナレーションは AI 合成音声です。 動画の章・文字起こし・出典
文字起こし
文字起こし
知行の問い
ロボットも、子どもが自転車に乗れるようになるみたいに、試しているうちにできるようになるの?今回は強化学習の話です。お手本は見せず、報酬だけを与えます。ロボットは試行錯誤の中で、自分で動き方を見つけていきます。
報酬と試行錯誤
前回の模倣学習は、人のお手本を見て、その通りにまねるものでした。今回は違います。お手本がありません。強化学習では、ロボットが自分で動き、環境がそれに点数をつけます。この点数を報酬と呼びます。うまく動けば加点、まちがえれば減点です。ロボットが覚えるのは、方策です。目の前の状況を見て、次にどう動けばいいかが分かる、というものです。ロボットがほしいのは、一歩ごとの点数ではありません。一回分をまるごと足した合計点です。これを収益と呼びます。難しいのはここです。一回うまくいったとき、どの一歩のおかげだったのか?ロボットは、その手柄を少しずつ見分けていく必要があります。コップに手を伸ばす例で考えましょう。コップに近いほど点が高く、しっかり持ち上げれば大きな点。ボトルを倒したら減点です。最初、方策はでたらめに動きます。ほとんどの場合、届きません。たまたまコップに近づいたときだけ、少し点がもらえます。点が高かった動きを、少しだけ起こりやすくします。しばらく練習すると、コップに届く回数が増えてきます。さらに練習すると、動きもなめらかになります。手を伸ばし、ボトルをよけて、コップを持ち上げる。ひと続きの動きです。人から習ったんじゃなくて、何度もたまたま当てて、当たった動きを覚えていったんだ!
シミュレーションで何度も試す
試行錯誤の困るところは、とにかく何度も何度も試す必要があることです。本物のロボットでは、そこまでできません。遅すぎるし、すぐ壊れます。そこで、試行錯誤の多くはシミュレーションの中で行います。壊れたら、やり直せばいい。お金もかからず、人も傷つけません。二千二十一年、ある論文が実験をしました。何千体ものロボット犬の分身を、一枚のGPUの上で同時に練習させたのです。分身はそれぞれ勝手に試します。転んだ経験も、うまくいった経験も一つにまとめて、同じ方策に与えます。論文によると、平らな地面なら四分足らずで、ロボット犬は歩けるようになりました。でこぼこの地形でも、二十分ほどです。論文によると、シミュレーションで練習した方策を、本物のロボット犬に移しました。確かめたところ、ちゃんと使えたそうです。試行錯誤には、もう一つコツがあります。まだ試していない動きも、どんどん試すこと。いちばん無難な動きばかりに頼らないことです。一回ごとの収益を、一本の曲線にしてみます。上がっていけば、強くなっている証拠。でも、ぶれることもあるし、途中で止まることもあります。
報酬を正しく書くのは難しい
強化学習には良いところがあります。お手本をまねしないので、人よりうまいやり方を見つけるかもしれません。でも、報酬を書くのは難しいのです。成功した瞬間だけ点をあげると、めったにもらえず、学ぶのがとても遅くなります。そこでよく、「近づいた」ことにも少し点をあげて、正しい方向へ導きます。これをリワードシェーピングと呼びます。シェーピングには、落とし穴もあります。報酬の書き方が少しずれるだけで、ロボットは抜け道を見つけます。たとえば、「コップが動いた」ことだけに報酬を出すと、ロボットはコップを手ではじき飛ばして、それでも高い点を取るかもしれません。だから報酬は、何度も試して、何度も直す必要があります。さらに、人がリプレイを見て、本当にできたのかを確かめなければなりません。模倣学習と比べてみましょう。模倣は覚えるのが速いけれど、先生を超えるのは難しい。強化学習はもっと強くなれるかもしれませんが、遅いし、報酬にも気をつけなければなりません。ページでスライダーを動かして、報酬曲線の上がり方を見てください。次に、ずれた報酬に切り替えて、どう抜け道を見つけるかも見てみましょう。まだ解決していないことが三つあります。報酬を正しく書くのが難しいこと。試行錯誤に、とても多くの回数がいること。そして、シミュレーションと現実の間に、まだ差があることです。ふりかえりです。ポイントは三つ。一つ、強化学習は、お手本ではなく、報酬と試行錯誤で学ぶ。二つ、試行錯誤は回数がいるので、シミュレーションで何千もの分身が一緒に練習する。三つ、報酬は正しく書くのが難しく、ずれると抜け道を突かれる。教えてもらったんじゃなくて、報酬を頼りに、ちょっとずつ自分で試して覚えたんだ!じゃあ、実際どれくらいできるの?成功の割合ひとつに、どれだけ言っていないことが隠れてる?また次回!
根拠と出典
練習とセルフチェック
小テストは公開で、回答するとすぐ解説が出ます。読み物の練習問題の答えはログイン会員向けです。
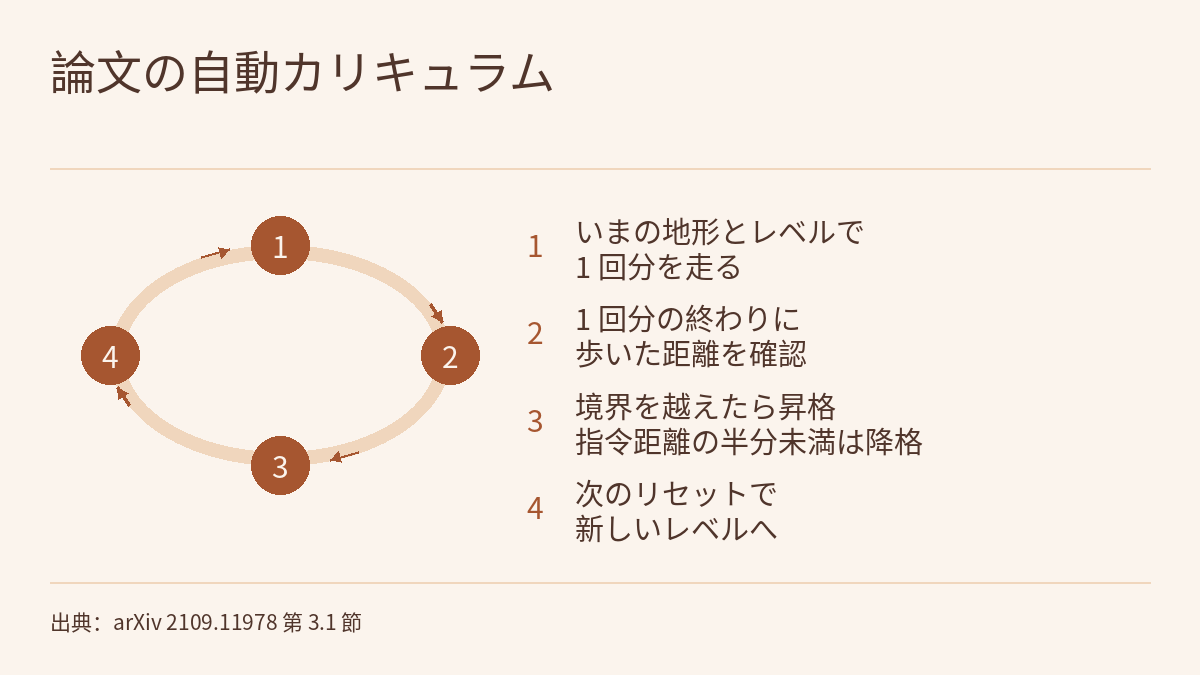
第 1.7 回の動画は強化学習を取り上げます。お手本は見せず、報酬だけを与え、ロボットは試行錯誤の中で自分で方策(目の前の状況を見て、次にどう動けばいいかが分かるもの)を見つけていきます。ほしいのは一歩ごとの点ではなく、一回分をまるごと足した収益です。試行錯誤にはとても多くの回数が必要なので、シミュレーションの中で行います。そして報酬を正しく書くのは難しく、少しずれるとロボットは抜け道を見つけます。動画で使う実際の証拠は一本の論文です。Rudin らの Learning to Walk in Minutes Using Massively Parallel Deep Reinforcement Learning(arXiv 2109.11978)によると、一枚のワークステーション用 GPU の上で何千体ものシミュレーション上のロボットを並列に学習させると、四脚ロボットの歩行方策が平地なら 4 分足らず、でこぼこの地形でも 20 分で学習できました。このページはこの回の解説と練習です。文字起こしを繰り返すのではなく、動画が踏み込まなかったことを二つ扱います。まず架空のコップを使って一回分の収益を手で計算し、「近づいた」ことに点を出すシェーピングによって、「コップのそばで待つ」ほうが「コップを持ち上げる」より高い点になってしまう様子を見ます。次に、同じ論文のうち動画が触れなかった二つの節を開き、自動の地形カリキュラムでどう難易度を方策に合わせて動かすか、そして「時間切れ」と「転倒」という二通りの終わり方をどう区別するかを見ます。全体を通じたルールは一つです。収益はそれ自身の報酬の定義のもとでだけ成り立ち、学習時間はそれ自身のハードウェア、タスク、設定のもとでだけ成り立ちます。
この回の動画、文字起こし、出典はこのページの上部にあり、シーズン全体の構成は講座の概要にあります。前回のフィジカルAIラボ 1.6:模倣学習――誤差がお手本のカバー範囲からはみ出すまでを手で計算し、ACT・拡散方策・データのスケーリング則の数字をそれぞれの条件に照らして読むは、まねしかできないロボットが見たことのない状況に出会ったらどうするのか、という問いで終わりました。今回はその続きです。同じ論文の「何千体ものロボット」「4 分足らず」とその実験条件は、フィジカルAIラボ 0.4:仮想の世界で一万回練習――シミュレーションの 3 つの数字に実験条件を戻すで一つずつ扱い、論文のバッチの式で並列の設定も一度手で計算しました。フィジカルAIラボ 1.4:シミュレータの地図――刻み幅のコストを数え、接触で軌道が分かれる点を読み、3 つの高速化の比較対象を確かめるでは、ほかの二つの高速化の数字と並べて比較対象を確かめました。ここではそれらを繰り返さず、強化学習そのものに関わる部分、つまり報酬と収益、カリキュラム、リセットだけを補います。
公開小テストの 5 問には詳しい解説が付いています。ログインすると、三つの練習に取り組めます。二つの架空の報酬で三つのリプレイの収益を計算し、抜け道を突かれている方を見つけてシェーピング項に上限を決める。論文のカリキュラム規則で架空の学習ログの昇格・降格を判定し、方策が強くなっているのに収益が下がりうる理由を説明する。タイムアウト時のリセットの三つの書き方を審査し、クリティックの学習目標を計算する。いずれも段階的な解答例、よくある誤り、20 点満点の採点基準付きです。
1. 一本の論文、二つの数字、そして動画が踏み込まなかった部分
論文の著者は Nikita Rudin、David Hoeller、Philipp Reist、Marco Hutter で、所属は ETH Zurich と NVIDIA です。arXiv への投稿日は 2021-09-24 で、R レベル(著者の報告)です。動画の二つの数字は要旨の二つの文に対応します。それぞれ別々に抜粋します。
In addition, we present a novel game-inspired curriculum that is well suited for training with thousands of simulated robots in parallel.
The parallel approach allows training policies for flat terrain in under four minutes, and in twenty minutes for uneven terrain.
一つ目の文の「何千」は動画の「何千体もの分身」と同じものですが、この文の主語は実はカリキュラムで、この回の第 3 節で詳しく見ます。二つの文を読むときは、さらに三つの点に注意してください(0.4 で扱ったハードウェアとシミュレーションの条件は繰り返しません)。
- 何を学ぶのか。論文の第 3 節がタスクを定めています。四脚ロボットが、でこぼこの地面、斜面、階段、障害物を越えながら、与えられた胴体の向きと並進速度の指令に従って歩くことです。「歩けるようになる」とは、そうした方策をシミュレーションの中で学習することを指します。シミュレーションと実機の実験の大半は ANYbotics の ANYmal C で行い、シミュレーションではほかに ANYmal B、アームを付けた ANYmal C、Unitree A1 の方策も学習しています。
- 何と比べて速いのか。要旨は、従来の研究より何桁も速いとしています。序論は従来の四脚の強化学習をいくつか挙げています。非常にでこぼこな地面に強いブラインド歩行の方策は学習 12 時間、学習と最適制御を組み合わせた知覚付き歩行は 82 時間と 88 時間、完全に学習による手法は 120 時間です。そして本論文の手法では、一枚の GPU で知覚付きの方策を 20 分足らずで学習できるとしています。これらは著者による他の研究の要約で、タスク、ハードウェア、知覚の設定がそれぞれ違うため、割り算して「何倍速い」という一つの数字にはできません。
- 実機への一歩。要旨は、最後に方策を実機に移して手法を検証したと書いています。動画はそれをもとに「確かめたところ、ちゃんと使えた」と言っています。この回が依拠した抜粋は第 3.2 節の冒頭で終わっており、実機実験の結果は含まれていません。動画のストップウォッチは 1 時間分の文字盤で描かれていて、4 分と 20 分は文字盤上の位置にすぎず、別の測定値ではありません。
ログインすると、このレッスンの続きと確認問題、解答を読めます。
制約と注意点
- Learning to Walk in Minutes(arXiv 2109.11978、2021-09-24)の学習時間、カリキュラムの規則、リセットの処理、図 3 の説明は、いずれも著者の報告で R レベルです。著者の所属は ETH Zurich と NVIDIA で、使われているシミュレーション環境 Isaac Gym は NVIDIA のものです。本サイトはどれも独自に再現していません。
- この回が依拠したのは、論文の要旨と、本文の第 3.2 節冒頭までの抜粋です。報酬の項と動作の定義、実機実験の結果、補足資料は含みません。リセットの処理が合計の報酬とクリティックの損失に与える影響は補足資料にあり、この回は読んでいません。
- 序論の 12、82、88、120 時間は、著者による他の研究の要約で、タスク、ハードウェア、知覚の設定がそれぞれ違います。この回はそれらの元の論文を確認していません。
- 第 2 節の報酬 R0、二つのリプレイ、k = 0.1 点/cm と 30 cm、第 3 節の 0.3 m/s と三つの距離、第 4 節の γ = 0.8 と 4.6、そして第 5 節の A7、リプレイ a〜c、V1、V2、4 レベルの階段、ロボット A〜F、ダッシュボードの数値、チーム W、γ = 0.9、9.0、I1〜I3、一回分の開始時刻が均等にずれているという仮定は、練習用の架空の設定です。求めた 13、16、10.8、0.476、0.333、0.167、4.68、9.1、40 バッチ、100 体などは、これらの仮定のもとでだけ成り立ち、論文やどのシステムのデータでもありません。
- 「一つの辺に向かってまっすぐ歩けば、境界まで 4 m」は、一辺 8 m のタイルと中央からの出発をもとにこの回が置いた簡略化です。論文の抜粋は、「境界を越えた」をどう判定するかも、昇格と降格の条件が同時に成り立つときの扱いも説明していません。
- シェーピング項の上限、「どれだけ近づいたか」に点を出すこと、リプレイ確認の規則、固定した地形での比較は、教材としての提案で、論文の手法や結論ではありません。紙の上の計算とシミュレーションの結果は、ハードウェアの安全検証ではありません。実機で試行錯誤をするには別の安全対策が必要で、この回では扱いません。
- 動画の第 30 段は実験ページ 1.7-rl の台本どおりの実演です。本ページは実験ページの実装を確認していません。
リンク
- フィジカルAIラボ:すべての数字を確認できるフィジカルAI講座(講座の概要)
- フィジカルAIラボ 1.6:模倣学習――誤差がお手本のカバー範囲からはみ出すまでを手で計算し、ACT・拡散方策・データのスケーリング則の数字をそれぞれの条件に照らして読む
- フィジカルAIラボ 0.4:仮想の世界で一万回練習――シミュレーションの 3 つの数字に実験条件を戻す(同じ論文の実験条件とバッチの計算)
- フィジカルAIラボ 1.4:シミュレータの地図――刻み幅のコストを数え、接触で軌道が分かれる点を読み、3 つの高速化の比較対象を確かめる
- Learning to Walk in Minutes Using Massively Parallel Deep Reinforcement Learning(arXiv 2109.11978)