身体性AIのコーディングエージェントは、モジュール化された知覚・把持・動作計画のインターフェースを呼ぶコードを書くこともできれば、凍結した VLA や世界行動モデル(WAM)を直接呼び出すこともできます。ただし、現在の物理状態でどちらが成功するかを事前に見通すことはできません。プレプリント RoboAware(arXiv 2610.11480、2026-10-08)は、コーディングエージェントにも実行器にも手を加えず、「責任コーディネーター」だけを学習します。各スキル段階の開始時に、次のコードブロックをモジュール合成(Mod)と end-to-end 方策(E2E)のどちらに任せるかを決める部分です。学習データはシミュレーション内の「状態を固定した反事実分岐」から得ます。シミュレータを同じ状態に戻して 2 種類の分岐をそれぞれ実行し、選ばれなかった側で何が起きたかを観測します。著者は、LIBERO-Pro、RoboSuite、RoboTwin 2.0 の 3 つのベンチマークにまたがる 100 タスクで総合成功率 77.0% と報告しています。以下の数値はすべて著者報告 [R] で、本サイトでは再現していません。
選択肢が 2 つしかない上位の行動
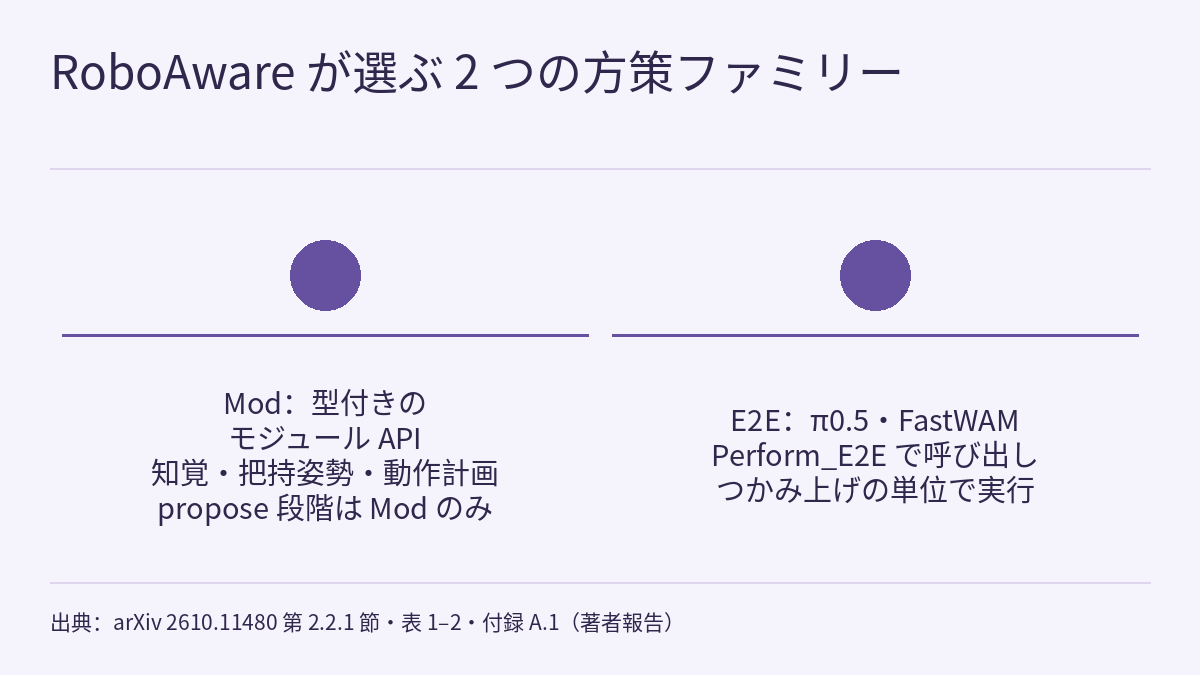
論文はこの問題を有限ホライズンの階層型 MDP として定式化しています。上位の行動は 1 つだけで、方策ファミリー c ∈ {Mod, E2E} の選択です。ファミリーが決まると、凍結したコーディングエージェントが、そのファミリーと現在の文脈を条件として、固定の API ライブラリを通じて完全なローカルコードブロックを 1 つ生成し、実行します。決定点は P⁵ スキルスキーマの各段階の開始時です。P⁵ はすべてのスキルを perceive(知覚)、propose(姿勢の提案)、pre-manipulate(操作前)、perform(実行)、post-manipulate(操作後)の 5 段階に分け、pick、place、push、pull のような基本スキルも、handover のような複合スキルも同じ形で表します。コーディネーターが受け取るのは、言語指示、観測(RGB 画像、メトリック深度、固有感覚)、観測可能な実行履歴、現在の段階、実行中のスキルです。学習するのはコーディネーターの価値モデル Qθ だけで、コーディングエージェント、API インターフェース、バックエンドの割り当て、低レベルのパラメータは固定です。
| API | 対応する P⁵ 段階 | 方策ファミリー | バックエンド |
|---|---|---|---|
Perceive_object_pose | perceive | Mod | InstructSAM |
Propose_eef_pose | propose | Mod | NeuGraspNet+(著者による NeuGraspNet の拡張) |
Plan_to_eef_pose | pre-manipulate、post-manipulate | Mod | cuRoboV2 |
Perform_gripper | perform | Mod | 決定論的なグリッパー API |
Perform_E2E | perceive、pre-manipulate、perform、post-manipulate | E2E | π0.5、FastWAM |
なぜ VLA と WAM にタスク全体を任せず、「つかんで持ち上げる」単位に置くのでしょうか。著者のオフライン選定(表 1、成功回数 / 総回数)では、π0.5 のタスク全体の成功は LIBERO-Pro、RoboSuite、RoboTwin 2.0 でそれぞれ 10/14、0/4、0/10 ですが、つかみ上げだけなら 13/14、2/4、2/10 です。FastWAM はタスク全体で 4/14、0/4、10/10、つかみ上げで 11/14、0/4、10/10 です。propose 段階で使えるのは Mod だけです。end-to-end のバックエンドは把持目標を内部で決め、このインターフェースを通じて出力しないためです。1 回の Perform_E2E 呼び出しは複数の段階にまたがることがあり、呼び出しの間は選んだファミリーが変わりません。登録された事後条件を満たすか、失敗を報告するか、ステップ予算を使い切るまで続きます。
SCB と EAL:選ばなかった側の結果を同じ状態から補う
著者によれば、既存の手法は実行結果を見ないか、実行した軌道の結果だけを VLM で判定します。後者は選んだ分岐の帰結しか見えないため、選択バイアスを受け継ぎます。State-Locked Counterfactual Branching(SCB)は学習時だけに使う仕組みです。シミュレータの保存・復元機能と oracle による結果判定を使い、各 P⁵ 決定点でまったく同じ物理状態から、許容される各ファミリーのコードブロックを 1 つずつ生成して実行します。スナップショットには、デプロイ時に見える文脈に加えて、oracle マスク、物体の真値姿勢、終端報酬の評価器が含まれます。いずれも特権情報です。
Execution-Aware Learning(EAL)は、これらの分岐をモンテカルロ木探索で整理します。ノードは復元可能な決定状態、エッジは許容される方策ファミリーです。展開済みのノードでは UCB でエッジを選び、新しいノードでは各ファミリーを少なくとも 1 回評価します。その後、API ライブラリを使って残りを最後まで実行し、タスク終了、回復不能な失敗、ホライズン T のいずれかに達したら、収益を経路に沿って逆伝播します。予算はルートごとに完了した後続シミュレーション K = 20 回です。評価したすべてのエッジが、失敗した分岐や選好されなかった分岐も含めて、学習データ D_SCB に入ります。
各ステップの学習用報酬は r̃ = w_p·r_p + w_m·r_m + w_t·d·r で、重みは非負かつ w_p + w_m + w_t = 1 です。r_p は oracle マスクとの一致度、r_m はしきい値 ε_p のもとでの物体姿勢の誤差から求め、r は終了時にだけ与える二値のタスク成功です。割引率は γ = 1 です。本サイトが読んだ本文には重みの値がありません。データ収集後、著者はこの固定データセットで、Bellman ターゲット、Smooth-L1 損失、勾配を止めたターゲットネットワークを使って Qθ を学習します。探索で得た収益を直接回帰するわけではありません。Qθ は軽量な VLM バックボーン(例:Qwen3.5-0.8B)に MLP ヘッドを付けたもので、<VALUE> トークンで終わる「文脈とファミリー」の系列を読み取ります。デプロイ時には Q 値が最大のファミリーを選び、コーディングエージェントがコードブロックを生成します。この段階ではシミュレータの復元も、特権情報も、オンライン探索も使いません。
77.0% はどう計算されているか
評価は 100 個の卓上操作タスクで行われます。SCB 分岐の収集と Qθ の学習にはシーンのシード 0 だけを使い、凍結したコーディネーターをシード 1–10 でテストします。テストは計 1,000 エピソードで、シードごとに 1 回の試行です。記憶に依存するベースラインでは、エピソードをまたぐグローバルな記憶を無効にしています。π0 と π0.5 は RoboTwin の双腕構成に対応していないため、これらを含む結果は「/」で示されています。下表の LIBERO-Pro の列は、論文の表 3 にある 8 つの分割を本サイトが平均したもので、それ以外は論文の値(%)です。下表は抜粋で、省いた行には π0、FastWAM、CaP-X、RATS、VLS が含まれます。
| 手法 | LIBERO-Pro 8 分割の平均(本サイト計算) | RoboSuite | RoboTwin | Overall(論文) |
|---|---|---|---|---|
| π0.5(end-to-end) | 11.0 | 0.0 | / | 9.8 |
| FasterWAM(end-to-end) | 12.5 | 0.0 | 85.6 | 18.6 |
| CaP(Code-as-Policy) | 0.0 | 70.0 | 5.6 | 7.6 |
| ASPIRE(Code-as-Policy) | 61.25 | 80.0 | 0.0 | 57.0 |
| Pigey(VLA + ハーネス) | 45.0 | 15.0 | / | 41.7 |
| Harness-VLA(VLA + ハーネス) | 53.75 | 20.0 | / | 50.0 |
| RoboAware | 73.75 | 90.0 | 90.0 | 77.0 |
この表を読むときは 3 点に注意が必要です。第一に、表 3 の Overall は利用できる列の単純平均です。RoboAware の 10 列のうち 8 列は LIBERO-Pro の分割で(要旨の 73.8% はこの 8 列の平均です)、「/」を含む行は 9 列で平均しています。本サイトが読んだ本文には列ごとのタスク数がないため、77.0% は 100 タスクや 1,000 エピソードで重み付けした成功率ではありません(本サイトの検算)。第二に、RoboAware は平均では最高ですが、すべての分割で最高ではありません。Obj-T と Obj-S では ASPIRE が 95.0 と 98.0、RoboAware が 92.0 と 86.0 です。Spat-T では Pigey が 80.0、RoboAware が 68.0、Spat-S と Obj-S では Harness-VLA が 70.0 と 90.0、RoboAware が 68.0 と 86.0 です。第三に、RoboTwin では単独で動かした FastWAM と FasterWAM がすでに 81.9 と 85.6 に達しており、RoboAware の 90.0 は FasterWAM より 4.4 ポイント高い値です。本サイトが読んだ本文には信頼区間がありません。
アブレーション:2 つのファミリー、対になった結果、段階ごとの切り替え
| 変種 | 内容 | LIBERO-Pro | RoboSuite | RoboTwin 2.0 |
|---|---|---|---|---|
| MO | モジュール型のコードブロックのみ | 54.8 | 67.5 | 41.9 |
| EO | end-to-end のコードブロックのみ | 49.5 | 60.0 | 45.6 |
| UO | コーディネーターを学習するが、実行した軌道だけを使い、対になった分岐はない | 58.5 | 75.0 | 53.8 |
| TF | コーディネーターを学習せず、コーディングエージェントが混合 API ライブラリから直接選ぶ | 51.0 | 60.0 | 40.0 |
| FH | 固定の引き継ぎ:perceive と pre-manipulate はモジュール型 API、その後は E2E を呼ぶ | 64.5 | 82.5 | 55.6 |
| ES | エピソード開始時に 1 回だけファミリーを選び、最後まで変えない | 59.3 | 70.0 | 51.9 |
| RoboAware | P⁵ の段階ごとに選び直す | 73.8 | 90.0 | 90.0 |
著者の解釈は次のとおりです。MO と EO はどちらも低いので、2 つのファミリーは状態に応じて調整する必要がある。UO が TF を上回るので、コーディングエージェントはもともと実行の帰結を意識できず、反事実データがなくてもコーディネーターの学習は役に立つ。完全な手法が UO を上回るので、同じ状態から対にして実行することが必要だと裏付けられる。著者は UO との差を modest(小幅)と呼んでいますが、表 4 では 3 つのベンチマークでそれぞれ 15.3、15.0、36.2 ポイント低くなっています(本サイトの換算)。FH と ES はどちらも段階ごとの選択を下回ります。もう 1 つ目を引く数値があります。EO の RoboTwin での成功率は 45.6% で、単独で動かした FastWAM(81.9%)や FasterWAM(85.6%)より低くなっています。本サイトが読んだ本文には、この差の説明がありません。
ほかの 2 つの分析は図だけで示されています。RoboSuite で探索予算 K を 5、10、20、50 と変えると、K が大きくなるにつれて成功率の伸びは小さくなります。著者は屈曲点の K = 20 を採用し、同じ予算では UCB による配分が均等配分を上回ったとしています。また、Claude Code(既定)、Cursor、Codex の 3 つのコーディングエージェントと、Aloha-AgileX(既定)、Franka-Panda、ARX-X5、UR5-WSG の 4 つのロボット身体で、RoboTwin 2.0 の 4 タスクを評価すると、平均成功率の差は小さいとしています。著者は、コーディングエージェント間の差が小さい理由を、P⁵ が 1 回に 1 つのコードブロックしか生成させないことに求めています。この 2 つの分析の具体的な数値は、本サイトが読んだ本文にはありません。
本サイトの既存記事との関係
フィジカルAIラボ 1.7:強化学習では、収益、価値、報酬の整形を扱いました。RoboAware の Qθ(x, c) が推定するのは「次にファミリー c を選んだあとに残るスキル単位とタスク単位の収益」で、報酬に含まれる知覚スコアと操作スコアは整形の一種です。しかも、シミュレーション内の oracle マスクと真値姿勢に依存します。1.7 では、整形項の書き方を誤ると抜け道を突かれると注意しました。本サイトが読んだ本文には、重みの値も、整形項がコーディネーターの選択に与える影響の個別分析もありません。
フィジカルAIラボ 1.8:評価では、対応のある比較を扱いました。同じ初期状態を各条件で 1 回ずつ実行して、1 対 1 で比べる方法です。SCB は同じ考え方を学習データに当てはめ、各決定点で同じ復元状態から Mod と E2E を比べます。これで、2 つの分岐がもともと違う状態から始まることを避けています。ただし、最終的な手法の評価はシードごとに 1 回の試行で、表 3 は成功率だけを示し、ベースラインとの対ごとの改善・悪化の内訳はありません。
フロンティア・レーダー|RESETTLE の実験にも Harness VLA が登場します。ただし比較対象のベースラインではなく土台となるシステムで、RESETTLE は Harness VLA の低レベルの動作インターフェースの上に追加されています。RESETTLE は動作の実行インターフェースで食い違いを検知し、実行中に 1 ステップだけ補正します。RoboAware は、コードを生成する前に段階の境界で、誰が実行するかを決めます。2 つの論文はタスクの分割もプロトコルも異なるので、数値を互いに比べることはできません。
制約と注意点
- arXiv のプレプリントで、数値はすべて著者報告 [R] です。表 3 のベースラインは著者のプロトコルで実行され、記憶に依存する手法ではエピソードをまたぐ記憶が無効化されています。著者自身も、1 回きりの評価では、CaP-X、RATS、ASPIRE のような記憶ベースの手法が蓄積した経験から得られる利点は限られると書いています。本サイトではどの結果も再現していません。
- SCB は、シミュレータの保存・復元、oracle マスク、物体の真値姿勢、終端の評価器に依存します。本サイトが読んだ本文では、学習も評価もシミュレーション内で行われ、実機実験はありません。同じ状態の対になった結果を実機でどう得るかも説明されていません。シミュレーションの結果はハードウェアの安全性検証ではありません。
- 3.1 節によれば、SCB 分岐はシーンのシード 0 で収集し、テストはシード 1–10 で行います。本サイトが読んだ本文には、学習にまったく現れないタスクでの結果はありません。各シードは 1 回だけの実行で、本文に信頼区間はなく、Overall はタスクやエピソードで重み付けした値ではなく列の平均です。
- 著者が明記している制約:現時点で統合しているのはモジュール合成と end-to-end 方策の 2 種類だけで、強化学習方策や検索ベースの方策などへ広げるには、新たな反事実データと追加の学習が必要になりうること。責任が切り替わるのは P⁵ の境界だけなので、1 回のアトミックな E2E 呼び出しが複数の段階にまたがることがあり、事後条件、失敗信号、タイムアウトのいずれかで制御が戻るまで、一時的な失敗はその内部の制御器に任されること。
- 予算 K、コーディングエージェント、ロボット身体に対する感度分析は図だけで、本サイトが読んだ本文には数値がありません。本サイトが読んだ論文 HTML は付録 A.2 のアルゴリズムの途中で終わっており、付録 B の選定の詳細や付録 C のタスクの詳細は含みません。
リンク
- RoboAware: Learning to Coordinate Embodied Skills from Counterfactual Outcomes(arXiv 2610.11480)
- 論文の HTML 全文
- フィジカルAIラボ 1.7:強化学習――1 回分の収益を手で計算して報酬の抜け道を見つけ、論文の地形カリキュラムとタイムアウト時のリセットを読む
- フィジカルAIラボ 1.8:評価――「差し引き +2」を対応表に分解し、失敗ラベルと乱数シードを計算で確かめる
- フロンティア・レーダー|RESETTLE:凍結した方策の 2 つの動作サンプルが食い違い続けたときだけ介入し、デモを参照して補正動作を 1 回だけ実行する
- フィジカルAIラボ:すべての数字を確認できるフィジカルAI講座(講座の概要)