
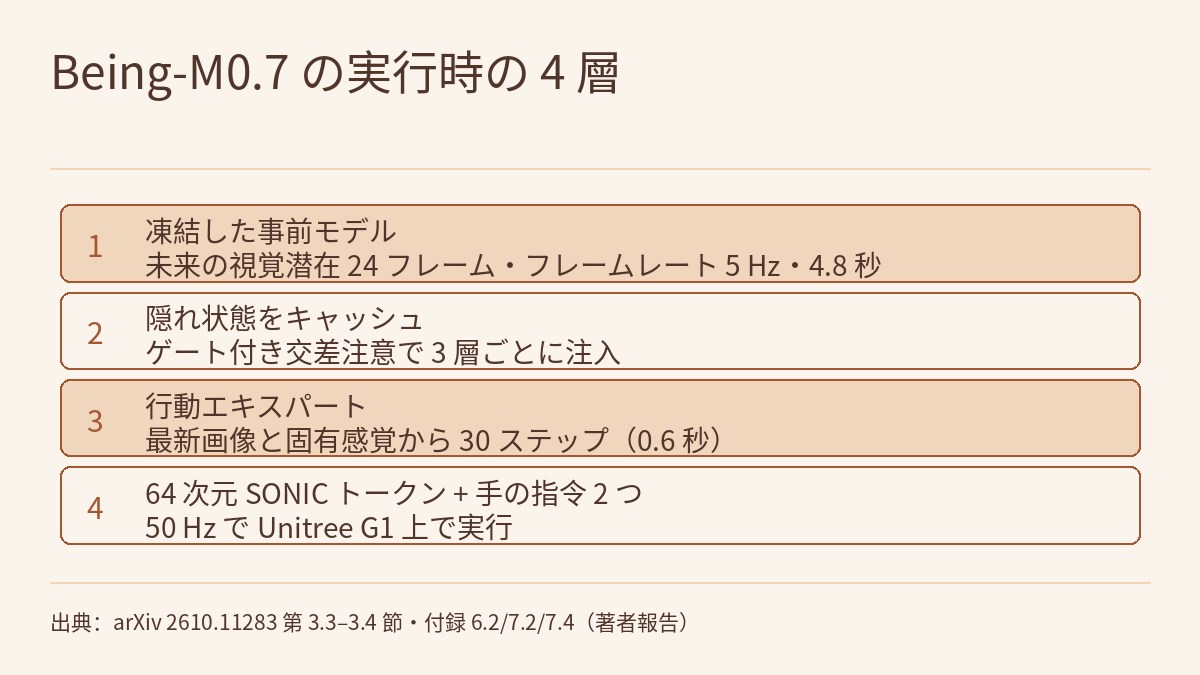
人型ロボットの移動マニピュレーションのデモは集めるのが難しく、一人称視点の映像、固有感覚、実行可能な全身指令を同期して記録する必要があります。人の映像やモーションキャプチャのデータははるかに豊富ですが、その多くは映像だけ、または動作だけしか含まず、人の動作はそのままロボットが実行できる指令でもありません。BeingBeyond Team のプレプリント Being-M0.7(arXiv 2610.11283、2026-10-08)は、これを 3 段階で扱います。まず 10,000 時間を超える生の人間データで未来の視覚潜在表現と身体動作を同時に予測し、次にロボット軌道で中間学習を行い、最後にこの事前モデルを凍結して、別の行動エキスパートがゲート付き交差注意でその予測を取り込み、Unitree G1 の全身指令を出力します。著者報告では、SIMPLE シミュレーション・ベンチマークの 180 試行で 128 回成功して比較手法中で最高、実機 15 試行では 13 回成功で GR00T-N1.6 と同等でした。以下の数値はすべて著者報告 [R] で、本サイトでは再現していません。
データ:3 つの教師信号の流れと、人とロボットで共有する身体表現
論文が集めた生データはフィルタリングと時間分割の前で 10,000 時間を超え、3 つの教師信号の流れに整理されています。映像と動作が対になった一人称視点データ、映像だけのデータ、動作だけのデータです。対になったサンプルは映像と動作の同時予測を教師し、対になっていないサンプルは持っているモダリティだけを教師しますが、モデルのパラメータは共通です。欠けたモダリティは学習済みのプレースホルダー埋め込みで置き換えられ、注意マスクで隔離されるため、プレースホルダーのトークンは有効な視覚トークンや動作トークンと情報をやり取りしません。
論文が挙げる公開データは Ego4D、Xperience、Nymeria、Bones-SEED、SnapMoGen、HumanML3D、Lafan1 で、ほかに Being-H0.5 と Being-M0.5 の学習コーパスの一部、商業的に取得したデータセットが含まれます。混合データのローダーはデータ源ごとの重み付けをしない(dataset_weights=null)ので、3 つの流れの比率は固定の等配分ではなく、フィルタリング後の有効サンプル数で決まります。本サイトが読んだ論文の HTML テキストには、流れごとの時間数もフィルタリング後の総量も書かれていません。論文の図 2 がデータ源をまとめていますが、本サイトは図を読んでいません。
人とロボットでは関節が異なるため、論文は 22 次元の「頭部ルート」ベクトルで両者を同じ形式に書きます。
| 次元 | 内容 |
|---|---|
| 1–3 | ルート(頭部)の並進。モデル入力は累積した相対的な頭部位置 |
| 4–9 | 頭部の向きの連続 6D 回転表現 |
| 10 | 初期の頭部の高さ |
| 11–22 | 左手・右手・左足・右足の、頭部座標系での 3D 位置 |
人の動作もロボットの軌道も、同じ成分順と座標の取り決めでこのベクトルに書かれ、5 Hz にリサンプリングされます。論文によれば、この表現は頭部の動きと 4 つの末端の位置を記述するもので、人とロボットで同じ関節角のパラメータ化を必要としません。映像側では、入力も予測目標も凍結した DINO エンコーダーの潜在表現で、ピクセル単位の再構成は行いません。著者は、視覚と動作の同時予測によって、視覚表現がピクセルの再構成に必要な細部ではなく、背後にある運動学的な変化に注目するようになると説明しています。
3 段階の学習と、凍結した事前モデルを行動エキスパートにつなぐ方法
| 段階 | データ | 学習するモジュール | 目的関数 |
|---|---|---|---|
| 事前学習 | 人間データの 3 つの流れ | 事前モデル:映像–動作の Mixture of Transformers、30 層、幅 768 | 視覚潜在表現と動作の flow matching。動作があるときは全体軌道と局所的な末端速度の 2 つの幾何補助損失を追加 |
| ロボット中間学習 | ロボット軌道の映像、テキスト、22 次元の動作 | 事前モデル | 視覚と動作の flow matching。動作項は動作があるときだけ計算 |
| 行動の事後学習 | 同じロボット軌道の映像、テキスト、現在の固有感覚、デモの行動チャンク | 行動エキスパート(30 層、幅 1024)とその観測・文脈の射影だけ。事前モデルは凍結 | 行動チャンクの flow matching |
3 段階とも GPU 8 基を使い、実効バッチサイズはそれぞれ 2048、512、512 です。事後学習で使う事前モデルは、中間学習の 50,000 回目の最適化更新時点のチェックポイントです。DINO と DistilBERT のエンコーダーはすべての段階で凍結されています。
ゲート付きの接続
事後学習と実行時には動作予測が無効になり、事前モデルは現在の 1 フレームと言語指示から未来の視覚潜在表現だけを生成します。24 フレームを 5 Hz で、4.8 秒分です。この 24 フレームの隠れ状態(事前モデルの対応する層の手前の隠れ状態)がキーと値になり、行動エキスパートの第 3、6、9……30 層に交差注意で注入されます。観測した 1 フレームはエキスパートのキャッシュに入りません。この問い合わせを出すのは行動トークンだけで、固有感覚のトークンは事前モデルを参照せず、エキスパート内部の局所的な自己注意を通じてのみ行動に影響します。各行動トークンへの注入量はゲートで決まります。ゲート値は、そのトークンの局所特徴と注入候補の更新をそれぞれ層正規化して連結し、線形層とシグモイドに通して得るスカラーです。情報は事前モデルからエキスパートへの一方向だけに流れ、行動損失の勾配は事前モデルに戻りません。
ほかに 2 点の細部があります。第 1 に、事後学習でエキスパートが見るのは、正解の未来にノイズを加えたものではなく、事前モデル自身がノイズからサンプリングした予測(3 ステップ)です。著者は、学習時と推論時で条件の出どころが食い違うのを減らすためだとしています。推論時の事前モデルは 10 ステップでサンプリングします。第 2 に、「動作予測の無効化」で取り除かれるのは動作による条件付け、動作状態の生成、動作の教師信号であり、実装ではマスクされた動作スロットを含む共有のフォワード計算がそのまま実行され、その予測は捨てられます。動作ブランチの計算がすべて省かれるわけではありません。実機実験では事後学習に確率 0.1 のサンプル単位の世界文脈ドロップアウトを加え、エキスパートが現在の観測を使うよう促しています。シミュレーション実験では使っていません。
実行時の 3 つのリズム
エキスパートは 1 回に 30 ステップの行動チャンクを出力し、50 Hz で実行し終えるのに 0.6 秒かかるため、0.6 秒ごと(約 1.67 Hz)に問い合わせを受けます。指令は 0.02 秒ごと(50 Hz)に実行されます。各行動は 66 次元で、64 次元の SONIC 汎用制御トークンと左右の手の開閉指令 1 つずつです。観測は頭部カメラの 1 フレームと 63 次元の固有感覚(ロールとピッチ、角速度、関節位置、関節速度)です。事前モデルの視覚的な計画はキャッシュされ、複数の行動問い合わせで再利用され、予測区間を使い切る前に更新されます。本サイトが読んだテキストはこの部分で途切れており、更新の具体的な間隔はわかりません。方策は外部ワークステーションの NVIDIA RTX 4090 1 基で推論し、ZMQ でロボット上の下位コントローラーと閉ループで通信します。読んだテキストには推論時間の記載がありません。
SIMPLE:180 回のシミュレーション試行とアブレーション
シミュレーション評価には SIMPLE ベンチマークの 6 タスクを使い、各タスクを易・中・難の 3 段階のドメインランダム化でそれぞれ 10 回、手法ごとに計 180 回試行します。すべての手法とアブレーション版はマルチタスク設定で、6 タスクのデモでモデルを 1 つ学習し、評価時にはタスク指示で実行するタスクを指定します。ベースラインは GR00T-N1.6、Ψ0、π0.5 です。次の表は論文の表 1・表 2 の成功数を 3 段階の難易度で合計したもので、各セルは 30 回中の成功数です。
| 手法 | BendPick | Handover | Mobile P&P | Grasp | XMoveBendPick | XMovePick | 合計(/180) |
|---|---|---|---|---|---|---|---|
| GR00T-N1.6 | 11 | 8 | 0 | 22 | 20 | 0 | 61 |
| Ψ0 | 27 | 20 | 0 | 28 | 20 | 21 | 116 |
| π0.5 | 0 | 19 | 19 | 20 | 26 | 11 | 95 |
| Being-M0.7(完全版) | 22 | 28 | 13 | 28 | 9 | 28 | 128 |
| 事前学習なし | 0 | 28 | 7 | 21 | 11 | 21 | 88 |
| 中間学習なし | 2 | 26 | 14 | 24 | 15 | 26 | 107 |
| 言語のみの文脈 | 13 | 25 | 10 | 28 | 21 | 8 | 105 |
完全版の合計は 128/180(71.1%)で、Ψ0 は 116/180(64.4%)、π0.5 は 95/180(52.8%)、GR00T-N1.6 は 61/180(33.9%)です。論文は、タスク別に集計すると BendPick では Ψ0、Mobile P&P と XMoveBendPick では π0.5 が上回るとも書いています。本サイトは表からもう 1 点読み取りました。XMoveBendPick での完全版の 9/30 は表の 7 行中で最も低く、3 つのベースラインより、また 3 つのアブレーション版のどれよりも低い値です。
各アブレーションは 1 つの要素を取り除きます。混合モダリティの事前学習を除くと合計は 88/180(48.9%)で 22.2 ポイント低下し、ロボット中間学習を除くと 107/180(59.4%)で 11.7 ポイント低下します。どちらも BendPick ではほぼゼロになります(22/30 から 0/30 と 2/30)。「言語のみの文脈」は事前モデルの予測文脈をタスク指示の言語特徴に置き換えたもので、エキスパートは現在の画像と固有感覚を引き続き受け取ります。合計は 105/180(58.3%)で 12.8 ポイント低下しました。完全版は 6 タスク中 4 タスクで上回り、差が最大なのは XMovePick(28/30 対 8/30)ですが、XMoveBendPick では言語のみの文脈のほうが良い結果でした(21/30 対 9/30)。著者はこれをもって、事前モデルがタスクの言語と現在の観測以上に有用な予測情報を与えていると考える一方、効果はタスクによって異なると認め、見た目の似たタスク間で起こりうる干渉を付録 8.3 で論じています。本サイトはこの付録を読んでいません。
この数字で手法を比べるときは試行回数を考える必要があります。本サイトが各試行を独立と仮定して Wilson の式で計算すると、128/180 の 95% 区間は約 64–77%、116/180 は約 57–71% で、両者は重なります。区間の重なりは有意性の検定ではなく、同じタスク・同じ難易度の試行は完全に独立ではありませんが、合計で 6.7 ポイントの差にはまだかなりの不確かさがあることを示しています。読んだテキストには、各手法を何個の乱数シードで学習したかの記載がありません。
実機:Unitree G1 での 15 試行
実機プラットフォームは Unitree G1 で、7 自由度のアーム 2 本、Linker Hand O6 の多指ハンド、頭部に取り付けた Intel RealSense D435i カメラを備えます。デモは VR による全身遠隔操作で集めます。操作者は PICO ヘッドセットと足首の 2 つのトラッカーを着け、2 つのコントローラーを持ちます。XRoboToolkit が操作者の SMPL 姿勢をリアルタイムで推定し、SONIC がそれを 29 自由度の全身制御指令に変換して、G1 上で 50 Hz で実行します。固有感覚、一人称視点の RGB 画像、動作指令は同期して記録されます。読んだテキストには実機デモの本数が書かれていません。
3 つのタスクはいずれも、目標まで歩いてから操作する必要があります。Walk to Fish(水槽まで歩き、手に持った網でおもちゃの魚をすくう)、Walk to Mirror(テーブルまで歩き、鏡に映った像から隠れた人形の位置を推測してつかむ)、Walk to Doll(テーブルまで歩き、見えている人形を直接つかむ)です。各タスク 5 回で、物理的なマーカーでロボットの開始位置とテーブルの位置を固定し、対象物は作業空間の左・中央・右にランダムに置かれます。各試行の制限時間は 30 秒で、成否は人が判定します。
| 手法 | Walk to Fish | Walk to Mirror | Walk to Doll | 合計 |
|---|---|---|---|---|
| GR00T-N1.6 | 3/5 | 5/5 | 5/5 | 13/15 |
| Ψ0 | 0/5 | 1/5 | 2/5 | 3/15 |
| π0.5 | 2/5 | 2/5 | 3/5 | 7/15 |
| Being-M0.7 | 3/5 | 5/5 | 5/5 | 13/15 |
Being-M0.7 と GR00T-N1.6 は合計だけでなく、タスクごとの成功数も同じです。同じ Wilson の計算で、13/15(86.7%)の 95% 区間は約 62–96% です。各タスク 5 回だけでは、この試行で両者の優劣は分かれず、著者の表現も「同等」です。
2 つの表を並べると、もう 1 つの現象が見えます。GR00T-N1.6 は SIMPLE の合計が最も低い(61/180)一方で実機では最高と並び、Ψ0 は SIMPLE で 2 位(116/180)なのに実機では最下位(3/15)です。シミュレーションと実機ではタスク、学習データ、試行回数がいずれも異なり、本サイトが読んだ範囲の論文はこの違いを分析していません。この論文のデータでは、ベースラインの SIMPLE での順位と 3 つの実機タスクでの順位が一致しない、という点に注意が必要です。
本サイトの既存ページとの関係
講座のフィジカルAIラボ 1.5:データはどこから来る?では、人の映像は大量にあるものの、人の手はロボットの手ではなく、映像には正確な関節角も力も含まれないと説明しました。Being-M0.7 はこれへの具体的な対応の 1 つです。関節角を変換するのではなく、人もロボットも頭部と 4 つの末端の位置からなる 22 次元ベクトルで書き、映像だけのデータは動作をまったく提供せず視覚的なダイナミクスだけに寄与します。それでも中間学習と事後学習には、遠隔操作で集めたロボット軌道が必要です。事前学習を除くと 22.2 ポイント下がるという結果は、このシミュレーション設定で人間データの事前学習が役立つことを示す著者の証拠であり、人間データがロボットのデモの代わりになることを示すものではありません。
前日のフロンティア・レーダー|HWAMも人型ロボットの世界行動モデルですが、「身体」の扱い方が異なります。HWAM は実行時も予測した実行後の状態を同時ノイズ除去に残し、コントローラーには行動だけを送ります。Being-M0.7 は実行時に動作予測を無効にし、視覚の隠れ状態だけをゲート経由で別に学習したエキスパートに渡します。2 本の論文はプラットフォーム(LimX OLI と Unitree G1)、タスク、指標がいずれも異なるため、数値は比較できません。
フィジカルAIラボ 0.3のルールは、周波数はそれを示したシステムにだけ属する、というものです。Being-M0.7 の 5 Hz、約 1.67 Hz、50 Hz は同じシステムの同じ設定から来ており、それぞれ予測フレームレート、行動の問い合わせ頻度、指令の実行頻度で、互いに置き換えられません。フィジカルAIラボ 1.8:評価で扱った読み方もここに当てはまります。まず各セルが何回の試行かを確かめ、次に合計がタスクごとの数からどう積み上がっているかを見ます。
制約と注意点
- arXiv のプレプリントで、数値はすべて著者報告 [R] です。著者は BeingBeyond Team と記載されています。本サイトはどの結果も再現していません。論文にはプロジェクトページが記載されていますが、本サイトは確認していません。読んだテキストには、コードや重みが公開されているかの記載がありません。
- 事前学習コーパスには商業的に取得したデータセットとチームの過去のコーパスの一部が含まれますが、読んだテキストにはそれらの名称や規模も、流れごとの時間数もありません。10,000 時間はフィルタリングと分割の前の生データ量です。
- 実機評価は 15 試行(各タスク 5 回)で人が判定し、論文は信頼区間を示していません。本文の Wilson 区間は、各試行を独立と仮定して本サイトが計算したものです。シミュレーションの各セルは 10 試行で、読んだテキストには学習シード数の記載がありません。
- 著者自身が挙げる制約:評価したタスクの時間的な長さは限られており、より長い移動マニピュレーションでの性能は未確認です。現在の構成で使う SONIC 全身コントローラーは末端の追従精度が限られ、ロボットのデモ収集を難しくしています。
- 本サイトが読んだ論文テキストは付録 7.4 の時間設定の段落で終わっており、推論時間、付録 8.3 のタスク間干渉の議論、付録 9.1 の実機タスクの詳細、すべての図は含みません。
- 3 つの実機タスクでの少数の成功試行は、ハードウェアの安全性検証ではありません。
リンク
- Being-M0.7: A Latent World-Action Model for Humanoid Robots(arXiv 2610.11283)
- 論文の HTML 全文
- フロンティア・レーダー|HWAM:人型ロボットの参照動作は実際の動きと一致しない――実行後の身体状態を動作と同時に生成する
- フィジカルAIラボ 1.5:データはどこから来る?――SO-101 のメタデータからお手本の長さを求め、三つの入手ルートの単位と動作空間を見分ける
- フィジカルAIラボ 0.3:見る・考える・動く――3 つの周波数をそれぞれのシステムに戻す
- フィジカルAIラボ 1.8:評価――「差し引き +2」を対応表に分解し、失敗ラベルと乱数シードを計算で確かめる
- フィジカルAIラボ:すべての数字を確認できるフィジカルAI講座(講座の概要)


