
人形机器人的移动操作示范很难采:要同步录下第一视角画面、本体感觉和可执行的全身指令。人类视频和动作捕捉数据多得多,但其中很多只有视频或只有动作,人的动作也不是机器人能直接执行的指令。BeingBeyond 团队的预印本 Being-M0.7(arXiv 2610.11283,2026-10-08)的做法分三段:先在超过 10,000 小时的原始人类数据上联合预测未来的视觉潜变量和身体动作,再用机器人轨迹做中训练,最后冻结这个先验模型,让一个单独的动作专家经门控交叉注意力取用它的预测,输出 Unitree G1 的全身指令。作者报告,它在 SIMPLE 仿真基准的 180 次试验中成功 128 次,是所比方法中最高的;在 15 次真机试验中成功 13 次,与 GR00T-N1.6 持平。以下数字均为作者报告 [R],本站未复现。
数据:三条监督流和一套人与机器人共用的身体表示
论文收集的原始数据在过滤和时间切分之前超过 10,000 小时,整理成三条监督流:成对的第一视角视频–动作数据、只有视频的数据、只有动作的数据。成对样本监督视频与动作的联合预测;不成对的样本只监督自己具备的那一种模态,但共用同一套模型参数。缺失的模态用学到的占位嵌入代替,并通过注意力掩码隔开,占位 token 不和有效的视觉或动作 token 交换信息。
论文列出的公开来源有 Ego4D、Xperience、Nymeria、Bones-SEED、SnapMoGen、HumanML3D 和 Lafan1,另有 Being-H0.5、Being-M0.5 训练语料的子集,以及商业采购的数据集。混合数据加载器不对来源重新加权(dataset_weights=null),三条流的比例由过滤后的有效样本数决定,而不是固定的等比例混合。本站所读的论文 HTML 文本没有给出每条流的小时数或过滤后的总量;论文图 2 汇总了数据来源,本站没有读图。
人和机器人的关节不一样,论文用一个 22 维的“头部根”向量把两者放进同一种描述:
| 维度 | 内容 |
|---|---|
| 1–3 | 根(头部)的平移;模型输入是累加后的相对头部位置 |
| 4–9 | 头部朝向的连续 6D 旋转表示 |
| 10 | 初始头部高度 |
| 11–22 | 左手、右手、左脚、右脚在头部坐标系下的 3D 位置 |
人的动作和机器人轨迹都按同样的分量顺序和坐标约定写成这个向量,再降采样到 5 Hz。论文的说法是,这套表示描述头部运动和四个末端的位置,不要求人和机器人有相同的关节角参数化。画面一侧,视觉输入和预测目标都是冻结的 DINO 编码器的潜变量,不做像素级重建;作者认为,视觉与动作联合预测会促使视觉表示关注底层的运动学变化,而不是重建像素所需的细节。
三段训练,以及冻结的先验怎样接入动作专家
| 阶段 | 数据 | 训练的模块 | 目标 |
|---|---|---|---|
| 预训练 | 人类数据的三条流 | 先验模型:视频–动作 Mixture of Transformers,30 层,宽 768 | 视觉潜变量与动作的 flow matching;有动作时另加全局轨迹与局部末端速度两项几何辅助损失 |
| 机器人中训练 | 机器人轨迹的视频、文本和 22 维动作 | 先验模型 | 视觉与动作的 flow matching,动作项只在有动作时计算 |
| 动作后训练 | 同一批机器人轨迹的视频、文本、当前本体感觉和示范动作块 | 只训练动作专家(30 层,宽 1024)及其观测与上下文投影;先验冻结 | 动作块的 flow matching |
三个阶段都用 8 块 GPU,有效批量分别为 2048、512、512。后训练所用的先验取自中训练第 50,000 次优化更新时的检查点。DINO 和 DistilBERT 编码器在所有阶段都保持冻结。
门控接入
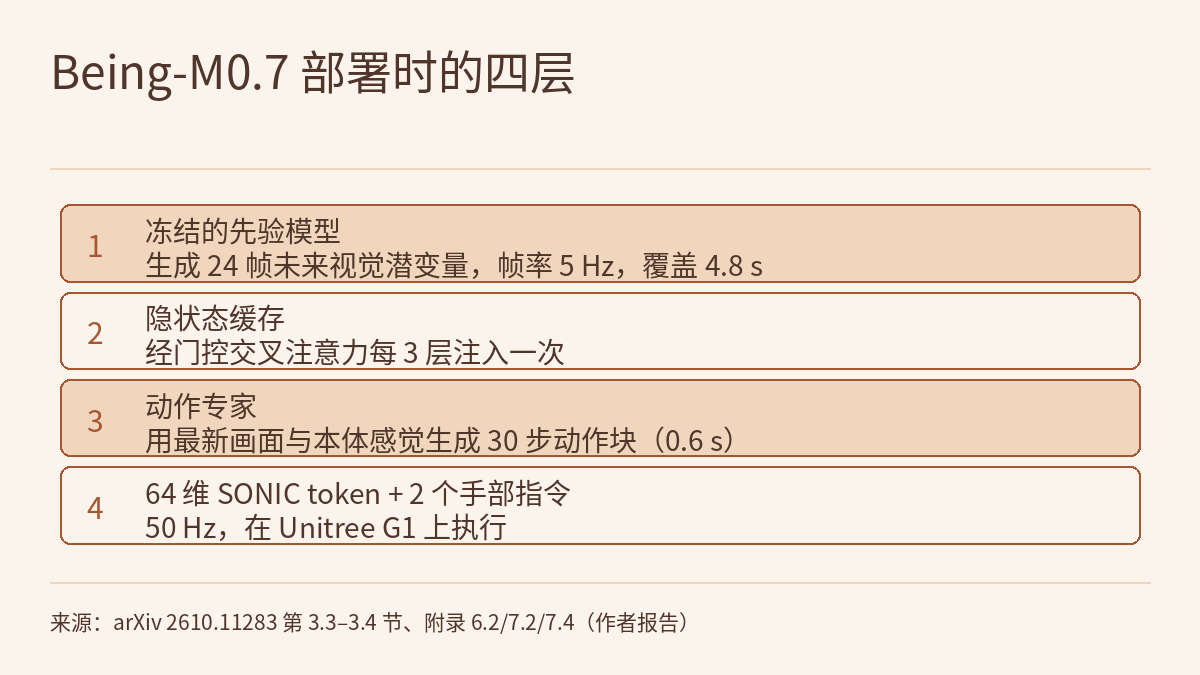
后训练和部署时,动作预测被关闭:先验只根据当前一帧画面和语言指令生成未来视觉潜变量,共 24 帧,按 5 Hz 覆盖 4.8 秒。这 24 帧的隐状态(取先验对应层之前的隐状态)作为键和值,在动作专家的第 3、6、9……30 层通过交叉注意力注入;观测到的那一帧不进入专家的缓存。只有动作 token 发起这次查询,本体感觉 token 不查询先验,只在专家内部的局部自注意力里影响动作。每个动作 token 的注入量由一个门控决定:门控值是对该 token 的局部特征和拟注入更新各做层归一化、拼接后经线性层和 sigmoid 得到的标量。信息只从先验流向专家,动作损失的梯度不回传到先验。
还有两处细节。第一,后训练时专家看到的是先验自己从噪声采样出的预测(3 步采样),而不是给真实未来加噪得到的结果,作者称这是为了减小训练与推理时条件来源的不一致;推理时先验用 10 步采样。第二,“关闭动作预测”去掉的是动作条件、动作状态生成和动作监督,实现里仍然执行包括被屏蔽的动作槽位在内的共享前向计算,预测结果被丢弃,并没有剪掉全部动作分支的计算。真机实验在后训练中另加概率 0.1 的样本级世界上下文丢弃,鼓励专家使用当前观测;仿真实验不用。
部署时的三种节奏
专家每次输出一个 30 步的动作块,按 50 Hz 执行完需要 0.6 秒,因此每 0.6 秒查询一次(约 1.67 Hz);指令以每 0.02 秒一次(50 Hz)执行。每个动作是 66 维:64 维 SONIC 通用控制 token,加左右手各一个开合指令。观测是头部相机的一帧画面和 63 维本体感觉(横滚与俯仰、角速度、关节位置和关节速度)。先验生成的视觉计划被缓存,在多次动作查询之间复用,并在预测窗口用完之前刷新;本站所读文本在这一段截断,没有给出刷新的具体间隔。策略在外部工作站的一块 NVIDIA RTX 4090 上推理,经 ZMQ 与机器人上的底层控制器闭环通信;所读文本没有给出推理耗时。
SIMPLE:180 次仿真试验与消融
仿真评测用 SIMPLE 基准的六项任务,每项在易、中、难三档域随机化下各做 10 次,每个方法共 180 次。所有方法和消融变体都是多任务设定:在六项任务的示范上联合训练一个模型,评测时用任务指令指定任务。基线是 GR00T-N1.6、Ψ0 和 π0.5。下表把论文表 1、表 2 中三档难度的成功数相加,每格满分 30:
| 方法 | BendPick | Handover | Mobile P&P | Grasp | XMoveBendPick | XMovePick | 合计(/180) |
|---|---|---|---|---|---|---|---|
| GR00T-N1.6 | 11 | 8 | 0 | 22 | 20 | 0 | 61 |
| Ψ0 | 27 | 20 | 0 | 28 | 20 | 21 | 116 |
| π0.5 | 0 | 19 | 19 | 20 | 26 | 11 | 95 |
| Being-M0.7(完整) | 22 | 28 | 13 | 28 | 9 | 28 | 128 |
| 去掉预训练 | 0 | 28 | 7 | 21 | 11 | 21 | 88 |
| 去掉中训练 | 2 | 26 | 14 | 24 | 15 | 26 | 107 |
| 只用语言上下文 | 13 | 25 | 10 | 28 | 21 | 8 | 105 |
完整模型合计 128/180(71.1%),Ψ0 为 116/180(64.4%),π0.5 为 95/180(52.8%),GR00T-N1.6 为 61/180(33.9%)。论文也写明,按任务汇总时 Ψ0 在 BendPick 领先,π0.5 在 Mobile P&P 和 XMoveBendPick 领先。本站从表中另读出一点:在 XMoveBendPick 上,完整模型的 9/30 是表中七行里最低的,低于三个基线,也低于三个消融变体。
消融各换掉一个部分。去掉混合模态预训练,合计降到 88/180(48.9%),少 22.2 个百分点;去掉机器人中训练降到 107/180(59.4%),少 11.7 个百分点;两者在 BendPick 上都几乎归零(22/30 降到 0/30 和 2/30)。“只用语言上下文”把先验的预测上下文换成任务指令的语言特征,专家仍然看到当前画面和本体感觉,合计 105/180(58.3%),少 12.8 个百分点;完整模型在六项中的四项更好,XMovePick 上差距最大(28/30 对 8/30),但 XMoveBendPick 上语言上下文反而更好(21/30 对 9/30)。作者据此认为先验在任务语言和当前观测之外提供了有用的预测信息,同时承认收益因任务而异,并在附录 8.3 讨论了视觉相似任务之间可能的干扰;本站没有读到该附录。
用这组数据比较方法时,要考虑试验次数。本站按 Wilson 公式计算、假设各次试验相互独立:128/180 的 95% 区间约为 64–77%,116/180 约为 57–71%,两者有重叠。区间重叠不是显著性检验,而且同一任务、同一难度下的试验并不完全独立;但它说明 6.7 个百分点的总差距仍有相当的不确定性。本站所读文本没有说明每个方法训练了几个随机种子。
真机:Unitree G1 上的 15 次试验
真机平台是 Unitree G1,配两条 7 自由度手臂、Linker Hand O6 灵巧手和装在头部的 Intel RealSense D435i 相机。示范通过 VR 全身遥操作采集:操作者戴 PICO 头显和两个脚踝追踪器、手持两个手柄,XRoboToolkit 实时估计操作者的 SMPL 姿态,SONIC 把它转换成 29 自由度的全身控制指令,以 50 Hz 在 G1 上执行;同步记录本体感觉、第一视角 RGB 画面和运动指令。本站所读文本没有给出真机示范的条数。
三项任务都要求先走到目标处再操作:Walk to Fish(走到水箱前,用手持网兜捞起玩具鱼)、Walk to Mirror(走到桌前,从镜中反射推断藏起的玩偶位置并抓取)、Walk to Doll(走到桌前,直接抓取看得见的玩偶)。每项 5 次,物理标记固定机器人起点和桌子位置,目标物在工作区左、中、右随机放置,每次限时 30 秒,由人工判定成败。
| 方法 | Walk to Fish | Walk to Mirror | Walk to Doll | 合计 |
|---|---|---|---|---|
| GR00T-N1.6 | 3/5 | 5/5 | 5/5 | 13/15 |
| Ψ0 | 0/5 | 1/5 | 2/5 | 3/15 |
| π0.5 | 2/5 | 2/5 | 3/5 | 7/15 |
| Being-M0.7 | 3/5 | 5/5 | 5/5 | 13/15 |
Being-M0.7 与 GR00T-N1.6 不只合计相同,三项任务的成功数也逐项相同。按同样的 Wilson 计算,13/15(86.7%)的 95% 区间约为 62–96%;每项只有 5 次,这组试验分不出两者的高下,作者的表述也是“持平”。
两张表放在一起还有一个现象:GR00T-N1.6 在 SIMPLE 上合计最低(61/180),在真机上与最高持平;Ψ0 在 SIMPLE 上排第二(116/180),在真机上最低(3/15)。仿真和真机的任务、训练数据和试验次数都不同,论文所读部分没有分析这一差异;它提醒读者,在这篇论文的数据里,基线在 SIMPLE 上的排序和在三项真机任务上的排序并不一致。
和站内已有内容的关系
课程物理AI实验室 1.5:数据从哪来讲过,人类视频量大,但人手不是机器手:视频里没有精确的关节角,也没有力。Being-M0.7 是一种具体的应对:不去翻译关节角,而是把人和机器人都写成头部与四个末端位置的 22 维向量;只有视频的数据完全不提供动作,只贡献视觉动态。它仍然需要遥操作采集的机器人轨迹来做中训练和后训练。去掉预训练少 22.2 个百分点,是作者在这个仿真设定中报告的证据,说明人类数据预训练有帮助,不说明人类数据可以替代机器人示范。
前一天的前沿雷达|HWAM同样是人形机器人的世界动作模型,但两者对“身体”的处理方向不同:HWAM 部署时仍让预测的执行后状态参与联合去噪,只把动作发给控制器;Being-M0.7 部署时关闭动作预测,只把视觉隐状态经门控交给一个单独训练的专家。两篇论文的平台(LimX OLI 与 Unitree G1)、任务和指标都不同,数字不能互相比较。
物理AI实验室 0.3的规则是一个频率只属于给出它的系统。Being-M0.7 的 5 Hz、约 1.67 Hz 和 50 Hz 出自同一个系统的同一份配置,分别是预测帧率、动作查询频率和指令执行频率,不能互相替换。物理AI实验室 1.8:评测讲过的读法也适用于这里:先看每格做了几次,再看总数是怎样由各项加起来的。
局限 / 注意
- 这是 arXiv 预印本,全部数字为作者报告 [R],作者署名 BeingBeyond Team。本站没有复现任何结果。论文列出了项目页,本站没有核对;所读文本没有说明代码或权重是否公开。
- 预训练语料包含商业采购的数据集和团队此前语料的子集,所读文本没有给出这些部分的名称或规模,也没有给出各条流的小时数;10,000 小时是过滤和切分之前的原始量。
- 真机评测共 15 次,每项任务 5 次,由人工判定,论文没有给出置信区间;本文的 Wilson 区间由本站计算,假设各次试验独立。仿真每格 10 次,所读文本没有说明训练种子数。
- 作者自述的局限:评测覆盖的任务时长有限,更长时程的移动操作有待验证;当前所用的 SONIC 全身控制器末端跟踪精度有限,使机器人示范采集更困难。
- 本站所读的论文文本止于附录 7.4 的时间配置一段,不含推理耗时、附录 8.3 的任务干扰讨论、附录 9.1 的真机任务细节和全部图片。
- 三项真机任务的少量成功试验不是硬件安全验证。


