
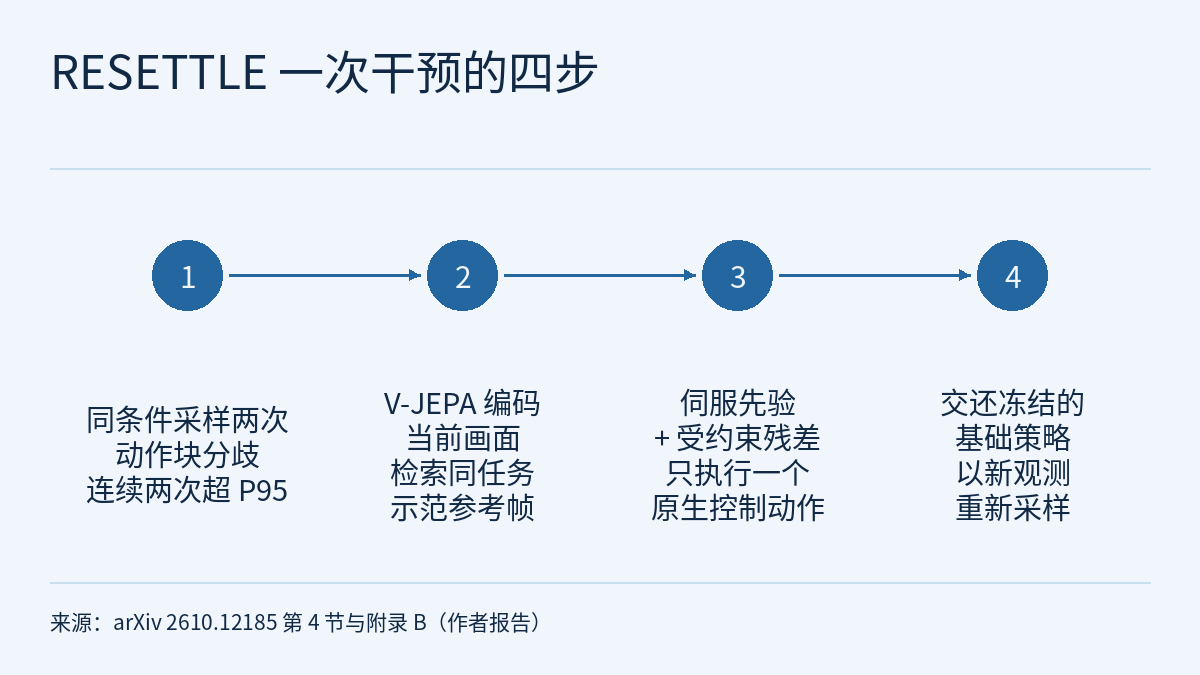
机器人策略在执行中走偏后,靠 VLM 反复判断或在线优化来纠正,可能带来可观的延迟。香港科技大学等机构的预印本 RESETTLE(arXiv 2610.12185,2026-10-08)把恢复放在冻结策略的动作执行接口上:同一观测下独立采样两个动作块,分歧连续两次超过阈值才介入;用改造过的 V-JEPA 2 编码器在同任务成功示范里检索最近的一帧,按“状态伺服先验 + 受约束的视觉残差”只执行一个控制动作,再把控制交还基础策略。作者报告,六个基础策略在 LIBERO-Plus、Meta-World 和 RoboCasa Tabletop 上的绝对成功率提升最高分别为 8.70、6.28、6.83 个百分点,真机四项任务也有提升;在 QwenPI 上测得的监测加恢复计算耗时为 83.6 ms。以下数字均为作者报告 [R],本站未复现。
论文把已有的恢复方法分为三类。第一类用额外监督训练纠错行为,如 DAgger 在学习者到达的状态上收集专家标签、IntervenGen 从人类干预生成恢复轨迹,都需要额外数据和策略更新。第二类由 VLM 监督恢复,如 Agentic Robot 用视觉验证触发纠正与重试、VoLoAgent 在策略执行和恢复工具之间切换,反复验证和恢复计算带来延迟。第三类在推理时修正动作而不改权重,如 LPB 和 VLA-Corrector,但依赖梯度引导,增加计算;作者还报告,在泛化的 VLA/WAM 上,LPB 用的专家特征距离在成功和失败执行之间重叠更大。RESETTLE 属于第三类,但不做梯度引导或在线轨迹优化,也不额外调用 VLM,并且不需要访问基础策略的内部表示。
何时介入:同一条件采样两次,分歧持续才算数
许多生成式策略用扩散或 flow matching 从噪声采样动作块,同一观测、同一指令下换一个噪声样本,得到的动作块可能不同。RESETTLE 在每个名义决策点用两个独立噪声样本生成两个动作块,按具体机器人定义的动作距离计算时间加权分歧,靠后动作的权重可以递减;对 GR1,γ = 0.8 使越早的动作权重越大。对笛卡尔动作的策略,距离只取平移分量的欧氏距离,不计旋转和夹爪;RoboCasa 的 GR1 则用全部 29 个归一化坐标(两臂各 7、两手各 6、腰部 3)上的差值平方计算距离。
阈值取该基础策略在训练数据上离线推理得到的分歧分数的第 95 百分位(P95),不使用评测结果;每个基础策略单独标定。LIBERO-Plus 用一个阈值覆盖全部扰动类型和任务,其余基准用全基准共享的阈值。连续两个决策点都超过阈值才触发,用来压掉单次采样的波动;没有触发时执行第一个样本,每次干预后计数清零。
作者给出的依据是:在 QwenPI 上,训练数据推理和成功执行的分歧集中在低分歧区,失败执行的尾部更重。按“连续两次超过 P95”的规则,在 LIBERO-Plus 七类扰动中,失败轨迹有 77.89%–100.00% 被触发,成功轨迹也有 9.22%–42.81% 被触发。作者的说法是:持续分歧有信息量,但不是确定的失败标签,所以设计成短暂纠正后重新观测。论文还报告,只用 5 条训练轨迹标定,得到的分歧分布与用 100 条或全部训练集时相近;单样本与双样本推理的实测延迟在所报告精度上相同,FastWAM 约 297 ms,QwenPI 约 109 ms,因此在这些实现里监测几乎不增加延迟。
怎么纠正:检索示范帧,伺服先验加受约束残差
触发后,改造过的编码器把当前画面映射成池化、归一化的表示,在同一任务的成功训练示范中按余弦距离找最近的一帧;这一帧同时提供参考画面和对应的机器人状态。没有同任务参考时,控制留在基础策略手里。编码器是约 1B 参数的 ViT-g/16,从在 DROID 上做过动作条件预训练的 V-JEPA 2-AC 检查点初始化,再在专家示范上用残差动作监督、动态预测等目标联合训练;部署时动态预测器不运行。LIBERO-Plus、Meta-World、RoboCasa 和真机各训练一个恢复模块,在同一设置的多个基础策略之间共用。
纠正动作分两部分。从当前状态到参考状态的位移,在原生控制坐标中给出一个有界的 state-servo prior(状态伺服先验);视觉残差头以当前与参考画面的表示、机器人状态、上一步动作和这个先验为条件,对先验做调整。守卫(guard)要求残差与先验的余弦相似度不低于下限、残差与先验的范数比不超过上限,LIBERO 上平移和旋转分开检查。通过的残差加到先验上,再裁剪到原生指令限幅;不通过就只执行有界的伺服动作。每次干预都丢弃基础策略尚未执行的动作,只执行一个原生控制步,然后以新观测交还基础策略。
作者在附录中写明:示范参考是成功行为的经验锚点,不保证物理上可达,也不定义基础策略完整的可行范围。
成功率:三个仿真基准、分层规划与真机
每组对比使用相同的冻结权重、相同的评测条件和执行预算,差值是两个百分数的绝对差(百分点)。LIBERO-Plus 共 10,030 个用例、七类扰动,三个基础策略都在标准 LIBERO 上训练,未额外微调,均值按各类用例数加权;Meta-World 为全部 50 个任务、每任务 10 回合,共 500 回合,均值是四个难度组成功率的不加权平均;RoboCasa 为 24 个任务的 GR1 Tabletop 套件;LIBERO-Pro Swap 为 10 个任务 × 10 个种子的同一组 100 次试验。
| 基准 | 基础策略 | 基线(%) | +RESETTLE(%) | 差(百分点) |
|---|---|---|---|---|
| LIBERO-Plus | FastWAM | 49.3 | 58.0 | +8.7 |
| LIBERO-Plus | π0.5 | 70.0 | 73.7 | +3.7 |
| LIBERO-Plus | QwenPI | 80.2 | 84.6 | +4.4 |
| Meta-World | QwenPI | 60.66 | 65.99 | +5.33 |
| Meta-World | SmolVLA | 59.20 | 65.48 | +6.28 |
| RoboCasa Tabletop | LDA | 50.33 | 52.42 | +2.09 |
| RoboCasa Tabletop | QwenGR00T | 53.67 | 60.50 | +6.83 |
| LIBERO-Pro Swap | π0.5 | 15.00 | 24.00 | +9.00 |
| LIBERO-Pro Swap | GPT-5.5 + π0.5(Harness VLA) | 42.00 | 50.00 | +8.00 |
LIBERO-Plus 上提升最大的是机器人初始位姿扰动:FastWAM、π0.5、QwenPI 分别 +16.7、+17.8、+21.4 个百分点;π0.5 和 QwenPI 在光照扰动下各降 0.2 个百分点。只用伺服先验、不加残差时,三者的总成功率为 55.9%、72.9%、83.1%,加上受约束残差后为 58.0%、73.7%、84.6%。论文表 1 上半部分 OpenVLA 等基线的数字取自各自论文,不是本文的配对评测。
LIBERO-Pro Swap 的后两行来自 Harness VLA:GPT-5.5 规划器根据指令、观测和记忆协调执行,π0.5 负责局部操作,RESETTLE 加在底层策略的动作执行接口上。作者据此认为局部纠正与高层规划可以互补。
真机:Franka Research 3 上的四项任务
真机实验用 Franka Research 3 和外部、腕部相机,基础策略是 QwenPI 和 VLAct(都用 Qwen3-VL 骨干),两者共用一个真机恢复模块,阈值各自标定。每种配置每个任务 20 次,初始臂型和物体布局随机,共 320 次。
| 任务(指标) | QwenPI 基线 | QwenPI +RESETTLE | VLAct 基线 | VLAct +RESETTLE |
|---|---|---|---|---|
| Press-button(成功率) | 90 | 100 | 90 | 100 |
| Cube-up(成功率) | 55 | 70 | 85 | 90 |
| Carrot-in-pot(成功率) | 85 | 95 | 90 | 95 |
| Use Spoon(阶段完成度) | 36.7 | 50 | 80 | 86.7 |
| 四项平均 | 66.67 | 78.75 | 86.25 | 92.92 |
前三项是二元成功率,Use Spoon 是长程任务的归一化阶段完成度,“四项平均”把两种指标直接平均。每任务 20 次时,一次试验对应 5 个百分点(本站换算):VLAct 在 Cube-up 和 Carrot-in-pot 上的 5 个百分点提升,各相当于 20 次里多成功 1 次。本站所读的正文没有给出真机结果的置信区间。
延迟:83.6 ms 衡量的是计算,不是响应时间
论文表 6 在 QwenPI 上实现几种方法并测量;论文写明本地的策略与恢复推理在 NVIDIA RTX 4090D 上运行。“监测”指超出名义策略推理的额外耗时;“合计”是监测加恢复,不含名义推理、轮询延迟和物理执行。两种智能体方法都用 Qwen3-VL-4B-Instruct 做监测;LPB 是作者在自己的 QwenPI+V-JEPA 框架里改写的版本。
| 方法 | 监测(ms) | 恢复(ms) | 合计(ms) | 相对 RESETTLE |
|---|---|---|---|---|
| RESETTLE | ≈ 0.0 | 83.6 | ≈ 83.6 | 1.0× |
| Agentic Robot | 107.0 | 109.0 | 216.0 | 2.6× |
| VoLoAgent | 107.0 | 215.0–1193.0 | 322.0–1300.0 | 3.9–15.6× |
| LPB(作者改写) | 56.2 | 423.5 | 479.7 | 5.7× |
合计耗时比 Agentic Robot 低 61.30%,比改写的 LPB 低 82.57%,比 VoLoAgent 的放置与抓取分支低 74.04%–93.57%;VoLoAgent 区间的下限是放置分支,上限是抓取分支。几种方法的产出不同:RESETTLE 一次产出一个动作,VoLoAgent 准备一段轨迹。作者也写明,RESETTLE 只在名义决策点检查,响应受决策频率和“连续两次超阈值”规则限制;表中的合计衡量的是计算,不是端到端的响应时间。
和站内已有内容的关系
课程物理AI实验室 1.6:模仿学习讲过,行为克隆的误差会累积,让机器人滚出示范覆盖的范围。RESETTLE 针对的正是这类状态,但不重新训练策略:它在运行时把“分歧持续偏高”当作可能进入陌生状态的信号,再把机器人朝最近的示范状态推一步。前沿雷达专题|仿真与评测介绍的恢复基准衡量策略本身能否从偏差中恢复;RESETTLE 则是在策略之外加一个恢复模块,一个是评测,一个是方法。
读它的评测时有两点可以对照。RESETTLE 用的 LIBERO-Plus,与前沿雷达|Is Success All You Need?用的是同一个扰动基准;那篇文章提醒,成功率相近不等于成功轨迹相同,而 RESETTLE 只报告成功率,本站所读的正文没有报告纠正后轨迹的时长或平滑度。物理AI实验室 1.8:评测讲过一个总数会把变好和变坏抵消掉;RESETTLE 的触发统计显示成功轨迹也会被干预,本站所读的正文没有给出逐对的变好、变坏数。
局限 / 注意
- 这是 arXiv 预印本,全部数字为作者报告 [R]。作者来自香港科技大学、香港中文大学、SmartMore、哈尔滨工业大学(深圳)与 Shenzhen Loop Area Institute。本站没有复现任何结果;论文称代码已公开,本站没有核对。
- 分歧衡量的是动作选择是否不稳定,不直接检验物理可行性或任务是否正确。论文写明:策略给出一致的动作时,空间或指令理解错误可能不会触发干预;触发后也可能因物理状态无法解决或目标不匹配而恢复失败。
- 守卫只限制残差相对先验的方向和大小。作者说结果支持视觉修正,但不证明能避免碰撞;仿真结果和 320 次真机试验都不是硬件安全验证。
- 恢复依赖同任务的成功示范和任务标识,没有参考时不干预;恢复模块按设置分别训练,换任务或换机器人需要相应的示范数据。
- 成功轨迹在各类扰动中有 9.22%–42.81% 被触发。本站所读的论文 HTML 正文止于附录 B,不含附录 C–E 中的训练细节、触发统计、消融、延迟细节和失败案例。
- 真机每任务 20 次,正文没有给出置信区间,“四项平均”混合了两种指标。延迟只在基于 QwenPI 的实现上测得(论文写明本地推理用 RTX 4090D),对比方法是作者的实现或改写。
链接
- RESETTLE: Robotic Recovery through Disagreement-Triggered Retrieval and Efficient Corrective Control(arXiv 2610.12185)
- 论文 HTML 全文
- 物理AI实验室 1.6:模仿学习,手算误差怎样滚出示范覆盖范围,再把 ACT、扩散策略与数据规模律的数字放回各自条件
- 物理AI实验室 1.8:评测,把“净增 2”拆成配对表,再给失败标签和随机种子算一笔账
- 前沿雷达专题|仿真与评测:VLA 评测在初始状态成功率之外缺了什么
- 前沿雷达|Is Success All You Need?:成功率相近的两个 VLA,成功轨迹可能差得很远
- 物理AI实验室:一套每个数字都能核对的物理 AI 课程(课程大纲)


