
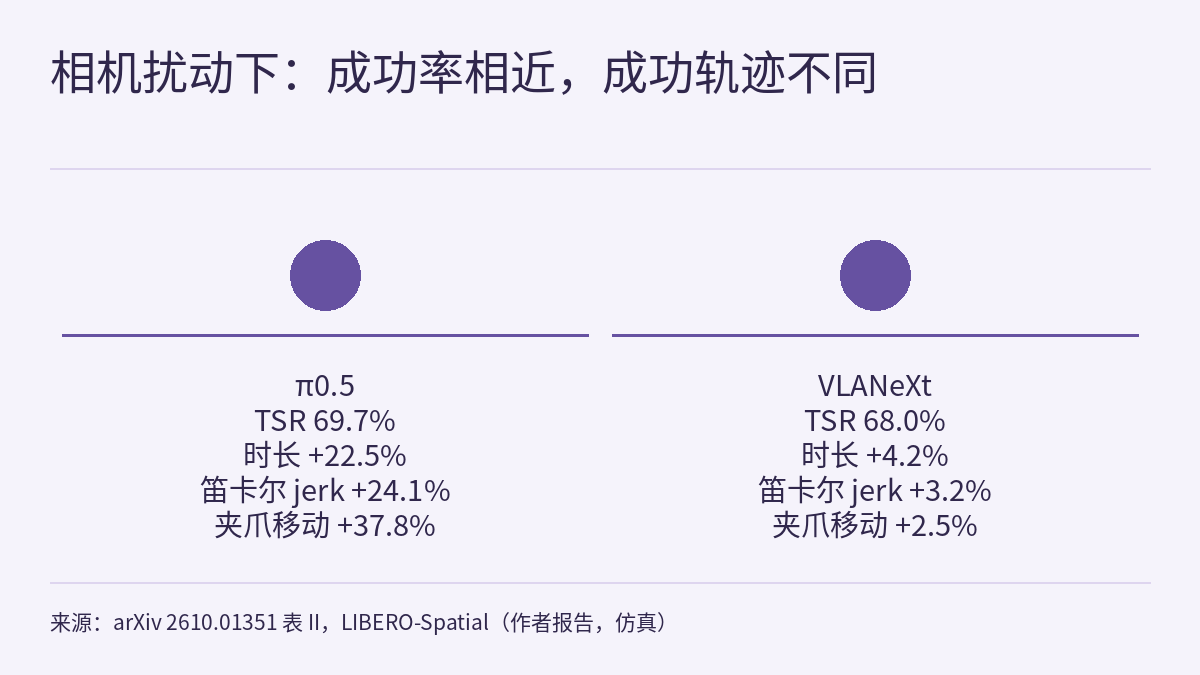
VLA 的鲁棒性评测大多只报一个数:扰动下的任务成功率(TSR)。爱丁堡大学与米兰理工大学团队的预印本 Is Success All You Need?(arXiv 2610.01351,2026-10-01)换了一个问法:任务算成功了,机器人是怎么完成的?作者在 LIBERO 与 LIBERO-Plus 上只看成功轨迹,比较扰动前后的时长、jerk、路径长度和夹爪动作。论文称,在 LIBERO-Spatial 的相机扰动下,π0.5 与 VLANeXt 的成功率分别为 69.7% 和 68.0%,但 π0.5 成功轨迹的时长、平均笛卡尔 jerk 和夹爪移动量分别增加 22.5%、24.1%、37.8%,VLANeXt 只增加 4.2%、3.2%、2.5%。以下数字均为作者报告 [R],全部来自仿真,本站未复现。
问题:成功率记录不到“掉了再捡”
论文图 1 是一个具体例子:π0.5 在 LIBERO-Spatial 的“拿起 ramekin 上的黑碗放到盘子上”任务中,加了 LIBERO-Plus 的相机视角扰动后,目标条件最终满足,但过程中碗掉了一次又被重新抓起。这条轨迹在 TSR 里算一次成功,变化只体现在平均笛卡尔 jerk 和累计夹爪移动量上。
作者的论证是:jerk 大意味着加速度变化剧烈,可能带来更大的机械应力和磨损;完成速度、可预测性也影响用户对机器人的信任。论文整理了已有工作:RoboEval、BEHAVIOR 报告了 TSR 之外的行为指标,但不做鲁棒性扰动;LIBERO-Plus、LIBERO-PRO、Colosseum V2 等做扰动,但仍以 TSR 下降来衡量。作者称,据他们所知,两者尚未被结合。
方法:只看成功轨迹,逐任务与无扰动基线比较
每条成功轨迹算出七个数:时长(按仿真器时间,不含推理延迟)、总夹爪移动量(两指位置之和的累计绝对变化)、平均与 P95 笛卡尔 jerk、平均关节 jerk、笛卡尔路径长度、关节路径长度。所有导数按仿真器 10 Hz 的控制频率计算。
- 典型行为:对每个任务,取扰动条件下成功轨迹某指标的均值,相对原始 LIBERO 基线算百分比变化;再取一个套件 10 个任务的中位数。另报告有几个任务出现显著增加(双侧 Mann-Whitney U 检验,按任务做 Benjamini-Hochberg FDR 校正,α = 0.05)。
- 一致性:对每个任务算中位绝对偏差(MAD),同样取相对基线的百分比变化的中位数;正值表示成功轨迹之间更分散。
实验覆盖 LIBERO-Spatial、-Long、-Goal、-Object 四个套件,以及 LIBERO-Plus 的七类扰动:物体布局、相机视角、机器人初始状态、语言指令、光照、背景纹理、传感器噪声。基线每个任务跑 50 次;扰动条件下每个变体跑 2 次(物体扰动只有一个初始状态)。模型是 π0.5、VLANeXt 和 OpenVLA-OFT,均使用在全部 LIBERO 套件上联合微调的检查点。OpenVLA-OFT 只评了 Spatial 套件,因为它在该套件七类扰动下的平均 TSR 已降到 67.9%,且 LIBERO-Plus 论文的结果显示 Goal 和 Long 套件会下降更多。评测基于开源的 vla-eval 框架,作者在其中增加了末端位置、关节位置和夹爪轨迹的输出。
结果:相机、初始状态和传感器扰动改变成功轨迹
作者报告,成功轨迹并不随扰动保持不变,影响最大的是相机、机器人初始状态和传感器噪声三类,且程度因模型而异。Spatial 套件的相机扰动下,π0.5 的平均笛卡尔 jerk 中位增加 24.1%(10 个任务中 7 个显著),OpenVLA-OFT 增加 35.3%(10/10)。VLANeXt 的变化总体较小。路径长度两项在扰动下变化很少。
成功率下降与行为变化有关,但不是一回事。作者在 63 个“模型 × 套件 × 扰动”组合上做 Spearman 秩相关,TSR 降幅与以下指标的变化呈中等正相关:总夹爪移动量 ρ = 0.56,P95 笛卡尔 jerk 0.54,时长 0.52,平均笛卡尔 jerk 0.43,平均关节 jerk 0.4。笛卡尔与关节路径长度的相关不显著(ρ = −0.03,p = 0.80;ρ = 0.2,p = 0.11)。中等相关意味着 TSR 能提示一部分行为变化,但不能替代行为指标。
成功率相近,行为变化可以相差数倍
论文最直接的证据是同一扰动下两个模型的对照(LIBERO-Spatial,相机视角扰动;数值为 10 个任务的中位百分比变化,括号内为显著增加的任务数):
| 模型 | TSR(成功 / 总数) | 时长 | 平均笛卡尔 jerk | 总夹爪移动量 |
|---|---|---|---|---|
| π0.5 | 69.7%(524/752) | +22.5%(10/10) | +24.1%(7/10) | +37.8%(9/10) |
| VLANeXt | 68.0%(511/752) | +4.2%(7/10) | +3.2%(5/10) | +2.5%(0/10) |
只看 TSR,两者几乎打平;看成功轨迹,π0.5 的执行明显变慢、变抖,夹爪开合更多。Long 套件上方向甚至相反:在背景、相机、初始状态和传感器四类扰动下,π0.5 的 TSR 都高于 VLANeXt,但平均笛卡尔 jerk、平均关节 jerk 和 P95 笛卡尔 jerk 的增幅每一类都更大。例如背景扰动下,π0.5 的 TSR 为 96.9%、VLANeXt 为 79.4%,P95 笛卡尔 jerk 分别增加 11.6% 和 6.2%。
课程物理AI实验室 0.6:怎么判断一条机器人新闻靠不靠谱,把每一问落回原文那一句的第三问是“成功率是在什么上”。这篇论文补了一个下一步:同一个成功率,背后可能是很不一样的执行过程。
一致性:有的扰动让成功更分散,有的反而更集中
作者报告,相机扰动在所有被评测的模型与套件上,都让时长、平均笛卡尔 jerk 和夹爪移动量的 MAD 增加:成功的执行不仅偏离基线,彼此之间也更不一致。背景、语言、光照和物体扰动则常常让 MAD 下降,例如 LIBERO-Goal 的光照扰动下,夹爪移动量的 MAD 对 π0.5 下降 28%,对 VLANeXt 下降 21%。
作者给了两种可能的解释,并说明尚未区分:一是选择效应,扰动让“抓失后恢复”这类较长、较抖的轨迹更容易失败,剩下的成功轨迹偏向干净直接的那一类;二是扰动本身让策略的反应范围变窄。这一点对读数很重要:只对成功轨迹算指标时,扰动同时改变了“哪些轨迹被算进来”,MAD 变小不能直接读成“更稳定”。
放进自己的评测:TSR 旁边多写几列
以下是本站据论文方法整理的做法,不是论文给出的操作清单。前提是评测框架能导出每一步的末端位置、关节位置和夹爪状态(论文称 LIBERO 之外,MetaWorld 这类能取回轨迹级状态和动作的基准也适用)。
- 在 TSR 旁边同时报告成功数和总数,因为行为指标的样本量随成功率变化。
- 只在成功轨迹上逐任务算时长、jerk、夹爪移动量,与同一任务的无扰动基线比较,再跨任务取中位数并标出显著任务数。
- 单独报告变异性(如 MAD),并考虑上文的选择效应。
- 比较两个模型时,先找 TSR 相近的条件,再看行为指标是否分开。
与 前沿雷达|Beyond Binary Success:真机评测次数有限时,用序贯检验更早分出策略优劣 不同,那篇关注的是用更少的评测次数在统计上分出两个策略的优劣;这一篇关注的是成功本身的质量。两者可以互补。更多评测问题见 前沿雷达专题|仿真与评测:VLA 评测在初始状态成功率之外缺了什么,课程的整体安排见 物理AI实验室:一套每个数字都能核对的物理 AI 课程。
局限 / 注意
- arXiv 预印本,属 R 级;所有数字为作者报告,本站没有复现。
- 全部实验在 LIBERO / LIBERO-Plus 仿真中进行;作者明确说明,这些行为效应能否延伸到真机部署还有待验证。
- 只分析成功轨迹,失败轨迹不在范围内。完整评测只做了 π0.5 和 VLANeXt;OpenVLA-OFT 只有 Spatial 套件的结果,不能与另两个模型在其他套件上比较。
- 指标是通用、与任务无关的,语义不具体:夹爪移动量增加可能对应反复抓取或掉落重抓,但要确认这类事件需要针对任务的分析。
- 时长用仿真器时间,刻意不含推理延迟;作者指出,若改用挂钟时间,可能对更小或更快的模型有利。
- 表中百分比是“任务内均值变化”跨 10 个任务的中位数,不是单条轨迹的变化,也不能直接换算成磨损或安全风险。
- 论文称已把评测框架集成进 vla-eval,并在脚注给出代码仓库;本文没有核对该代码。
链接
- Is Success All You Need? Investigating the Impact of Input Perturbations on VLA Behaviour in Tabletop Manipulation Tasks(arXiv 2610.01351)
- arXiv 2610.01351 HTML 全文(表 II、表 III)
- 物理AI实验室 0.6:怎么判断一条机器人新闻靠不靠谱,把每一问落回原文那一句
- 前沿雷达|Beyond Binary Success:真机评测次数有限时,用序贯检验更早分出策略优劣
- 前沿雷达专题|仿真与评测:VLA 评测在初始状态成功率之外缺了什么
- 物理AI实验室:一套每个数字都能核对的物理 AI 课程


