
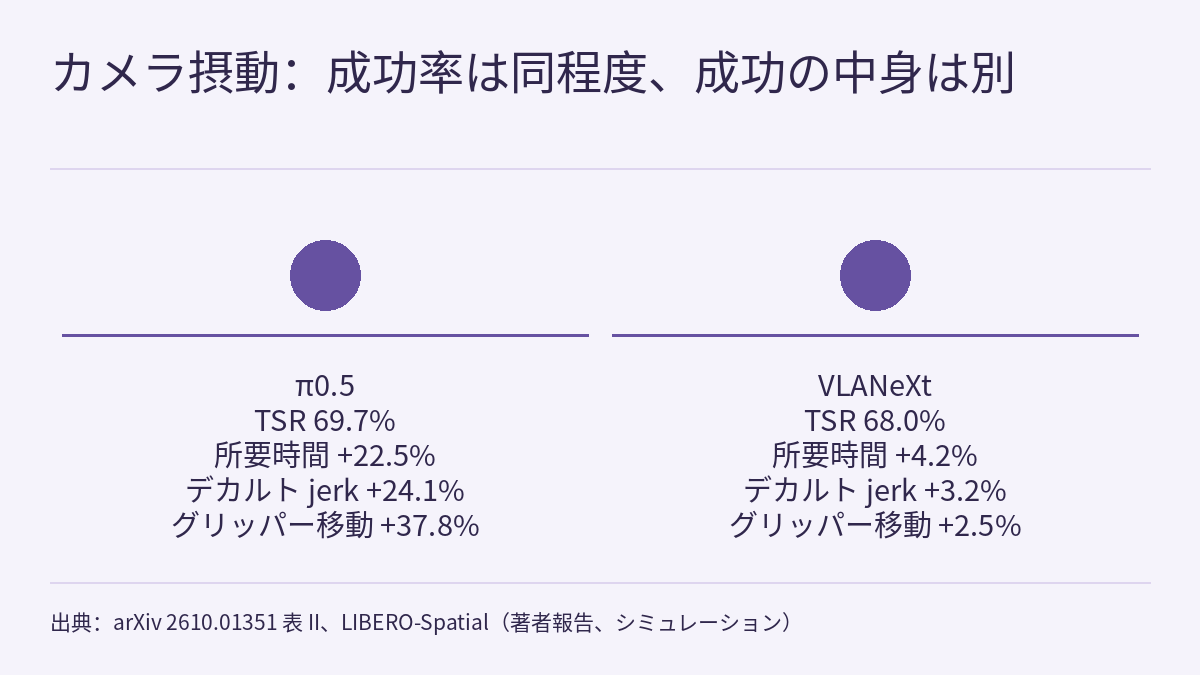
VLA のロバスト性評価の多くは、摂動下のタスク成功率(TSR)という 1 つの数字だけを報告します。エディンバラ大学とミラノ工科大学のチームによるプレプリント Is Success All You Need?(arXiv 2610.01351、2026-10-01)は、別の問いを立てます。タスクが成功と判定されたとき、ロボットはどのようにそれを達成したのか。著者らは LIBERO と LIBERO-Plus で成功した軌道だけを取り出し、摂動の前後で所要時間、jerk、経路長、グリッパーの動きを比較しました。論文によると、LIBERO-Spatial のカメラ摂動下で π0.5 と VLANeXt の成功率はそれぞれ 69.7% と 68.0% ですが、π0.5 の成功軌道では所要時間、平均デカルト jerk、グリッパー移動量がそれぞれ 22.5%、24.1%、37.8% 増え、VLANeXt では 4.2%、3.2%、2.5% の増加にとどまりました。以下の数字はすべて著者報告 [R] で、いずれもシミュレーションによるものです。本サイトでは再現していません。
問題:成功率には「落として拾い直した」が記録されない
論文の図 1 に具体例があります。LIBERO-Spatial の「ramekin の上の黒いボウルを取って皿に置く」タスクで、LIBERO-Plus のカメラ角度摂動を加えた π0.5 は最終的にゴール条件を満たしますが、途中でボウルを一度落とし、つかみ直しています。この軌道は TSR では 1 回の成功として数えられ、変化は平均デカルト jerk と累積グリッパー移動量にしか現れません。
著者らは、jerk が大きいことは加速度の急変を意味し、機械的な負荷や摩耗の増加につながりうること、また完了の速さや予測可能性はユーザーがロボットをどこまで信頼するかに影響することを論拠にしています。論文は先行研究を整理し、RoboEval や BEHAVIOR は TSR 以外の行動指標を報告するもののロバスト性の摂動は扱わず、LIBERO-Plus、LIBERO-PRO、Colosseum V2 などは摂動を加えるものの依然として TSR の低下で測っている、としています。著者らの知る限り、両者はまだ組み合わされていないと述べています。
方法:成功軌道だけを、タスクごとに摂動なしのベースラインと比べる
成功軌道 1 本ごとに 7 つの値を計算します。所要時間(シミュレーター時間で、推論レイテンシを含まない)、総グリッパー移動量(2 本の指の位置の和の累積絶対変化)、平均と P95 のデカルト jerk、平均関節 jerk、デカルト経路長、関節経路長です。微分はすべてシミュレーターの制御周波数 10 Hz で計算しています。
- 典型的な行動:タスクごとに、摂動条件での成功軌道の指標平均を求め、元の LIBERO ベースラインからの変化率を計算します。そのうえでスイート内 10 タスクの中央値を取ります。あわせて、有意な増加が見られたタスク数も報告します(両側 Mann-Whitney U 検定、タスク間で Benjamini-Hochberg の FDR 補正、α = 0.05)。
- 一貫性:タスクごとに中央絶対偏差(MAD)を計算し、同じくベースラインからの変化率の中央値を報告します。正の値は成功軌道どうしのばらつきが大きくなったことを示します。
実験は LIBERO-Spatial、-Long、-Goal、-Object の 4 スイートと、LIBERO-Plus の 7 種類の摂動(物体配置、カメラ視点、ロボット初期状態、言語指示、照明、背景テクスチャ、センサーノイズ)を対象にしています。ベースラインは各タスク 50 回、摂動条件は各バリアント 2 回実行しました(物体摂動は初期状態が 1 つだけ)。モデルは π0.5、VLANeXt、OpenVLA-OFT で、いずれも全 LIBERO スイートで同時にファインチューニングしたチェックポイントを使っています。OpenVLA-OFT は Spatial スイートだけで評価しました。同スイートの 7 種類の摂動での平均 TSR がすでに 67.9% まで下がっており、LIBERO-Plus 論文の結果から Goal と Long ではさらに低下すると見込まれたためです。評価はオープンソースの vla-eval ハーネスを基盤とし、著者らはエンドエフェクター位置、関節位置、グリッパーの軌道を出力するよう拡張しました。
結果:カメラ、初期状態、センサーの摂動が成功軌道を変える
著者らは、成功軌道は摂動に対して不変ではなく、影響が大きいのはカメラ、ロボット初期状態、センサーノイズの 3 種類で、その程度はモデルによって異なると報告しています。Spatial スイートのカメラ摂動では、π0.5 の平均デカルト jerk は中央値で 24.1% 増(10 タスク中 7 タスクで有意)、OpenVLA-OFT は 35.3% 増(10/10)でした。VLANeXt の変化は全体に小さめでした。2 つの経路長は摂動によってほとんど変わりませんでした。
成功率の低下は行動の変化と関係していますが、同じものではありません。著者らは「モデル × スイート × 摂動」の 63 通りの組み合わせで Spearman の順位相関を計算し、TSR の低下幅と、総グリッパー移動量(ρ = 0.56)、P95 デカルト jerk(0.54)、所要時間(0.52)、平均デカルト jerk(0.43)、平均関節 jerk(0.4)の変化との間に中程度の正の相関を見いだしました。デカルト経路長と関節経路長の相関は有意ではありませんでした(ρ = −0.03、p = 0.80;ρ = 0.2、p = 0.11)。中程度の相関ということは、TSR は行動の変化の一部を示唆するものの、行動指標の代わりにはならないということです。
成功率は同程度でも、行動の変化は数倍違う
論文で最も直接的な証拠は、同じ摂動下での 2 モデルの比較です(LIBERO-Spatial、カメラ視点摂動。値は 10 タスクの変化率の中央値、括弧内は有意な増加が見られたタスク数)。
| モデル | TSR(成功数 / 総数) | 所要時間 | 平均デカルト jerk | 総グリッパー移動量 |
|---|---|---|---|---|
| π0.5 | 69.7%(524/752) | +22.5%(10/10) | +24.1%(7/10) | +37.8%(9/10) |
| VLANeXt | 68.0%(511/752) | +4.2%(7/10) | +3.2%(5/10) | +2.5%(0/10) |
TSR だけを見れば両者はほぼ互角ですが、成功軌道を見ると、π0.5 の実行は明らかに遅く、ぎくしゃくし、グリッパーの開閉も増えています。Long スイートでは順位が逆転することさえあります。背景、カメラ、初期状態、センサーの 4 種類の摂動すべてで π0.5 の TSR は VLANeXt より高いのに、平均デカルト jerk、平均関節 jerk、P95 デカルト jerk の増加幅はいずれの場合も π0.5 のほうが大きくなっています。たとえば背景摂動では、TSR は π0.5 が 96.9%、VLANeXt が 79.4% で、P95 デカルト jerk はそれぞれ 11.6% と 6.2% 増えました。
講座 フィジカルAIラボ 0.6:ロボットのニュースをどう見分けるか――それぞれの問いを原文の一文まで戻す の 3 つ目の問いは「成功率は何に対するものか」でした。この論文はその次の一歩を加えます。同じ成功率の裏に、まったく異なる実行が隠れていることがあります。
一貫性:成功がばらつく摂動もあれば、逆に揃う摂動もある
著者らによると、カメラ摂動は評価したすべてのモデルとスイートで、所要時間、平均デカルト jerk、グリッパー移動量の MAD を増やしました。成功した実行はベースラインから離れただけでなく、互いの一貫性も下がったことになります。一方、背景、言語、照明、物体の摂動では MAD が下がることが多く、たとえば LIBERO-Goal の照明摂動では、グリッパー移動量の MAD が π0.5 で 28%、VLANeXt で 21% 減少しました。
著者らは 2 つの可能な説明を挙げ、まだ区別できていないとしています。1 つは選択効果で、摂動によって「つかみ損ねてから回復する」ような長くぎくしゃくした軌道が失敗しやすくなり、残った成功軌道がすっきりした直接的なものに偏るという説明です。もう 1 つは、摂動そのものが方策の反応の幅を狭めるという説明です。これは読み方に関わります。成功軌道だけで指標を計算する場合、摂動は「どの軌道が数えられるか」も変えるため、MAD が小さくなったことをそのまま「安定した」と読むことはできません。
自分の評価に取り入れる:TSR の横に列を足す
以下は論文の方法を本サイトが整理した手順で、論文が示したチェックリストではありません。評価ハーネスが各ステップのエンドエフェクター位置、関節位置、グリッパー状態を出力できることが前提です(論文によると、LIBERO 以外でも MetaWorld のように軌道レベルの状態と行動を取得できるベンチマークなら適用できます)。
- TSR の横に成功数と総数を併記します。行動指標のサンプル数は成功率によって変わるためです。
- 成功軌道だけでタスクごとに所要時間、jerk、グリッパー移動量を計算し、同じタスクの摂動なしベースラインと比べてから、タスク間の中央値を取り、有意なタスク数を示します。
- ばらつき(たとえば MAD)は別に報告し、上で述べた選択効果を考慮します。
- 2 つのモデルを比べるときは、まず TSR が近い条件を探し、そこで行動指標に差が出るかを確認します。
フロンティア・レーダー|Beyond Binary Success:実機試行が限られるなか、逐次検定で方策の優劣を早く見分ける は、より少ない評価回数で 2 つの方策の優劣を統計的に見分ける話でした。今回の論文は成功そのものの質を扱っており、両者は補い合えます。評価の課題については フロンティア・レーダー特集|シミュレーションと評価:VLA の評価に初期状態成功率以外で欠けているもの、講座全体の構成は フィジカルAIラボ:すべての数字を確認できるフィジカルAI講座 をご覧ください。
制約と注意点
- arXiv のプレプリントで、証拠レベルは R です。数字はすべて著者報告で、本サイトでは再現していません。
- 実験はすべて LIBERO / LIBERO-Plus のシミュレーションで行われています。これらの行動への影響が実機での運用にも当てはまるかは今後の検証課題だと、著者ら自身が明記しています。
- 分析対象は成功軌道だけで、失敗軌道は範囲外です。完全な評価は π0.5 と VLANeXt だけで、OpenVLA-OFT は Spatial スイートの結果しかなく、ほかのスイートでは 2 モデルと比較できません。
- 指標は汎用的でタスクに依存しないため、意味は具体的ではありません。グリッパー移動量の増加はつかみ直しや落下後の再把持に対応する可能性がありますが、そうした事象を確かめるにはタスク固有の分析が必要です。
- 所要時間はシミュレーター時間で、推論レイテンシを意図的に含めていません。著者らは、実時間(ウォールクロック時間)を使うと小型・高速なモデルに有利になりうると注記しています。
- 表の変化率は「タスク内平均の変化」の 10 タスクにわたる中央値で、1 本の軌道の変化ではありません。摩耗や安全上のリスクに直接換算することもできません。
- 論文は評価フレームワークを vla-eval に統合したと述べ、脚注でコードリポジトリを示していますが、本記事ではそのコードを確認していません。
リンク
- Is Success All You Need? Investigating the Impact of Input Perturbations on VLA Behaviour in Tabletop Manipulation Tasks(arXiv 2610.01351)
- arXiv 2610.01351 HTML 全文(表 II、表 III)
- フィジカルAIラボ 0.6:ロボットのニュースをどう見分けるか――それぞれの問いを原文の一文まで戻す
- フロンティア・レーダー|Beyond Binary Success:実機試行が限られるなか、逐次検定で方策の優劣を早く見分ける
- フロンティア・レーダー特集|シミュレーションと評価:VLA の評価に初期状態成功率以外で欠けているもの
- フィジカルAIラボ:すべての数字を確認できるフィジカルAI講座


