ナビゲーション世界モデルは、ロボットが動く前に候補軌道ごとの未来の画像を予測し、その結果をもとに軌道を選べます。ただし候補が多いと、候補ごとに RGB の未来を生成する計算が主なコストになります。南京大学、インペリアル・カレッジ・ロンドン、Sony AI、北京郵電大学の著者によるプレプリント LiteNWM(arXiv 2610.12368、2026-10-08)は、「ナビゲーション方策が候補を出し、世界モデルが評価する」という分担を保ったまま、評価を潜在空間に移します。決定状態ごとに画像を 1 回だけ符号化し、16 本の候補と現行軌道 τ0 について今後 4 ステップの特徴を一度に同時予測し、学習した採点器が現在の軌道と比べて切り替えるかどうかを決めます。著者報告では、オフラインのマクロ平均軌道誤差は NoMaD+NWM-XL より 17.56% 低く、RTX 5090 ではエンドツーエンドで 128.00 倍高速です。Unitree Go2 EDU の実機では、ナビゲーション成功率が NoMaD の 43.3% から 83.3% に上がりました。以下の数字はすべて著者報告 [R] で、本サイトでは再現していません。最初に注意しておくと、128 倍はワークステーション GPU での計時です。ロボット搭載の Jetson Orin では、LiteNWM の計画 1 回あたりの平均は 2.228 s で、NoMaD 単体より遅くなります。
ボトルネック:候補ごとに RGB の未来を生成する
GNM、ViNT、NoMaD などの汎用ナビゲーション方策は、大規模で多様なロボットデータから目標条件付きナビゲーションを学習します。NoMaD は拡散デコーダーを使い、観測ごとにもっともらしい軌道を複数サンプルできます(拡散方策が複数の正しいやり方を保てる理由は フィジカルAIラボ 1.6 を参照)。著者が指摘する問題は、これらの方策が軌道を選ぶときに、その先の結果を明示的に評価していないことです。
Navigation World Models(NWM、Bar ら、CVPR 2025)は候補ごとに未来の RGB 観測を予測し、予測結果で選択します。著者は「予測した未来にもとづく軌道の再順位付け」と「提案器と評価器を分けるインターフェース」をはっきり先行研究と位置づけています。LiteNWM が扱うのはより狭い問いで、短いホライズンの候補を、候補ごとに RGB を再構成せず、行動条件付きの潜在特徴で直接比べられるかどうかです。
著者は RTX 5090、RECON-100、予測ホライズン H = 4、候補数 K = 16 の条件で構成要素ごとの遅延を測りました。候補ごとの CDiT ロールアウトが、NoMaD+NWM-S の遅延の 84.8%、NoMaD+NWM-XL の 97.6% を占めます。本サイトで以前紹介した Token-World もコンパクトな特徴空間で展開し RGB を生成しませんが、目的は VLA 方策の成功率をシミュレーションで評価することです。LiteNWM はナビゲーションの各決定点で軌道を選ぶために使われます。
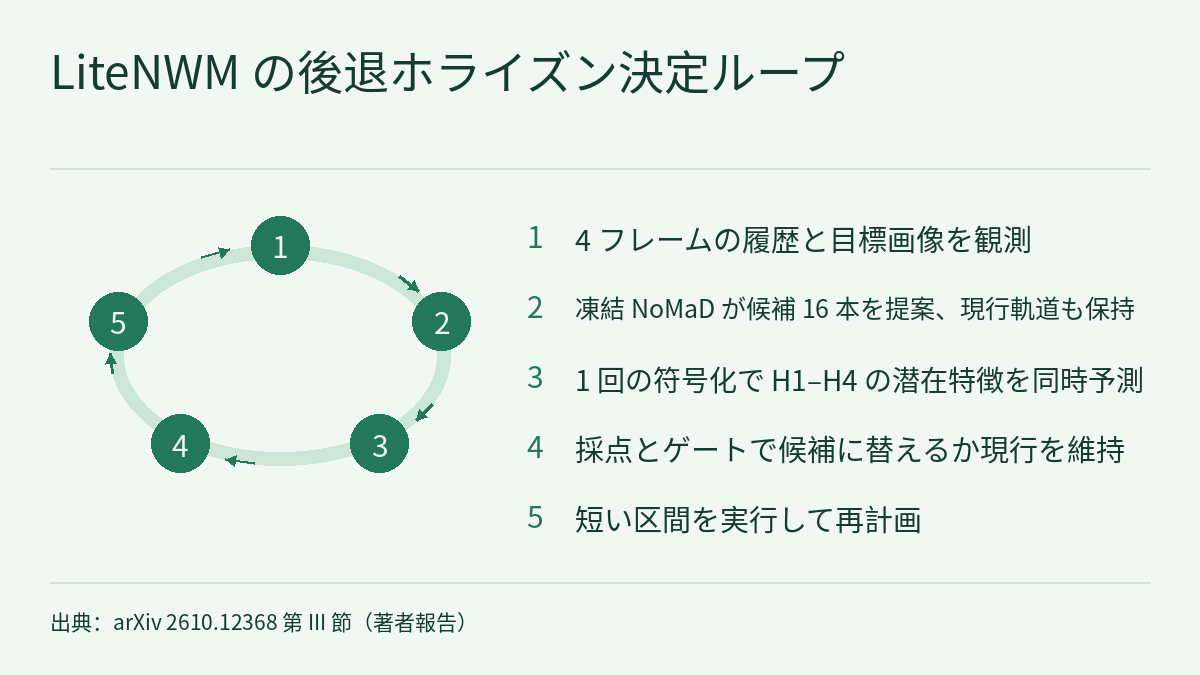
手法:符号化は 1 回、4 ステップを同時に予測し、現行軌道と比べて採点する
- 提案。凍結した NoMaD が、4 フレームの観測履歴と 1 枚の目標画像から K = 16 本の 4 ステップ候補(論文では challenger)を出し、NoMaD の決定論的な出力を現行軌道 τ0(incumbent)として保持します。K に τ0 は含まれません。各候補は決定論的な変換で、ステップごとの [Δx, Δy, Δψ] として表されます。
- 共有の符号化。凍結した DINOv3 エンコーダーと軽量なアダプターが、状態ごとに 1 回だけ履歴と目標を符号化し、全候補で共有します。
- 同時予測。行動エンコーダーが SE(2) 積分で各ステップの累積姿勢を求め、姿勢条件付きのワーピングでクエリを初期化し、6 つの分解ブロックで精緻化して、H1–H4 の 4 つのホライズンの未来潜在特徴を一度に出力します。ホライズン間の自己回帰的なフィードバックはありません。予測器は目標を入力にとらず、実際の未来画像を凍結した DINOv3 とアダプターで変換した特徴で教師付けされます。
- 採点と受け入れゲート。採点器は、予測した未来、現在の状態、目標特徴、候補集合全体の文脈を組み合わせ、各候補の τ0 に対する ATE、RPE、FDE、および複合指標 J(J = 0.4 ATE + 0.6 FDE)の変化量を予測します。予測器と採点器はそれぞれ 3 メンバーのアンサンブルで、平均に z 倍の標準偏差を加えた保守的な推定を使います。候補が選ばれる資格を得るのは、物理的チェックと提案分布のチェックを通り、ATE と J の保守的推定がともに下がり、「両方改善」の確率が十分高く、「悪化」の確率が十分低い場合だけです。資格のある候補がなければ τ0 を維持します。オフラインの既定構成ではさらに CEM による精緻化を 1 回行います(CEM1)。
- 実行。後退ホライズン方式です。制御周期ごとに観測、提案、予測、選択を行い、選んだ軌道の短い区間を実行してから再計画します。展開時はすべての構成要素が凍結されたままで、NoMaD もファインチューニングしません。
別のナビゲーション方策 MBRA に替える場合は、決定論的なアダプターが MBRA の出力を同じ 4 ステップの行動表現に写すだけで、提案器に合わせた再学習や再較正は行いません。
オフライン:誤差の低下と、アブレーション・ゲートが示すこと
オフライン評価には RECON、SCAND、SACSoN の 3 データセットの固定開発コホートを使います。各 100 クエリ状態に 4 つの提案シードを組み合わせ、計 1,200 回の状態–シード評価です。すべての手法が同じ 16 本の NoMaD 候補から出発します。誤差は各データセットの平均ウェイポイント間隔で正規化されています。3 ドメインのマクロ平均 ATE は NoMaD+NWM-XL が 0.5538、LiteNWM(CEM1)が 0.4566 で、17.56% の低下です。ドメイン別では 25.21%(RECON)、14.98%(SCAND)、14.71%(SACSoN)低下しました。SR@1 は NoMaD+NWM-XL より 6.5、3.5、7.0 ポイント高くなっています。著者は、SR@1 がオフラインでの終点の一致(正規化 FDE ≤ 1)を測るもので、閉ループのナビゲーション成功ではないと明記しています。
比較の公平性については著者自身も注意を書いています。NWM の MPC/CEM と最終フレームの目的関数は 8 ステップのロールアウト向けに設計されており、H = 4 に合わせると効果が制限される可能性があります。絶対誤差も、長さ 8 の軌道を使う NWM の元論文の結果とは直接比べられません。
アブレーションでは、固定した 16 本の候補の上で予測特徴を入れ替え、それぞれに合わせて採点器を学習しています(3 ドメインのマクロ平均、低いほどよい)。これは診断用の設定で、上の CEM1 既定構成の 0.4566 とは同じ設定ではありません。
| 変種 | ATE | RPE | FDE |
|---|---|---|---|
| 予測した未来を使わない | 0.4790 | 0.2596 | 0.6743 |
| 現在の DINO 特徴を繰り返す | 0.4803 | 0.2610 | 0.6763 |
| 予測した H4 のみ | 0.4662 | 0.2529 | 0.6500 |
| 予測した H1–H4 | 0.4431 | 0.2316 | 0.6440 |
| H1–H4、候補と未来の対応をずらす | 0.4925 | 0.2672 | 0.6996 |
- 予測した未来は 2 つの対照より優れています。候補と予測未来の対応をずらすと、マクロ平均 ATE は 0.0294 増えます(95% 対応クラスター・ブートストラップ区間 [0.0175, 0.0415])。著者はこれを、採点器が各候補と正しく対応した予測を使っている根拠としています。
- 著者は、利得の大部分は H4 で得られ、中間のホライズンが加える改善は小さいと書いています。付録では別のグループ分けで「H4 のみ − H1–H4」の ATE 差が +0.0031、95% 区間 [−0.0014, 0.0065] でゼロをまたいでおり、この分析では中間ホライズンによる上積みは確認されていません。
- 受け入れゲートの診断は過去の CEM3 構成で行われました。ゲートは有害な置き換えの率を 23.00% から 9.92% に下げ、置き換えのカバー率を 100% から 64.83% に下げます。一方、「ゲートなし − ゲートあり」のマクロ平均 ATE 差は −0.00409、95% 区間 [−0.00912, 0.00076] でゼロを含みます。ゲートの効果は主に有害な置き換えを減らすことで、平均誤差を下げることは示されていません。
- 固定候補プールでは、98.42% の状態–シードの組で現行軌道より ATE が低い候補が存在しました。LiteNWM の選択は 49.75% で ATE を下げ、8.42% で上げ、41.83% で現行軌道を維持しました。
同じ凍結済みの評価器を MBRA につなぐと、3 ドメインのマクロ平均 ATE は 0.600 から 0.503 へ 16.2% 下がりました。ドメイン別では 6.9%、23.0%、16.8% です。
2 種類の計時:RTX 5090 での 128 倍、Jetson Orin での 2.2 秒
論文には、ハードウェア、構成、計時の範囲が異なる 2 組の遅延の数字があり、著者も別々に報告しています。これは フィジカルAIラボ 0.3 で練習したルールそのものです。所要時間は、それを測ったシステムにだけ当てはまります。
| 手法 | RTX 5090、状態ごとのエンドツーエンド(s) | Jetson Orin 搭載、計画 1 回あたりの平均(s) |
|---|---|---|
| NoMaD | 0.121 | 0.651(302 回の呼び出し) |
| NoMaD+NWM-S | 11.653 | 235.038(22 回の呼び出し、DDIM-30、ロールアウト 1 回) |
| NoMaD+NWM-XL | 88.449 | 報告なし |
| LiteNWM | 0.691 | 2.228(311 回の呼び出し、中央値 2.085、P95 3.883) |
- RTX 5090 の列は RECON-100、H = 4、K = 16 で測定されました。計時には提案の生成、未来の評価、採点、精緻化、最終選択が含まれ、LiteNWM の値は初期化と 30 個のウォームアップ状態を 100 個の評価状態に按分しています。同じ表で、LiteNWM の状態ごとの GPU エネルギーは 0.0277 Wh、ピーク VRAM は 2,459 MiB、NoMaD+NWM-XL は 14.0695 Wh、13,776 MiB です。GPU エネルギーにロボット全体の消費は含まれません。88.449 ÷ 0.691 は約 128 で、著者の 128.00 倍と一致します。
- Jetson Orin の列はロボットのログから取った内部の計画遅延で、共有の符号化、提案、未来の評価、採点、条件付きの精緻化または回復、最終選択を含み、モデルの初期化とロボットの動作は含みません。搭載時は、初期候補が受け入れ条件を満たせば CEM を省き、満たさなければ最大 3 回まで精緻化します。311 回の呼び出しのうち 4 回が 2 回、19 回が 3 回の精緻化を使いました。
- 表の平均から本サイトで計算すると、搭載時の LiteNWM の計画 1 回は NoMaD の約 3.4 倍の時間がかかります(2.228 ÷ 0.651)。これは論文が示した倍率ではありません。タイトルの “onboard” は付録 F-C に対応し、LiteNWM は Go2 EDU 搭載の Jetson Orin で動作します。そこでも、候補の評価には NoMaD 単体より多くの時間がかかります。
エッジ推論のほかの遅延の数字の内訳は、フロンティア・レーダー特集|エッジとリアルタイム性 と照らし合わせてください。
実機:Go2 EDU で手法ごとに 30 回
展開先は Unitree Go2 EDU で、ナビゲーション方策が受け取るのは単眼 RGB 観測と RGB の目標画像 1 枚だけです。3 つのシーンで手法ごとに 10 回ずつ、計 30 回試行しました。成功の条件は、衝突、修正のための人の介入、異常終了の前に、較正済みの半径 1.0 m の目標範囲に入り、目標と一致する対象が見えていて、ヨー誤差が 60° 以内であることです。その状態が 1 s 以上続くか、続いて正常に停止する必要があり、目標を通り過ぎただけでは成功になりません。
| シーン | NoMaD 成功率 | NoMaD SPL | LiteNWM 成功率 | LiteNWM SPL |
|---|---|---|---|---|
| 開けた屋内 | 70.0% | 0.642 | 90.0% | 0.890 |
| 物の多い屋内 | 40.0% | 0.397 | 90.0% | 0.889 |
| 屋外の中庭 | 20.0% | 0.187 | 70.0% | 0.651 |
| 全体 | 43.3% | 0.409 | 83.3% | 0.810 |
SPL は全試行の平均で、失敗は 0 として数えます。実機での比較は LiteNWM と NoMaD の間だけです。NoMaD+NWM-S はロボット上で探索的に 2 回動かしただけで、DDIM を 30 ステップに減らしても、計画 1 回あたりの平均は 234.0 s と 236.5 s(それぞれ 13 回と 9 回の決定)でした。著者はこれを成功率の比較から除外しています。シーンあたり 10 回はサンプルとして小さく、提供された論文本文には実機結果の信頼区間もありません。こうした小規模な比較で確認すべき点は フィジカルAIラボ 1.8 で扱っています。
制約と注意点
- LiteNWM はプレプリントで、数字はすべて著者報告 [R] です。本サイトではいずれも再現しておらず、読んだ論文本文にはコードやモデルの公開についての記述がありません。
- 論文内に数値の不一致が 2 か所あります。結論では「NWM-S と NWM-XL に対しエンドツーエンドで 18.39 倍と 132.02 倍の高速化」とある一方、要旨・序論・第 IV-E 節は NoMaD+NWM-S に対し 16.86 倍、NoMaD+NWM-XL に対し 128.00 倍としています。本記事は表の計時と合う後者を採用しました。また序論は 221.97 s を NoMaD+NWM-XL の決定状態ごとのエンドツーエンド時間としていますが、第 IV-E 節は 221.974 s を NWM-XL 単体の 7 状態でのネイティブ CEM 診断の値としており、表の NoMaD+NWM-XL は 88.449 s です。
- 予測器が評価するのは 4 ステップ以内の局所的な結果だけです。著者は、長いルートは繰り返しの再計画に頼っており、このホライズンを超える予測精度は示していないこと、提案器は評価器から学習のフィードバックを受けないため候補の分布は変わらないこと、より積極的にスコアを最適化すると、特に提案分布の外でモデルの誤差が表に出るおそれがあることを書いています。
- オフラインの結果はドメインあたり 100 状態の開発コホートによるもので、SR@1 はオフラインの終点一致であり、閉ループの成功率ではありません。ゲートとアンサンブルの診断は過去の CEM3 構成によるもので、アンサンブルのメンバーに関する 6 つの比較はいずれも Holm 補正後に有意ではありません。
- 実機試験は 3 シーン、手法ごとに 30 回で、比較相手は NoMaD だけです。付録の長距離ルートのデモは、事前にマッピングした視覚ルートが中間目標画像の列を与える方式で、定性的な提示であり、成功率の表には含まれていません。
- 128 倍とエネルギーの数字は RTX 5090 のベンチマーク設定にだけ当てはまり、GPU エネルギーにロボット全体の消費は含まれません。Jetson Orin では、LiteNWM の平均計画遅延は NoMaD より長くなります。
リンク
- LiteNWM: Efficient Latent World Models for Onboard Visual Navigation in the Wild(arXiv 2610.12368)
- 論文 HTML 全文
- フロンティア・レーダー|Token-World:VLM の token 空間で世界モデルを展開し、RGB 再構成なしで VLA 方策をシミュレーションする
- フロンティア・レーダー特集|エッジとリアルタイム性:VLA と世界行動モデルのレイテンシ予算はどこに使われているか
- フィジカルAIラボ 0.3:見る・考える・動く――3 つの周波数をそれぞれのシステムに戻す
- フィジカルAIラボ 1.6:模倣学習――誤差がお手本のカバー範囲からはみ出すまでを手で計算し、ACT・拡散方策・データのスケーリング則の数字をそれぞれの条件に照らして読む
- フィジカルAIラボ 1.8:評価――「差し引き +2」を対応表に分解し、失敗ラベルと乱数シードを計算で確かめる
- フィジカルAIラボ:すべての数字を確認できるフィジカルAI講座(講座の概要)