
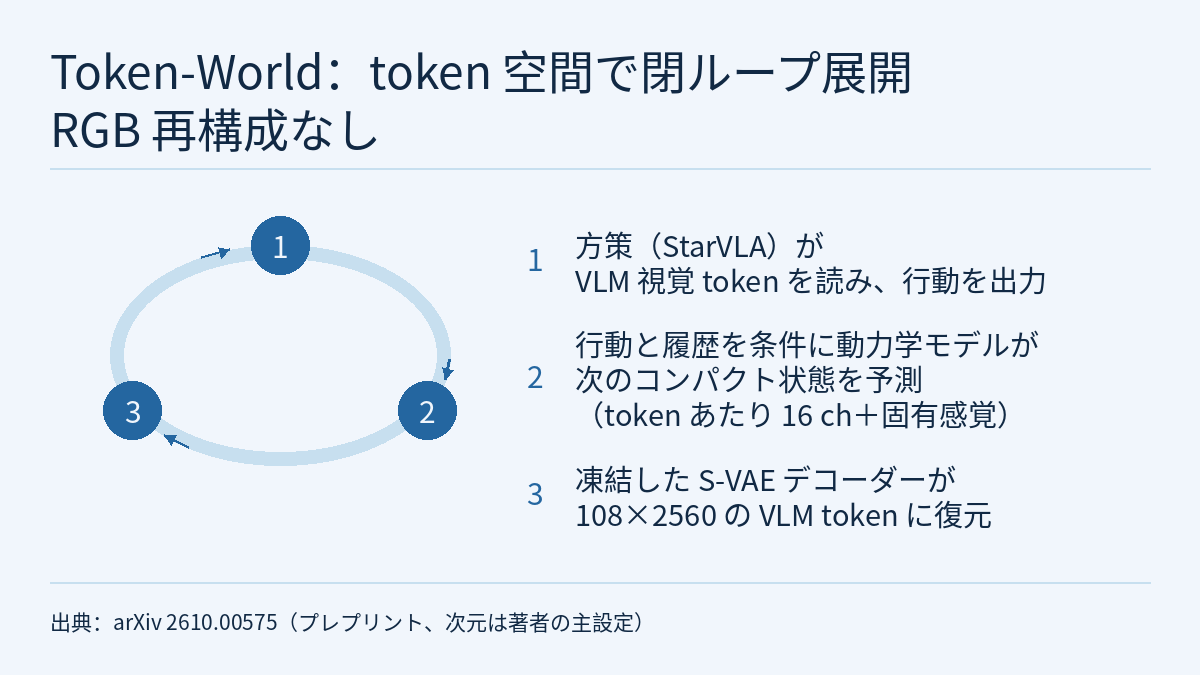
世界モデルで VLA 方策の「模擬試験」を行う場合、未来の RGB 画像を予測し、それを方策が読む視覚 token に再エンコードするのが一般的です。南方科技大学、香港科技大学、北京大学、MUKA Robotics などによるプレプリント Token-World(arXiv 2610.00575、2026-09-30、証拠レベル [R])はこのインターフェースを変え、方策が消費する VLM 視覚 token の空間で直接未来を予測し、ロールアウトのループ内で RGB を生成しません。著者の報告では、閉ループでシミュレーションした方策成功率と参照環境での成功率の Pearson 相関係数は 0.794 で、Ctrl-World は 0.583 でした。1 ステップあたりのシミュレーション時間は 0.359 s で、比較手法の中で最も短い値です。
問題:シミュレーターはピクセルを出力し、方策は token を読む
論文によれば、既存の「世界モデル+VLA」パイプラインの多くは間接的なインターフェースを使っています。世界モデルが人の見るピクセルを予測し、VLA がそのピクセルを視覚 token にエンコードし直す方式です。著者は、このずれは計算コストだけの問題ではないと主張します。RGB 再構成はシミュレーターの容量を方策と無関係かもしれない視覚的な細部に割かせますが、token 空間でのロールアウトは下流で行動生成に使われる表現そのものを目標にできます。
難しいのは、方策が使う VLM token が高次元で、生成的な動力学モデリングではなく知覚と行動のために最適化されている点です。Token-World は、まず圧縮し、圧縮した空間で動力学をモデル化し、必要なときだけ元の表現に戻します。
手法:チャネルだけを圧縮し、空間配置は保つ
- コンパクト状態:別途学習した意味的 VAE(S-VAE)が、凍結した Qwen3-VL の視覚 token を特徴次元方向に圧縮します。主設定では、各 2560 チャネルの 108 個の空間 token を、token あたり 16 チャネルに圧縮します。空間プーリングや token の統合は行わないため、108 個の token の空間配置は保たれます。コーデックは MSE、コサイン、KL の各項で学習し、学習後は凍結します。
- 行動条件付き動力学:世界状態は、コンパクトな視覚 token とロボットの固有感覚状態です。モデルは時空間 Transformer(空間注意と因果的な時間注意を分解)で、注意ウィンドウを超えた履歴は固定サイズの GRU 状態で保持します。学習目標は
x_0パラメータ化の flow matching と shortcut forcing で、事前学習済みの動画生成モデルには依存しません。 - 自己回帰ロールアウト:各予測は履歴に追加され、次のステップの条件になります。ロールアウトは全体を通してコンパクト空間にとどまります。方策が入力を必要とするときは、凍結した S-VAE デコーダーが元の VLM token に復元し、そのまま方策に渡します。ループ内に RGB 再構成はありません。
これとは別に学習・凍結した畳み込みデコーダーが、予測 token を 224×224 の RGB フレームに描画します。これは可視化とタスク成否の人手判定にだけ使い、ロールアウトや方策推論には関与しません。
著者が報告した結果
データ:シミュレーションでは RoboTwin の 50 の操作タスクを使い、各タスク 100 軌跡(成功 50、失敗 50)、合計 5,000 軌跡です。実機では Franka Research 3 アーム(Robotiq グリッパー、Intel RealSense 435 カメラ 2 台)で 6 タスク、600 の成功軌跡を収集しました。どちらも学習と検証を 9:1 で分割し、すべての手法が同じデータを使っています。
開ループ評価では、記録された行動系列を再生します。特徴指標は予測した表現と正解の凍結 VLM 表現を比較し、方策行動の一貫性は両者を同じ凍結方策にそれぞれ入力して出力行動を比較します。RGB ベースラインが生成したフレームは、評価前に同じ VLM で再エンコードします。
| 手法 | RoboTwin 特徴コサイン / NMSE | RoboTwin 行動コサイン / NMSE | 実機 Franka 特徴コサイン / NMSE | 実機 Franka 行動コサイン / NMSE |
|---|---|---|---|---|
| IRASim | 0.7372 / 0.5685 | 0.9260 / 0.1533 | 0.7061 / 0.6095 | 0.9174 / 0.1702 |
| Ctrl-World | 0.7097 / 0.6437 | 0.9265 / 0.1463 | 0.7213 / 0.5719 | 0.9288 / 0.1410 |
| WorldGym | 0.7146 / 0.6157 | 0.9251 / 0.1602 | 0.6697 / 0.6930 | 0.9089 / 0.1981 |
| Token-World | 0.7714 / 0.4892 | 0.9439 / 0.1145 | 0.7506 / 0.5129 | 0.9402 / 0.1208 |
長期ロールアウトでは、1 チャンク 16 ステップとして、第 0、5、10、15 チャンクで Token-World と Ctrl-World を比較しています。論文は Token-World の劣化がより緩やかだと述べていますが、示しているのは図(図 5)だけで、本文にチャンクごとの数値はありません。
閉ループ評価には StarVLA の 3 つの派生版(StarVLA-OFT、StarVLA-PIv3、StarVLA-GR00T)を使います。いずれも Qwen3-VL バックボーンを共有し、行動ヘッドが異なります。各ロールアウトは参照環境と同じ記録状態から始まり、その後は予測状態を方策に戻して後続の行動を生成させます。成否は、デコードした RGB ロールアウトをもとに人手で判定します。「方策–タスク」の組ごとに計算した、シミュレーションと参照環境の成功率の Pearson 相関係数は、Ctrl-World の 0.583 から 0.794 に上がりました。効率については、PPU-ZW810E アクセラレーター上で batch 1 で計測し、Token-World は 1 ステップ 0.359 s で、IRASim、Ctrl-World、WorldGym よりそれぞれ 2.0 倍、5.3 倍、6.1 倍高速でした。RGB ベースラインは 50 ステップのノイズ除去を使い、計測には RGB デコードと VLM 再エンコードが含まれます。Token-World は 16 ステップと shortcut forcing を使っています。
アブレーション:圧縮次元は大きいほど良いわけではない
S-VAE のチャネル数を 8 から 128 に増やすと、再構成は改善します(NMSE 0.1026 → 0.0409、コサイン 0.9389 → 0.9762)。一方、潜在表現が拡散モデリングに向いているかを測る 2 つの指標は悪化し、SEC は 0.3511 から 0.4740 に上がり、LDS は 0.3100 から 0.1182 に下がります。同じ動力学モデルを 8、16、32、48 の 4 段階で実際に学習すると、d=16 で特徴 NMSE が最も低く(0.1517)、特徴コサイン(0.8306)と行動コサイン(0.9641)が最も高くなりました。32 と 48 では未来特徴の予測が悪化するため、著者は 16 を動作点としています。
同じバックボーンと学習手順で 3 種類の世界状態表現を比べると、特徴/行動 NMSE は、元の Qwen3-VL 特徴で 0.7851/0.2180、SDXL-VAE 潜在で 0.8164/0.2586、S-VAE で 0.4892/0.1145 でした。元の VLM 特徴は SDXL-VAE より良いものの、S-VAE には明確に劣ります。著者はここから、コンパクト表現の設計が未来状態の予測に大きく影響すると結論づけています。
本サイトの既存記事との関係
「フロンティア・レーダー特集|シミュレーションと評価」では、方策を基準にしたシミュレーションの忠実度を取り上げました。Token-World はこの考え方をインターフェースの層まで進め、シミュレーターの状態を方策の入力表現そのものにし、評価指標もその表現と方策の行動で計算しています。「Beyond Binary Success」は統計の側から実機評価の回数を減らす研究でした。なお、0.794 は成功率どうしの相関係数であり、実機試験の代わりになる統計的な保証ではありません。「VLaRL」も VLM の潜在表現をインターフェースにしていますが、世界モデルの状態としてではなく、sim-to-real の残差 RL に使っています。今シーズンの講座で世界モデルをどこで扱うかは、講座の概要をご覧ください。
制約と注意点
- これは arXiv のプレプリントで、数値はすべて著者の報告です。本サイトでは独立に再現していません。論文はコードを「公開予定」としていますが、本記事が依拠した資料には利用できるコードリポジトリはありません。
- 開ループ指標は凍結 VLM の特徴空間で計算されており、これは Token-World が直接予測する空間です。RGB ベースラインは、ピクセルを生成して再エンコードしてからでないと同じ空間で比較できません。
- 閉ループの成否は、補助デコーダーが描画した RGB をもとに人手で判定しています。本記事が依拠した論文テキストには、「方策–タスク」の組の数も、閉ループで使ったタスクの内訳も書かれていません。
- レイテンシ比較では、ベースラインが 50 ステップ、Token-World が 16 ステップのノイズ除去を使っており、高速化の倍率は表現空間の違いだけを反映したものではありません。
- RoboTwin のデータには失敗デモが含まれますが、実機 Franka のデータは成功軌跡のみです。アブレーションの表 III(d=16 の特徴 NMSE 0.1517)は表 I・表 IV(0.4892)と値が大きく異なり、論文は表 III の評価データを明記していないため、表をまたいで比較する際は注意が必要です。
- 著者は、現在の評価が操作タスクと同じ VLM バックボーンを共有する方策に限られること、どのような意味表現が世界モデルに適しているかをまだ体系的に明らかにしていないことを明記しています。他の方策バックボーンへの拡張は今後の課題です。


