
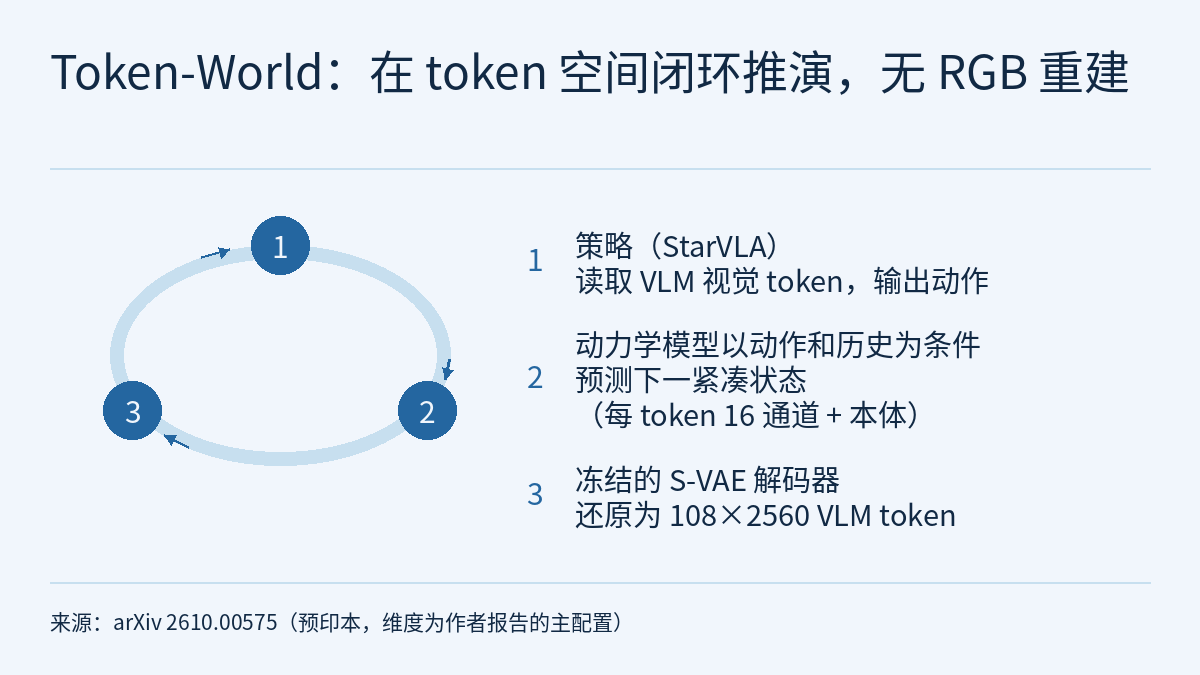
用世界模型给 VLA 策略做“模拟考”时,常见做法是先预测未来的 RGB 画面,再把画面重新编码成策略要读的视觉 token。南方科技大学、香港科技大学、北京大学与 MUKA Robotics 等单位的预印本 Token-World(arXiv 2610.00575,2026-09-30,证据等级 [R])换了一个接口:直接在策略消费的 VLM 视觉 token 空间里预测未来,推演和策略反馈循环中不生成 RGB。作者报告,闭环模拟出的策略成功率与参考环境成功率的 Pearson 相关系数为 0.794,Ctrl-World 为 0.583;每步模拟耗时 0.359 s,是对比方法中最低的。
问题:模拟器输出像素,策略读的是 token
论文指出,现有的“世界模型 + VLA”流水线多采用间接接口:世界模型预测人能看的像素,VLA 再把像素编码成视觉 token。作者认为这种错配不只是计算开销问题:RGB 重建会让模拟器把容量花在与策略无关的视觉细节上,而在 token 空间推演,目标直接就是下游生成动作所用的表示。
难点在于,策略用的 VLM token 维度很高,本是为感知和动作优化的,并不适合直接做生成式动力学建模。Token-World 的做法是先压缩、再建模、需要时再还原。
方法:只压通道,不动空间布局
- 紧凑状态:单独训练一个语义 VAE(S-VAE),把冻结的 Qwen3-VL 视觉 token 沿特征维压缩。主配置中,108 个空间 token、每个 2560 通道,压到每个 16 通道;不做空间池化或 token 融合,108 个 token 的空间排列保持不变。编解码器用 MSE、余弦和 KL 项训练,训练完即冻结。
- 动作条件动力学:世界状态是紧凑视觉 token 加机器人本体状态。模型是时空 Transformer(空间注意力与因果时间注意力分解),用固定大小的 GRU 状态保留超出注意力窗口的历史;训练目标是
x_0参数化的 flow matching 加 shortcut forcing,不依赖预训练视频生成模型。 - 自回归推演:每步预测追加到历史中、作为下一步的条件,推演全程停留在紧凑空间。策略需要输入时,用冻结的 S-VAE 解码器还原成原始 VLM token,直接交给策略,循环中没有 RGB 重建。
另有一个单独训练、冻结的卷积解码器把预测 token 渲染成 224×224 的 RGB 帧,只用于可视化和人工判定任务成败,不参与推演和策略推理。
作者报告的结果
数据:仿真用 RoboTwin 的 50 项操作任务,每项 100 条轨迹(成功、失败各 50),共 5,000 条;真机用 Franka Research 3 机械臂(Robotiq 夹爪、两台 Intel RealSense 435 相机)采集的 6 项任务、600 条成功轨迹。两者都按 9:1 划分训练和验证,所有方法共用同样的数据。
开环评测按记录的动作序列回放:特征指标比较预测与真实的冻结 VLM 表示;策略动作一致性把两者分别喂给同一个冻结策略、比较输出动作。RGB 基线的生成帧先由同一个 VLM 重新编码再评测。
| 方法 | RoboTwin 特征余弦 / NMSE | RoboTwin 动作余弦 / NMSE | 真机 Franka 特征余弦 / NMSE | 真机 Franka 动作余弦 / NMSE |
|---|---|---|---|---|
| IRASim | 0.7372 / 0.5685 | 0.9260 / 0.1533 | 0.7061 / 0.6095 | 0.9174 / 0.1702 |
| Ctrl-World | 0.7097 / 0.6437 | 0.9265 / 0.1463 | 0.7213 / 0.5719 | 0.9288 / 0.1410 |
| WorldGym | 0.7146 / 0.6157 | 0.9251 / 0.1602 | 0.6697 / 0.6930 | 0.9089 / 0.1981 |
| Token-World | 0.7714 / 0.4892 | 0.9439 / 0.1145 | 0.7506 / 0.5129 | 0.9402 / 0.1208 |
长程推演按每块 16 步,在第 0、5、10、15 块比较 Token-World 与 Ctrl-World;论文称 Token-World 退化更慢,但只以图(图 5)展示,文本中没有逐块数值。
闭环评测用三个 StarVLA 变体(StarVLA-OFT、StarVLA-PIv3、StarVLA-GR00T),它们共用 Qwen3-VL 骨干、动作头不同。每次推演从与参考环境相同的记录状态开始,之后把预测状态反馈给策略生成后续动作;成败由人工根据解码出的 RGB 推演判定。按“策略–任务”对计算,模拟与参考成功率的 Pearson 相关系数从 Ctrl-World 的 0.583 提高到 0.794。效率方面,在 PPU-ZW810E 加速器上以 batch 1 计时,Token-World 每步 0.359 s,相对 IRASim、Ctrl-World、WorldGym 分别快 2.0、5.3、6.1 倍;RGB 基线用 50 步去噪,并计入 RGB 解码和 VLM 重新编码,Token-World 用 16 步加 shortcut forcing。
消融:压缩维度不是越大越好
把 S-VAE 通道数从 8 增加到 128,重建变好(NMSE 0.1026 → 0.0409,余弦 0.9389 → 0.9762),但衡量“好不好扩散建模”的两个指标变差:SEC 从 0.3511 升到 0.4740,LDS 从 0.3100 降到 0.1182。用同一个动力学模型实测 8、16、32、48 四档,d=16 的特征 NMSE 最低(0.1517)、特征余弦(0.8306)和动作余弦(0.9641)最高,32 与 48 的未来特征预测更差,作者据此把 16 定为工作点。
在相同骨干和训练流程下比较三种世界状态:原始 Qwen3-VL 特征的特征/动作 NMSE 为 0.7851/0.2180,SDXL-VAE 潜变量为 0.8164/0.2586,S-VAE 为 0.4892/0.1145。原始 VLM 特征优于 SDXL-VAE,但明显不如 S-VAE;作者据此认为,紧凑表示的设计对未来状态预测影响很大。
和本站已有内容的关系
《前沿雷达专题|仿真与评测》讨论过面向策略的仿真保真度;Token-World 把这个思路推到接口层面:模拟器的状态就是策略的输入表示,评测指标也落在这个表示和策略动作上。《Beyond Binary Success》则从统计角度减少真机评测次数;需要注意,0.794 是成功率之间的相关系数,不是能替代真机试验的统计保证。《VLaRL》同样以 VLM 潜变量作为接口,但用在仿真到真机的残差 RL 上,而不是作为世界模型的状态。全季课程中世界模型相关内容的安排见课程大纲。
局限 / 注意
- 这是 arXiv 预印本,所有数字均为作者报告,本站没有独立复现。论文称代码“将会”公开,本文依据的材料中没有可用的代码仓库。
- 开环指标在冻结 VLM 的特征空间里计算,这正是 Token-World 直接预测的空间;RGB 基线要先生成像素再重新编码,才能进入同一空间比较。
- 闭环成败由人工根据辅助解码器渲染的 RGB 判定;本文依据的论文文本没有写明“策略–任务”对的数量,也没有写明闭环所用的具体任务集。
- 延迟对比中,基线用 50 步去噪、Token-World 用 16 步,步数设置不同,加速倍数不只反映表示空间的差别。
- RoboTwin 数据含失败示范,真机 Franka 数据只有成功轨迹。消融表 III(d=16 的特征 NMSE 0.1517)与表 I、表 IV(0.4892)数值差别很大,论文未说明表 III 的评测数据,跨表比较时要注意。
- 作者写明,目前的评测只覆盖操作任务和共用同一 VLM 骨干的策略,也还没有系统刻画什么样的语义表示适合做世界模型;跨策略骨干的扩展是后续工作。


