
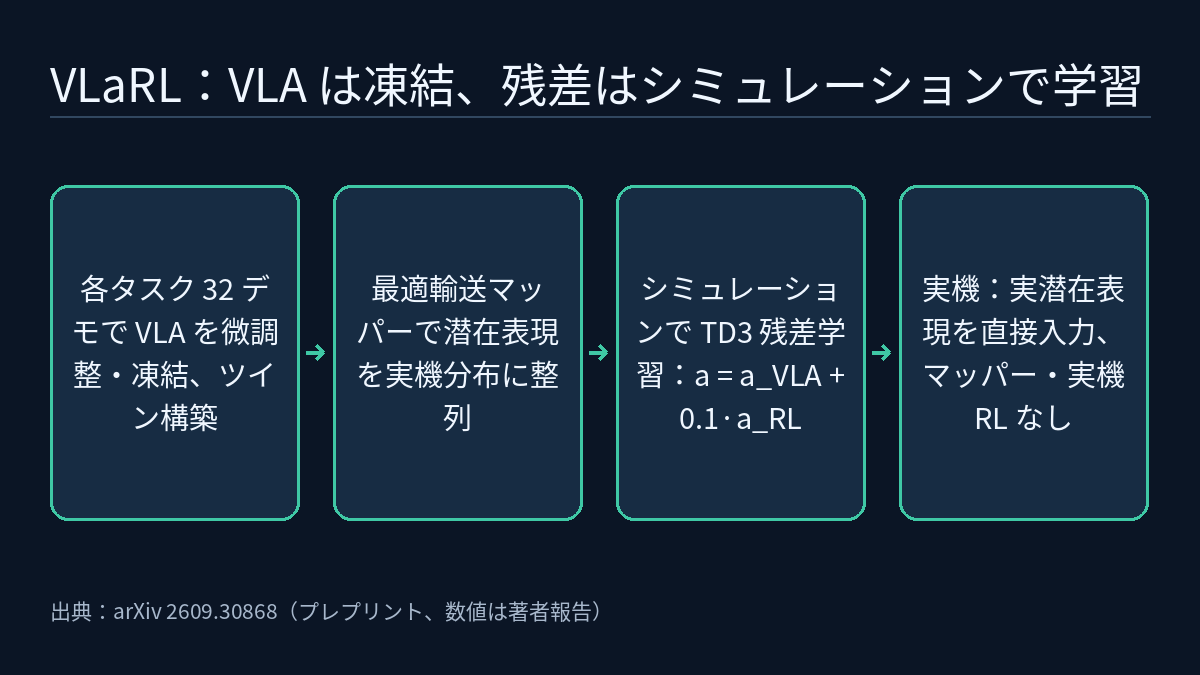
VLA モデルは言語指示から大筋では正しい操作を出せますが、ボタンを押す、ブロックを押す、カップを重ねるといった接触の多い場面では、接触位置や位置合わせのわずかなずれでタスクに失敗します。Microsoft Research Asia(東京)のプレプリント VLaRL(arXiv 2609.30868、2026-09-25、証拠レベル [R])は、VLA を凍結したまま、その出力に加える補正量(残差方策)だけを学習します。強化学習はすべてシミュレーションで行い、実機では実機 RL もオンライン適応も行いません。この論文で注目すべきは、シミュレーションと現実の視覚的なギャップを越えるために選んだインターフェースです。画像でも物体姿勢でもなく、VLA が内部ですでに計算している視覚・言語の潜在表現を使い、さらにシミュレーションの潜在表現を実機の分布へ寄せる軽量なマッパーを加えています。
なぜ「凍結した VLA + シミュレーションでの残差 RL」なのか
著者らの出発点は、VLA が妥当な名目上の動作を出しながら、物理的な実行の段階で失敗することが多いという点です。模倣学習を増やして直すには、補正を含むデモを集めて基盤方策を更新する必要があります。残差 RL は VLA の名目上の振る舞いを残したまま補正量だけを学習し、タスク報酬から直接最適化できます。ただし実機で試行錯誤を繰り返すのはコストが高く、安全上の懸念もあるため、著者らは残差方策の学習を完全にシミュレーションで行います。
実際に実行される動作は、名目上の動作にスケールした補正を加えたものです。
a_t = a_t^VLA + α · a_t^RL    # α = 0.10、全タスク共通
a_t^RL = π_RL(z_t, a_t^VLA, s_t, f_t)
残差方策の入力は 4 つです。VLM の潜在表現 z_t、VLA の名目上の動作、固有受容状態 s_t(エンドエフェクタの位置と roll–pitch–yaw 姿勢、グリッパの状態)、手首で測った 3 次元のデカルト力 f_t です。どちらのバックボーンでも動作は 7 次元の正規化されたデカルト動作(並進 3、回転 3、グリッパ指令 1)で、残差 actor は同じ次元の tanh 動作を出力し、ほぼゼロの補正を出すように初期化されます。
インターフェースの選択:画像か、姿勢か、VLM の潜在表現か
論文は既存の sim-to-real のインターフェースを 2 種類に分けています。画像を入力とする方策はシーンの豊富な情報を保つ一方で、視覚的なギャップに直接さらされます。物体姿勢のような幾何学的な状態はコンパクトですが、別途の認識パイプラインとタスクごとの状態定義が必要です。著者らの以前の object-centric residual RL は、推定した 6-DoF の物体姿勢をインターフェースにしていました。
VLaRL は代わりに、凍結した VLA 自身の視覚・言語モジュールが出すトークン行列(S 個のトークン、各 D 次元)を使い、トークンを平均プーリングした D 次元ベクトルを残差方策に渡します。Flower では Florence-2 ベースの視覚・言語モジュールから言語条件付きのトークンを取り出し、プーリング後は 1024 次元です。GR00T N1.7 では言語条件付きの画像トークンを使い、2048 次元です。著者らによれば、この表現はピクセルの細部をある程度抽象化しつつ、タスクに関係する視覚と指示の文脈を保っています。同じシーンでも、指示された対象や物体の役割が違えば必要な補正も違い、その情報は名目上の動作だけからは得られません。
一方で著者らは、この表現が視覚的なギャップに対して完全には不変でないことも指摘しています。似たタスク状態でも、シミュレーションの画像と実画像では潜在表現の分布が異なります。マッパーはそのために加えられています。
4 段階のワークフローとマッパー
- VLA の微調整と凍結、デジタルツインの再構築:タスクごとに 3D マウスによる遠隔操作で実機デモを 32 本収集し(Franka Research 3)、VLA を微調整したあと凍結します。同じデモと FoundationPose を使って物体の位置と環境を再構築し、MuJoCo 上におおむね対応するタスク構成を作ります。
- マッパーの学習:プーリング前のシミュレーションのトークン列に作用する、4 層・16 ヘッドの Transformer エンコーダです。学習可能な残差接続を持ち、そのスケール係数は 0 で初期化されるため、最初は恒等変換として振る舞います。シミュレーションと実機の軌跡はおおむね対応するだけで、フレーム単位のペアはないため、著者らはエントロピー正則化付き最適輸送(Sinkhorn divergence)で分布を揃えます。コストは、マッピング後のシミュレーションのトークンと実機のトークンの差の Frobenius ノルムの 2 乗(S·D で割る)に、正規化した軌跡進捗の差の 2 乗の λτ 倍を加えたものです。ハイパーパラメータは λτ = 0.5、ε = 0.05、Sinkhorn 反復 50 回です。
- シミュレーションでの残差学習:マッパーを凍結したうえで、TD3 で 60,000 環境ステップ学習します。マッピング後のトークンには 2 つの役割があります。凍結した VLA の行動ヘッドに入力し、実データで微調整した VLA がシミュレーション画像で受ける表現のずれを小さくすること、そしてプーリングして残差 actor に入力することです。critic はシミュレーションで得られる特権的なタスク状態も受け取り、actor はデプロイ時に得られる観測だけを使います(非対称 actor–critic)。さらにデモから残差の目標値 (a_demo − a_VLA) / α を作り、補助的な正則化項として使います。
- 実機へのデプロイ:実画像のトークンはマッパーを通さず、そのまま平均プーリングして残差方策に渡します。すべてのモデルは凍結したままです。
著者らが報告した結果
4 つのタスクはそれぞれ異なる局所制御の難しさを扱います。ボタン押し(精密な接触)、ブロック押し(持続的な接触)、カップ重ね(把持と空間的な位置合わせ)、引き出し閉め(関節物体との接触)です。物体の初期位置は ±3 cm、向きは ±15° でランダム化し、引き出しの開き幅も ±3 cm でランダム化しています。シミュレーションの結果は 3 つの乱数シード、実機は各条件 40 回の試行です。論文によれば、VLaRL は 8 つのタスクとバックボーンの組み合わせすべてで実機の成功率を上げました。本文に数値が書かれている組み合わせは次のとおりです(残りは棒グラフにのみ示されており、本記事では転載しません)。
| 条件(実機、各 40 回) | 凍結したベース VLA | VLaRL |
|---|---|---|
| Flower、ボタン押し | 67.5% | 100.0% |
| Flower、ブロック押し | 22.5% | 50.0% |
| GR00T N1.7、カップ重ね | 17.5% | 45.0% |
| 未知の物体、ブロック押し(星形、三角形) | 40.0%(16/40) | 57.5%(23/40) |
| 未知の物体、カップ重ね(水色と緑のカップ) | 55.0%(22/40) | 62.5%(25/40) |
未知の物体の実験では、追加の残差 RL も実機での適応も行っていません。シミュレーションの例は Flower のブロック押しで、ベース VLA が 32.5%、マッパーを加えると 42.5%、VLaRL 全体で 67.5% です。マッパー単独でもシミュレーションでの名目上の成功率が上がっており、表現のずれを小さくするという設計意図と整合します。
著者らは、シミュレーションと実機の傾向が一致しない例も報告しています。Flower のカップ重ねでは、ベースの成功率が実機のほうがシミュレーションより明らかに高く、残差による実機での上積みはわずかでした。著者らの説明は、潜在表現の整列では接触ダイナミクスや VLA の動作の分布など、ほかの sim-to-real の違いは解消できないというものです。
アブレーション:マッパーと潜在表現はそれぞれ何を担うか
2 つの統制されたアブレーションは、どちらも Flower だけで行われています。
- マッパーなし(整列していないシミュレーションの潜在表現で残差を学習):ブロック押しとカップ重ねは実機の 40 回すべてで失敗し、VLaRL 全体ではそれぞれ 50.0% と 70.0% でした。つまり、生のシミュレーションの潜在表現で学習した残差は、実機の潜在表現には移転しません。
- VLM の潜在表現なし(名目上の動作、固有受容、力は残す):4 タスクすべてで実機の成功率が下がりました。たとえばボタン押しは 100.0% から 70.0%、ブロック押しは 50.0% から 20.0% です。
著者らはさらに integrated gradients で、残差動作のノルムがどの入力に由来するかを分析しています。全タスク・両バックボーンで VLM の潜在表現への帰属が最も大きく、Flower で 72.1%–89.7%、GR00T N1.7 で 84.0%–90.9% でした。物理的な入力の割合はタスクによって変わり、持続的な接触が必要なブロック押しでは力の割合が上がり、精密な位置調整が必要なカップ重ねでは固有受容の割合が高くなります。帰属が示すのはネットワークが各入力にどれだけ依存しているかであり、それだけでは因果の証明になりません。著者らはこれをアブレーションの結果と合わせて根拠として示しています。
本サイトの講座・既存記事との関係
「フロンティア・レーダー特集|学習と自己改善:VLA ポストトレーニングの 3 つの段階とオンライン RL の task collapse」では、SFT からシミュレーションと実機での RL ポストトレーニングまでの流れを整理しました。VLaRL は別の役割分担を示しています。VLA は教師あり微調整を 1 回行ったあと重みを変えず、RL は小さな残差ネットワークだけを最適化し、しかも実機ではまったく実行しません。
講座のシラバスでは、L2 で sim2real におけるドメインランダム化とシステム同定を扱う回を予定しています。VLaRL が対象とするのは視覚的なギャップで、ピクセル単位の対応の代わりに潜在表現の分布を揃えます。著者らは、マッパーが接触ダイナミクス、摩擦、コンプライアンスを扱わないことを明記しており、そのギャップは別途対処する必要があります。バックボーンの一つである GR00T N1.7 は「フィジカルAIラボ 0.2:なぜ今なのか、データ・モデル・計算資源の 3 本の曲線」で紹介しました。この論文は、構造が大きく異なる Flower と同じパイプラインでそれを比較しています。
制約と注意点
- これは arXiv のプレプリントで、上記の数値はすべて著者らの報告です。本記事が依拠した資料には独立した再現も、コードリポジトリへのリンクもありません。
- マッパーの学習には、おおむね対応するシミュレーションと実機の軌跡が必要で、タスクごとにデジタルツインを再構築しなければなりません。必要なのは学習時だけですが、手法のスケールを制限することを著者らも認めています。
- マッパーが扱うのは、視覚的なギャップが VLM の表現に生むずれです。接触ダイナミクス、摩擦、コンプライアンスなどの物理的な違いは明示的には扱わず、著者らはそれがシミュレーションと実機の結果の食い違いの原因かもしれないとしています。
- マッパーは VLA のバックボーンごとに固有で、残差方策は現状タスクのカテゴリごとに別々に学習しています。
- 未知の物体の評価は限られた物体のバリエーションしか扱っておらず、オープンワールドでの汎化を示すものではないと著者らは明記しています。
- 2 つのアブレーションは Flower だけで行われています。実機は各条件 40 回で、本文には信頼区間も有意性検定もありません。たとえば未知のカップでは 22/40 対 25/40 で、差は成功 3 回分です。
リンク
- arXiv 2609.30868:VLaRL: Augmenting Vision-Language-Action Models with Simulation-Trained Latent-Conditioned Residual RL(著者:Namiko Saito、Kinam Kim、Heecheol Kim、Katsushi Ikeuchi、Yasuyuki Matsushita)
- 論文 HTML 全文


