
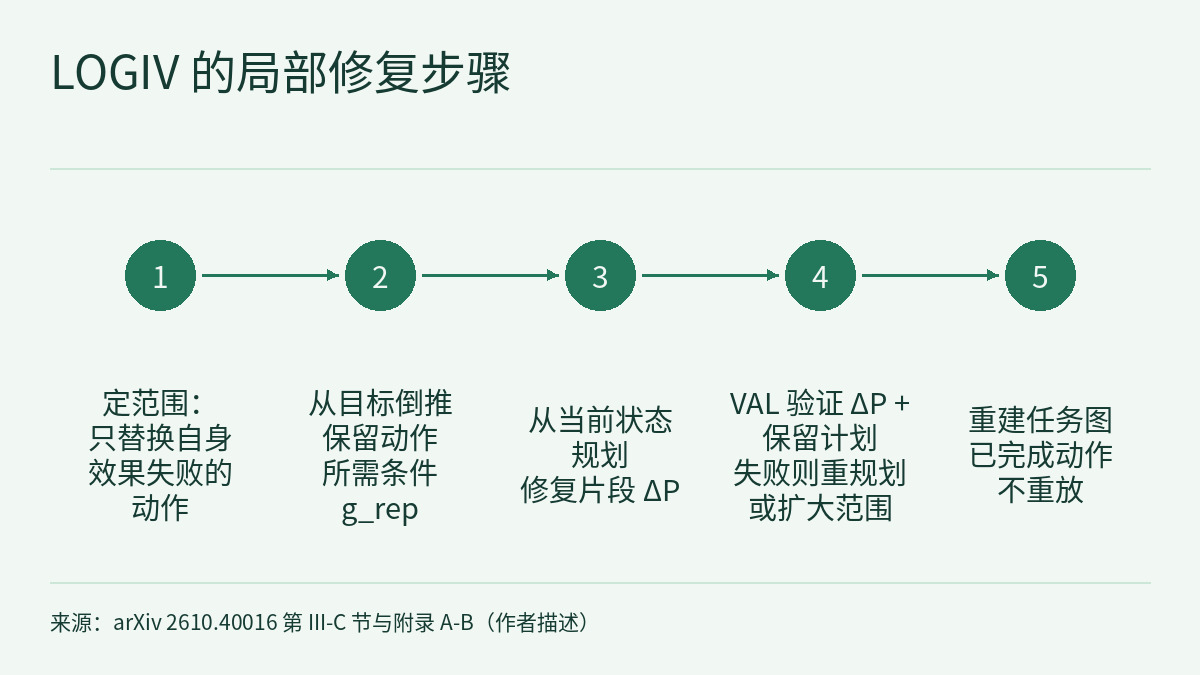
预印本 LOGIV(arXiv 2610.40016,2026-10-29,作者来自香港中文大学(深圳)、A*STAR、Caltech、NUS、HKUST、COCO Matrix 和 NTU)处理长程任务里一个容易被忽略的问题:一个动作做完了,它留下的条件不一定一直成立。搭桥时放好的支架,可能在抓横梁时被碰歪;“放支架”这一步仍然算完成,但后面“放横梁”需要的支撑已经没了。LOGIV 在现有 VLA 或世界动作模型(WAM)策略之上加一层不含可训练参数的执行与修复层:把 PDDL 计划编译成任务图,执行中用视觉和机器人反馈逐步核对这些条件,失效后只替换受影响的部分,并在继续执行前用 VAL 验证整个后续计划。以下数字均为作者报告 [R],本站未复现。
问题:“完成”和“仍然成立”是两件事
论文的出发点是:可靠的长程执行既要追踪动作是否完成,也要追踪它产生的结果是否持续有效。LOGIV 的核心设计是把这两件事分开:节点的完成状态是一回事,它为后续动作提供的支撑当前是否有效是另一回事。支撑失效时,已完成的节点不重新打开,依赖它的未完成动作也留在计划里,修复只负责把它们的前提重新建立起来。论文用 BiCoord 的 build_bridge 任务(图 1)说明:支架被挪动后,LOGIV 只修与支架有关的操作,保留横梁相关的操作,在更新后的任务图上继续执行。
作者明确说,他们不把依赖追踪本身当作新的规划原理,而是建立在因果链监控和计划修复这一类已有工作之上;新的地方在于用视觉状态评估去更新这些生产者–消费者依赖,再据此选出局部修复的范围。
任务图怎么建:两种边,一条参考顺序
输入是 PDDL 的 Domain(可复用的算子及其参数、前提和效果)与 Problem(物体、初始状态 S0 和目标 g)。Fast Downward 里的 LAMA-first 搜索出一串落地的算子,VAL 独立检查动作绑定、前提、建模的效果和最终目标;检查失败时返回出错位置和原因,排除这串计划后重新搜索。只有验证通过,才开始建图:
- 因果边。对每个算子的每条前提,往前找最近一个产生该条件、且中间没有被其他算子破坏的算子,连一条标注了该条件的边。来自
S0的条件从 START 节点出发,目标条件连到 GOAL 节点。论文特意说明,这里的“因果”指 PDDL 意义上的条件支撑,不是学出来的因果模型。 - 资源边。为机械臂、夹爪这类独占资源,以及建模中的相互干扰(一个算子破坏另一个算子需要或建立的条件)保留先后顺序。
两种边都顺着参考计划 P 的顺序,所以图无环,P 是它的一个拓扑序。论文也提醒,其他拓扑序不一定合法,执行顺序要在线检查。
执行中的三道检查
调度时,在前驱都已完成的动作里,选 P 中最早且执行条件成立的那一个,以自然语言指令加当前画面交给底层策略。每个节点执行前后各检查一次:
- State Gate:VLM(GPT-4o,每次调用最多输出 512 个 token)从画面中提取与当前动作及其依赖有关的事实,再与机器人状态和执行器反馈合成符号状态。证据不足时,重新取图、调整视角或重复检查,最多再观测 3 次;仍无法确认就返回 UNRESOLVED,停止执行。
- Node Gate:执行前查前提,确认不满足时以 PRECONDITION_FAILURE 返回失败;执行后查预期效果,效果通过才把节点标为完成。
- Graph Gate:执行前查资源前驱和条件支撑;执行后检查 START 和所有已完成动作提供的支撑,对剩余动作和 GOAL 是否仍然成立。
因此,抓横梁时把支架碰歪了,即使抓取本身成功,也会以 EFFECT_FAILURE 触发修复。失败记录包含失败类型、节点、未满足的条件和失效的边。
修复:保留什么、替换什么、怎样验证
修复的第一步是区分“受影响的动作”和“需要替换的动作”。受影响的动作是检测到失败的那个未完成动作,或直接依赖失效支撑的未完成动作,再加上它们未完成的因果后继。一开始,只有刚执行完、自身效果失败的动作会被替换;前提缺失的动作保留,由修复先补上前提;已完成动作的支撑失效时,它仍算完成,它的消费者也保留。
剩下的未完成动作构成保留计划 P_keep。系统从目标 g 出发,按逆序穿过这些保留动作,算出它们恢复执行前必须成立的条件 g_rep:如果某个保留动作会删除一条仍然需要的条件,或者出现互相矛盾的条件,就判定不可行。论文的例子是:保留的“抓横梁”需要 gripper_empty,并会自己产生 holding(beam),所以修复只需在抓取前让夹爪空出来,不必提前建立 holding(beam)。
接着,规划器从当前状态生成一段达成 g_rep 的修复片段 ΔP,拼在 P_keep 前面,再由 VAL 检查整个后续计划能否到达 g。失败点落在修复片段内,就在同一范围里重新规划,出现重复候选则终止;失败点落在某个保留动作上,就把替换范围扩大到它和它未完成的因果后继。规划失败、超时或无法定位失败时,按论文附录的确定性规则回退。验证通过后重建任务图:已完成的动作保持完成、不重放,它们仍然有效的效果由当前状态和新的 START 节点表示。
预算写得很具体:每次规划限时 30 s,每次 VAL 限时 5 s;每次失败最多 3 轮局部修复、4 次 VLM 调用,超出即结束该回合;所有实验都关闭了人工协助。作者说明,VAL 通过只说明计划与符号模型和输入状态一致,不保证感知准确或物理上一定成功;修复过程也不保证最小或完备。
结果:仿真两个基准、真机三个任务
设置。RoboTwin V2 和 BiCoord 各选 10 个双臂任务,每个任务 10 个预设初始状态,所以每个基准、每种设置各 100 个回合。无扰动设置每个初始状态跑一次;扰动设置在同一批初始状态上,于预设事件处注入一次可恢复的扰动,扰动类型和触发时机在每个任务内固定。例如 move_can_pot 中,罐子被抓起后,锅会被横向推开 10–15 cm。三个执行骨干 π0.5、AHA-WAM 和 Light-WAM 都在各基准的 10 个任务上做了任务专属微调,训练用的专家示范不含评测时的扰动。三个对照方法 VeriGraph-PDDL、LERa-PDDL 和 VLM-RP-BT 都是作者按原方法思路改造的版本,不是原系统的未修改实现。
无扰动(C)。三个骨干的平均成功率,RoboTwin V2 从 71.67% 升到 82.33%,BiCoord 从 42.33% 升到 57.67%。作者的解释是,即使不注入扰动,机器人也会遇到状态偏差和动作失败。
有扰动(P)。下表把骨干、三个改造对照中最高的一个和 LOGIV 并排列出(数字取自论文表 I,“最强对照”一列由本站挑出):
| 基准 | 骨干 | 骨干单独 | 最强改造对照 | LOGIV |
|---|---|---|---|---|
| RoboTwin V2 | π0.5 | 32 | 58(VLM-RP-BT) | 60 |
| RoboTwin V2 | AHA-WAM | 60 | 80(VLM-RP-BT) | 83 |
| RoboTwin V2 | Light-WAM | 58 | 70(VLM-RP-BT) | 72 |
| BiCoord | π0.5 | 31 | 45(VLM-RP-BT) | 48 |
| BiCoord | AHA-WAM | 43 | 48(LERa-PDDL、VLM-RP-BT 并列) | 53 |
| BiCoord | Light-WAM | 39 | 46(VeriGraph-PDDL) | 49 |
单位为 %。LOGIV 在全部六组里都高于三个对照,条件恢复率(R)也是如此。本站的读法有两点:第一,六组里有五组,相对骨干的提升大部分最强的改造对照就已拿到(BiCoord 加 AHA-WAM 那一组各占一半),LOGIV 比最强对照多出的是 2–5 个百分点;第二,每格是 100 个回合,2 个百分点相当于 2 个回合(本站换算),所读正文没有给出仿真结果的置信区间或显著性检验。论文还提醒,R 的分母是各方法各自“符合条件”的扰动事件,事件集合可能不同,应与 P 一起看。
真机。两台双臂平台,π0.5 与 π0.5 + LOGIV 使用同一个检查点和同一批示范,每个任务 10 次,初始摆放配对,完成整条指令才算成功;真机试验没有注入扰动。
- pick_tomato(Astribot S1):7/10 → 9/10,恢复的是空抓和过早松手。
- build_blocks(Astribot S1):3/10 → 5/10,后续伸手碰动已放好的方块时,Graph Gate 发现后续放置所需的条件不再成立,修复只恢复那一块。
- insert_cable(AgileX Piper):2/10 → 3/10。剩下的失败多是插头对准了却插不到位,取决于底层策略的接触精度,而不是取决于计划。
- 合计 12/30(40.0%)→ 17/30(56.7%)。作者自己写明,每个任务只有 10 次,置信区间很宽,只能看作趋势。
消融(RoboTwin V2 的 10 个任务,π0.5,每种设置 100 个回合):
- 作者称去掉 State Gate、Node Gate 或 Graph Gate 都会降低三项成功率指标,但所读正文只给出了去掉 Graph Gate 的数字:扰动成功率从 60% 降到 48%,作者称这是各变体中最低的扰动成功率;去掉不确定性处理(UNRESOLVED),条件恢复率从 72% 降到 59%。
- 不做因果追踪、按线性计划中的位置选修复节点:被改动的节点比例仍是 24.6%,但无扰动成功率从 72% 降到 61%,扰动成功率从 60% 降到 52%。作者据此认为,起作用的是选中了哪些节点,而不只是改动范围的大小。
- 把局部修复换成重规划所有剩余动作:改动节点比例变为 100%,重复执行仍然有效的已完成动作从平均 0.2 次增加到 1.6 次,扰动成功率降到 54%。
- 不对修复后的计划做 VAL 验证:条件恢复率从 72% 降到 62%,扰动成功率从 60% 降到 57%。
和本站课程与前沿雷达的关系
按 物理AI实验室 0.3:看-想-动 的分法,LOGIV 改的是“想”里较慢的那一层:它不碰底层策略的动作生成,只决定下一步交给策略什么、执行完核对什么、出错后改哪一段计划。前沿雷达|RESETTLE 的恢复发生在冻结策略的动作接口上,LOGIV 的恢复发生在符号计划层;前沿雷达|SCOPE 把 PDDL 规划失败当作离线生成训练数据的信号,LOGIV 则在执行中在线使用 PDDL 和 VAL。前沿雷达|Cracking Mobile Manipulation 讨论的是子任务串起来后成功率下降,靠的是事后给失败回合归因;LOGIV 的失败记录在运行时就写明了哪个节点、哪条条件、哪条边。这些工作的基准、骨干和扰动都不同,数字不能互比。
读 LOGIV 的结果表,可以用 物理AI实验室 1.8:评测 的方法练一遍:每格 100 个回合时 2–5 个百分点的差距有多稳;真机 12/30 与 17/30 是配对摆放下的两组计数,可以追问逐对的变好与变坏,论文的真机表只给了每个任务的总数。
局限 / 注意
- 这是 arXiv 预印本,全部数字为作者报告 [R],本站没有复现。论文首页列出了 GitHub 仓库和项目主页,本站没有打开核对其内容。
- 方法依赖事先写好并固定的 PDDL 规格:确定性的逻辑前提和效果、带类型的物体参数。所读正文没有讨论规格写错或遗漏条件时会怎样;按本站的理解,换任务至少要写新的 Problem;新任务需要原 Domain 没有的算子或条件时,还要扩展 Domain。
- 仿真扰动每回合只有一次,事先设定且可恢复,类型和触发点在任务内固定;真机试验没有注入扰动,真机上的条件恢复只有 build_blocks 的文字描述,没有单独计数。
- 每个骨干都在所选的 10 个任务上做了任务专属微调;表 A1 列的是所选子集,不是两个基准的全部任务。三个对照是作者改造的版本,其实现细节决定了比较的公平程度。
- 论文没有报告在线检查和修复的运行时间与资源开销,作者把它列为未来工作;VLM 用的是 GPT-4o,换模型后的表现所读正文没有给出。
- 仿真结果没有置信区间;真机每个任务 10 次,作者说明置信区间很宽。所有结果都不是硬件安全验证。
链接
- LOGIV: Graph-Verified Execution with Causal Local Repair for Long-Horizon Robot Tasks(arXiv 2610.40016)
- 论文 HTML 全文
- 物理AI实验室 0.3:看-想-动,把三个频率放回各自的系统
- 物理AI实验室 1.8:评测,把“净增 2”拆成配对表,再给失败标签和随机种子算一笔账
- 前沿雷达|RESETTLE:冻结策略的两次采样持续分歧才介入,按示范参考只执行一个纠正动作
- 前沿雷达|SCOPE:规划器求解失败时不丢样本,反推缺失前提补进场景图,用来生成长程任务规划的微调数据
- 前沿雷达|Cracking Mobile Manipulation:子任务成功率 80%,串成移动操作只剩 19%,先给失败回合归因,再逐段加干预
- 物理AI实验室:一套每个数字都能核对的物理 AI 课程(课程大纲)


