
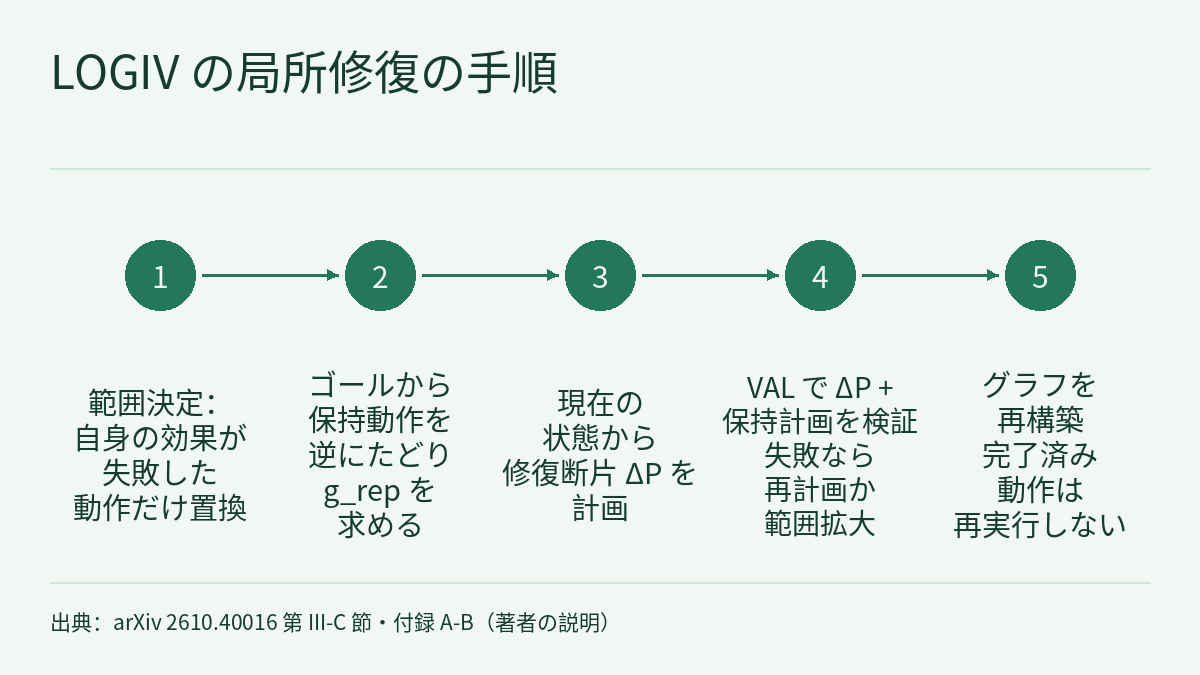
プレプリント LOGIV(arXiv 2610.40016、2026-10-29。著者の所属は香港中文大学(深圳)、A*STAR、Caltech、NUS、HKUST、COCO Matrix、NTU)は、長期タスクで見落とされやすい問題を扱っています。動作が完了しても、その動作が残した条件がずっと成り立つとは限りません。橋を組み立てるときに置いた支柱が、梁をつかむ間にずれることがあります。「支柱を置く」は完了のままですが、後の「梁を置く」に必要な支えはもう失われています。LOGIV は既存の VLA または世界行動モデル(WAM)方策の上に、学習可能なパラメータを持たない実行・修復層を加えます。PDDL の計画をタスクグラフにコンパイルし、実行中は視覚とロボットのフィードバックでそれらの条件を一つずつ確認し、失われたときは影響を受けた部分だけを置き換え、実行を再開する前に後続の計画全体を VAL で検証します。以下の数字はすべて著者の報告 [R] であり、本サイトでは再現していません。
問題:「完了した」と「まだ成り立つ」は別のこと
論文の出発点は、信頼できる長期実行には、動作が完了したかどうかと、その結果が成り立ち続けているかどうかの両方を追跡する必要がある、という点です。LOGIV の中心的な設計はこの二つを分けることにあります。ノードの完了状態と、それが後続の動作に与えている支えがいま有効かどうかは別の情報です。支えが失われても完了済みノードは再び開かれず、それに依存する未完了の動作も計画に残ります。修復は、それらの前提条件を立て直すことだけを担います。論文は BiCoord の build_bridge タスク(図 1)でこれを示しています。支柱がずれたあと、LOGIV は支柱に関わる操作だけを修復し、梁に関わる操作は残したまま、更新したタスクグラフで実行を続けます。
著者は、依存関係の追跡そのものを新しい計画原理とは位置づけていないと明言しています。因果リンクの監視や計画修復といった既存研究を土台にしており、新しいのは、視覚による状態評価でこの生産者–消費者の依存関係を更新し、そこから局所修復の範囲を選ぶ点です。
タスクグラフの作り方:2 種類の辺と 1 本の参照順序
入力は PDDL の Domain(再利用可能なオペレータとそのパラメータ、前提条件、効果)と Problem(物体、初期状態 S0、ゴール g)です。Fast Downward の LAMA-first が具体化されたオペレータの列を探索し、VAL が動作の束縛、前提条件、モデル化された効果、最終ゴールを独立に検査します。検査に失敗すると VAL は失敗の位置と理由を返し、その列を除外して探索をやり直します。検証に通ってはじめてグラフを構築します。
- 因果辺。各オペレータの各前提条件について、それより前のオペレータを逆順にさかのぼり、その条件を生み出し、途中で他のオペレータに打ち消されていない直近のものを探し、その条件をラベルにした辺を張ります。
S0から来る条件は START ノードを起点とし、ゴール条件は GOAL ノードにつながります。論文は、ここでの「因果」は PDDL の意味での条件の支えであり、学習した因果モデルではないと断っています。 - リソース辺。アームやグリッパーのような排他的リソースと、モデル化された干渉(あるオペレータが、別のオペレータが必要とする、または確立する条件を打ち消すこと)について順序を保ちます。
どちらの辺も参照計画 P の順序に従うので、グラフは非巡回で、P はそのトポロジカル順序の一つになります。論文は、ほかのトポロジカル順序が妥当とは限らないため、実行順序はオンラインで確認すると注意しています。
実行中の 3 つのチェック
スケジューリングでは、先行ノードがすべて完了した動作のうち、P の中で最も早く、実行条件が成り立っているものを選び、自然言語の指示と現在の画像を下位の方策に渡します。各ノードは実行前と実行後に 1 回ずつ確認されます。
- State Gate:VLM(GPT-4o、1 回の呼び出しで最大 512 出力トークン)が画像から現在の動作とその依存関係に関する事実を抽出し、ロボットの状態とアクチュエータのフィードバックと合わせて記号状態をつくります。証拠が足りないときは画像を取り直す、視点を変える、確認を繰り返すといった対応を取り、追加の観測は最大 3 回です。それでも確認できなければ UNRESOLVED となり、実行を停止します。
- Node Gate:実行前に前提条件を確認し、満たされていないことが確定すれば PRECONDITION_FAILURE で失敗を返します。実行後は期待される効果を確認し、通過したときだけノードを完了とします。
- Graph Gate:実行前にリソース上の先行ノードと条件の支えを確認します。実行後は、START と完了済みのすべての動作が与えている支えが、残りの動作と GOAL に対してまだ成り立っているかを確認します。
したがって、梁をつかむ間に支柱がずれた場合、つかむ動作自体が成功していても EFFECT_FAILURE として修復が始まります。失敗記録には、失敗の種類、ノード、満たされていない条件、失われた辺が含まれます。
修復:何を残し、何を置き換え、どう検証するか
修復の最初の段階では、「影響を受けた動作」と「置き換えるべき動作」を区別します。影響を受けた動作とは、失敗が検出された未完了の動作、または失われた支えに直接依存する未完了の動作と、それらの未完了の因果的後続です。最初に置き換えられるのは、直前に実行され、自身の効果が失敗した動作だけです。前提条件が欠けている動作は残され、修復がまずその前提条件を回復します。完了済みの動作の支えが失われた場合、その動作は完了のままで、その消費者も残されます。
残った未完了の動作が保持計画 P_keep になります。システムはゴール g から出発し、保持した動作を逆順にたどって、それらの実行を再開する前に成り立っていなければならない条件 g_rep を求めます。保持した動作がまだ必要な条件を削除する場合や、互いに矛盾する条件が現れた場合は、実行不可能と判定します。論文の例では、保持した「梁をつかむ」動作は gripper_empty を必要とし、自分で holding(beam) を生み出します。そのため修復は、つかむ前にグリッパーを空けておけばよく、holding(beam) をあらかじめ成り立たせる必要はありません。
次に、プランナが現在の状態から g_rep を達成する修復断片 ΔP を生成して P_keep の前につなぎ、VAL が後続の計画全体で g に到達できるかを検査します。失敗箇所が修復断片の中にあれば同じ範囲で計画し直し、同じ候補が繰り返されれば修復を打ち切ります。失敗箇所が保持した動作にあれば、置き換えの範囲をその動作とその未完了の因果的後続まで広げます。計画の失敗、タイムアウト、失敗箇所を特定できない場合は、論文の付録にある決定的な規則でフォールバックします。検証に通るとタスクグラフを再構築します。完了済みの動作は完了のままで再実行されず、まだ有効なその効果は現在の状態と新しい START ノードで表されます。
予算は具体的に定められています。計画 1 回あたり 30 s、VAL 1 回あたり 5 s。1 回の失敗につき局所修復は最大 3 ラウンド、VLM 呼び出しは最大 4 回で、超えるとそのエピソードは終了します。すべての実験で人による支援は無効にされています。著者は、VAL を通過しても、計画が記号モデルと与えられた状態に整合していることを示すだけで、知覚の正確さや物理的な成功は保証しないと述べています。修復が最小または完全であることも保証されません。
結果:シミュレーションの 2 ベンチマークと実機の 3 タスク
設定。RoboTwin V2 と BiCoord からそれぞれ 10 の双腕タスクを選び、タスクごとに 10 の初期状態をあらかじめ定めています。したがって各ベンチマーク・各設定は 100 エピソードです。外乱なしの設定では各初期状態を 1 回ずつ実行します。外乱ありの設定では同じ初期状態を使い、あらかじめ決めたイベントで回復可能な外乱を 1 回加えます。外乱の種類と発生タイミングはタスク内で固定です。たとえば move_can_pot では、缶をつかんで持ち上げたあとに鍋が横方向に 10–15 cm ずらされます。3 つの実行バックボーン π0.5、AHA-WAM、Light-WAM は、いずれも各ベンチマークの 10 タスクでタスクごとにファインチューニングされており、学習に使った専門家デモには評価時の外乱が含まれていません。比較手法 VeriGraph-PDDL、LERa-PDDL、VLM-RP-BT は、元の手法の考え方をもとに著者が改変した版であり、元のシステムをそのまま実装したものではありません。
外乱なし(C)。3 つのバックボーンの平均成功率は、RoboTwin V2 で 71.67% から 82.33% に、BiCoord で 42.33% から 57.67% に上がりました。著者は、外乱を加えなくてもロボットは状態のずれや動作の失敗に出会うためだと説明しています。
外乱あり(P)。次の表は、バックボーン単体、3 つの改変比較手法のうち最も高いもの、LOGIV を並べたものです(数字は論文の表 I から。「最も強い改変比較手法」の列は本サイトが選び出しました)。
| ベンチマーク | バックボーン | バックボーン単体 | 最も強い改変比較手法 | LOGIV |
|---|---|---|---|---|
| RoboTwin V2 | π0.5 | 32 | 58(VLM-RP-BT) | 60 |
| RoboTwin V2 | AHA-WAM | 60 | 80(VLM-RP-BT) | 83 |
| RoboTwin V2 | Light-WAM | 58 | 70(VLM-RP-BT) | 72 |
| BiCoord | π0.5 | 31 | 45(VLM-RP-BT) | 48 |
| BiCoord | AHA-WAM | 43 | 48(LERa-PDDL と VLM-RP-BT が同率) | 53 |
| BiCoord | Light-WAM | 39 | 46(VeriGraph-PDDL) | 49 |
単位は % です。LOGIV は 6 組すべてで 3 つの比較手法を上回り、条件回復率(R)でも同様です。本サイトの読み方は 2 点です。第一に、6 組のうち 5 組では、バックボーンからの向上の大部分を最も強い改変比較手法がすでに得ており(BiCoord と AHA-WAM の組では半々)、LOGIV が最も強い比較手法を上回る幅は 2–5 ポイントです。第二に、各セルは 100 エピソードなので、2 ポイントは 2 エピソードに相当します(本サイトの換算)。読んだ本文には、シミュレーション結果の信頼区間や有意性検定はありませんでした。論文はまた、R の分母は各手法それぞれの「対象となる」外乱イベントであり、イベントの集合は手法ごとに異なりうるので、P と合わせて読むよう注意しています。
実機。2 台の双腕プラットフォームで、π0.5 と π0.5 + LOGIV は同じチェックポイントと同じデモを使い、タスクごとに 10 試行、初期配置をそろえて評価しています。指示全体を完了した場合だけを成功とします。実機試行では外乱を加えていません。
- pick_tomato(Astribot S1):7/10 → 9/10。空振りの把持や早すぎる手放しから回復しました。
- build_blocks(Astribot S1):3/10 → 5/10。後の動作で手を伸ばした際にすでに置いたブロックがずれると、Graph Gate が残りの配置に必要な条件が成り立たなくなったことを検出し、修復はそのブロックだけを元に戻しました。
- insert_cable(AgileX Piper):2/10 → 3/10。残った失敗の多くは、プラグの位置は合っているのに奥まで差し込めないもので、計画ではなく下位方策の接触精度に左右されます。
- 合計 12/30(40.0%)→ 17/30(56.7%)。著者自身、タスクごとに 10 試行では信頼区間が広く、傾向を示すにとどまると書いています。
アブレーション(RoboTwin V2 の 10 タスク、π0.5、各設定 100 エピソード):
- 著者は、State Gate、Node Gate、Graph Gate のいずれを外しても 3 つの成功率指標がすべて下がると述べていますが、読んだ本文に数字があるのは Graph Gate を外した場合だけです。外乱ありの成功率は 60% から 48% に下がり、著者はこれを各変種の中で最も低い値としています。不確実性の処理(UNRESOLVED)を外すと、条件回復率は 72% から 59% に下がります。
- 因果追跡を行わず、線形の計画上の位置で修復ノードを選ぶと、変更されたノードの割合は 24.6% のままですが、外乱なしの成功率は 72% から 61% に、外乱ありは 60% から 52% に下がります。著者はここから、効いているのは変更範囲の大きさだけでなく、どのノードを選ぶかだと結論づけています。
- 局所修復の代わりに残りの全動作を計画し直すと、変更ノードの割合は 100% になり、まだ有効な完了済み動作を再実行する回数は平均 0.2 回から 1.6 回に増え、外乱ありの成功率は 54% に下がります。
- 修復後の計画を VAL で検証しないと、条件回復率は 72% から 62% に、外乱ありの成功率は 60% から 57% に下がります。
本サイトの講座やフロンティア・レーダーとの関係
フィジカルAIラボ 0.3:見る・考える・動く の区分でいえば、LOGIV が変えるのは「考える」のうち遅いほうの層です。下位方策がどう動作を生成するかには手を加えず、次に方策へ何を渡すか、実行後に何を確認するか、誤りのあとに計画のどこを変えるかを決めます。フロンティア・レーダー|RESETTLE では回復は凍結した方策の動作インターフェースで起き、LOGIV では記号的な計画の層で起きます。フロンティア・レーダー|SCOPE は PDDL の計画の失敗を、学習データをオフラインで生成するための手がかりとして使いますが、LOGIV は PDDL と VAL を実行中にオンラインで使います。フロンティア・レーダー|Cracking Mobile Manipulation は、サブタスクをつなぐと成功率が下がる問題を、失敗エピソードの原因を事後に割り当てて扱います。LOGIV の失敗記録は、どのノード、どの条件、どの辺かを実行時に記録します。これらの研究はベンチマーク、バックボーン、外乱がそれぞれ異なるので、数字を互いに比べることはできません。
LOGIV の結果表は、フィジカルAIラボ 1.8:評価 の方法を試す題材になります。各セルが 100 エピソードのとき、2–5 ポイントの差はどれくらい安定しているでしょうか。実機の 12/30 と 17/30 は初期配置をそろえた 2 組の件数なので、何組が良くなり何組が悪くなったかを問うことができます。論文の実機の表にはタスクごとの合計しかありません。
制約と注意点
- これは arXiv のプレプリントで、数字はすべて著者の報告 [R] です。本サイトでは再現していません。論文の 1 ページ目には GitHub リポジトリとプロジェクトページが記載されていますが、本サイトはその内容を開いて確認していません。
- 手法は、事前に書いて固定した PDDL の仕様に依存します。決定的な論理的前提条件と効果、型付きの物体パラメータです。仕様に誤りや条件の漏れがあった場合にどうなるかは読んだ本文では論じられておらず、本サイトの理解では、タスクを変えるには少なくとも新しい Problem が必要で、新しいタスクが元の Domain にないオペレータや条件を必要とする場合は Domain も拡張する必要があります。
- シミュレーションの外乱は 1 エピソードにつき 1 回だけで、事前に定められた回復可能なもの、種類と発生点はタスク内で固定です。実機試行では外乱を加えておらず、実機での条件回復は build_blocks の説明文に出てくるだけで、別に件数は数えられていません。
- どのバックボーンも、選んだ 10 タスクでタスクごとにファインチューニングされています。表 A1 は選んだ部分集合であり、2 つのベンチマークの全タスクではありません。3 つの比較手法は著者による改変版で、その実装の仕方が比較の公平さを左右します。
- 論文はオンラインの確認と修復にかかる実行時間やリソースのコストを報告しておらず、著者は今後の課題に挙げています。VLM は GPT-4o で、ほかのモデルでの結果は読んだ本文にありません。
- シミュレーション結果には信頼区間がありません。実機は各タスク 10 試行で、著者も信頼区間が広いと述べています。どの結果もハードウェアの安全性検証ではありません。
リンク
- LOGIV: Graph-Verified Execution with Causal Local Repair for Long-Horizon Robot Tasks(arXiv 2610.40016)
- 論文の HTML 全文
- フィジカルAIラボ 0.3:見る・考える・動く――3 つの周波数をそれぞれのシステムに戻す
- フィジカルAIラボ 1.8:評価――「差し引き +2」を対応表に分解し、失敗ラベルと乱数シードを計算で確かめる
- フロンティア・レーダー|RESETTLE:凍結した方策の 2 つの動作サンプルが食い違い続けたときだけ介入し、デモを参照して補正動作を 1 回だけ実行する
- フロンティア・レーダー|SCOPE:プランナーが解けないときにサンプルを捨てず、欠けた前提を逆算してシーングラフに補い、長期タスク計画のファインチューニングデータを生成する
- フロンティア・レーダー|Cracking Mobile Manipulation:サブタスクでは 80%、つないでモバイル操作にすると 19%――失敗エピソードの原因を割り当ててから、段階ごとに介入する
- フィジカルAIラボ:すべての数字を確認できるフィジカルAI講座(講座の概要)


