この回の動画
ナレーションは AI 合成音声です。 動画の章・文字起こし・出典
文字起こし
文字起こし
知行の問い
同じモデルが、パソコンではすごく速いのに。ロボットに載せたら、なんで手足についていけないの?前回は、シミュレーションで方策を調整しました。今回は、それを本物のロボットに載せます。ここで避けて通れないのが三つの言葉。量子化、遅延、制御周波数です。
遅延と制御周波数
まず、鉄則を一つ覚えましょう。制御の一周期ごとに、ロボットはまず今の観測を受け取ります。次の動作を計算して、モーターに送ります。一回の計算に、どれだけかかるか。それで、一秒に最大何回計算できるかが決まります。遅延と周波数は、一枚のコインの表と裏なのです。低レベル制御の側は、どれくらい速いのでしょう。ある論文によると、制御ループは一秒に千回回す必要があります。論文は、これをリアルタイム制御の最低ラインとしています。遅延は、いくつかの区間でできています。画像の読み込み、前処理、モデルの推論。最後に、動作を送り出します。通信もあります。センサーから計算機へ、計算機からモーターへ、どれも配線を通ります。足し合わせると、これも無視できません。その裏にあるのが、ハードリアルタイムの要求です。一歩一歩、必ず時間ちょうどに届けなければなりません。少しでも遅れると、すべてが水の泡になりかねません。なぜ、そこまで速くないといけないのでしょう。一拍遅れると、接触力が行き過ぎます。滑るか、物を壊してしまいます。言い換えると、あなたがまばたきする間に、ロボットはもう何度も静かに修正しています。速すぎて、目には見えません。では、大規模モデルは?視覚・言語・行動モデルは、一回考えるのがずっと遅いのです。Amazonの実測では、そうしたモデルの一つが一秒に約五回、計画し直していました。両方を比べると、周波数は二桁以上も違います。たとえ話ではありません。本物の大きな差です。これが「大脳はゆっくり考え、小脳はすばやく動く」ってことか!違いは周波数なんだ!もう一つ、落とし穴があります。実際のシステムが見るのは、平均の遅れではありません。いちばん遅い一回、テールレイテンシです。たまに引っかかっても、平均値にはほとんど表れません。でもロボットは、その一回で転ぶかもしれません。だから、最悪のケースを見張り続けるのです。速度を上げたいなら、まずどの区間が一番遅いかを見ます。たいていは、モデルの推論です。だから、そこに手をつけます。
量子化:モデルを小さく
小さな機器でモデルを動かすには?一つ目の手は、量子化です。より少ないビット数で、保存して計算します。どういうことでしょう。広い範囲の連続した値を、限られた数段階の整数に割り当てます。そして、倍率を一つ覚えておけば、いつでも元に戻せます。ここで使うのは、動的量子化です。重みを先に八ビットの整数に縮めます。活性化の値は、推論のときにその場で量子化します。まず容量です。PyTorchの公式によると、八ビットの整数にすると、モデルは四分の一になります。これが一番確実な効果です。次に速度です。同じ公式ブログによると、推論は二倍から三倍高速になります。ただし、ハードウェアとモデルしだいです。正確に、誇張せずに言いましょう。今回のノートブックでは、モデルはたしかに四分の一になりました。でもこのCPUでは、かえって遅くなったのです。なぜでしょう。このネットワークは小さすぎるうえに、CPUで動いています。量子化の余分な手間が、節約した計算を上回ったのです。では、いつ速くなるのか。モデルが十分に大きく、メモリの帯域で詰まっているときです。整数は運ぶのも速く、計算も速いのです。もう一つの現実があります。エッジデバイスのメモリは、たいてい驚くほど小さいのです。まず載せられなければ、動かす話もできません。精度がどこまで落ちても許せるかは、作業しだいです。コップをつかむなら、気にならないかもしれません。手術なら、少しの狂いも許されません。量子化だけが手ではありません。枝刈り、蒸留、もっと小さなバックボーンへの交換もあります。よく組み合わせて使います。でも、量子化が一番手軽です。一行のコードで、線形層を整数版に置き換えられます。だから、最初に取り上げました。量子化にも代償があります。本質は近似なので、精度が少し落ちます。幸い、落ち幅はたいていとても小さいのです。量子化は魔法じゃないんだ。容量の節約は確実、高速になるかは場合しだい!
エッジに載せて、本当に動かす
容量を縮めても、計算する場所が必要です。エヌビディアによると、ロボット用の計算モジュール一つで、百三十ワット以内で、最新のモデルを動かせます。なぜ、ロボットの体の中で計算しないといけないのか。クラウドだと往復の通信があり、遅延が大きく、回線が切れる心配もあります。カメラの映像を、外に出したくないこともあります。でも、どんなに速いチップでも、一歩ごとに大規模モデルを回すのは無理です。遅延の壁は、避けられません。工学的な解決は、遅いものと速いものを分けることです。大規模モデルには、低い頻度で考えさせます。一回で、ひとまとまりの動作を考え出すのです。それを、とても速い制御器に渡して、一歩ずつ実行させます。この方法を、アクションチャンキングと呼びます。アクションチャンキングにも、コツがあります。まとまりが長すぎると、新しい状況に反応が間に合いません。短すぎると、元の問題に逆戻りです。だから、その間でバランスを取ります。かなり先まで考えつつ、反応も失わない。これが、エッジ展開の腕の見せどころです。遅いものと速いものを分けると、おまけの利点もあります。安全チェックのような仕事を、その速いループに専用で入れられるのです。一歩一歩、すべての動作を受け止めます。大事なのは、モデルを速くすることじゃない。速いループの邪魔をしないことなんだ!こうして、遅いプランナーは自分のペースで考えます。速い制御器は自分のペースで動きます。二つの周波数が、それぞれの道を進むのです。まだ解決していないこともあります。遅延は減っただけで、消えてはいません。通信が揺らぐと、まとまりとまとまりの間がつながらないこともあります。そのときは、誰かが受け止めないといけません。今回のノートブックを開いて、一緒にやってみましょう。量子化の前と後で、遅延を一回ずつ測ります。それを、何ヘルツで動かせるかに換算します。あの鉄則を、自分の目で確かめられます。遅延の逆数が、制御周波数の天井です。数字はうそをつきません。ふりかえりです。ポイントは三つ。一つ、遅延が周波数の上限を決める。逆数の関係です。二つ、量子化で確実なのは容量の節約。速くなるかは実測が必要。三つ、遅い計画と速い制御を組み合わせ、チャンキングで切り離す。大規模モデルをクラウドから下ろして、ロボットに載せる。必要なのは速いチップじゃなくて、賢い役割分担なんだ!でも、もしモデルが危ない動作を計算したら、誰が止めるの?また次回!
根拠と出典
練習とセルフチェック
小テストは公開で、回答するとすぐ解説が出ます。読み物の練習問題の答えはログイン会員向けです。
第 2.6 回の動画は、前回シミュレーションで調整した方策をロボットに載せ、三つのことを説明します。制御周波数の上限は一周期の遅延の逆数であり、実際のシステムで見るべきなのは平均ではなくテールレイテンシであること。量子化で一番確実な効果は容量の削減(int8 で約四分の一)で、速くなるかはハードウェアしだいで実測が必要なこと。大規模モデルは考えるのが遅く、低レベル制御は速くなければならないので、工学的には動作チャンク(アクションチャンキング)で両者を切り離し、遅延は消えずに管理されるだけであること。動画の四枚の数字カードは、四つの公開資料から取られています。multipanda_ros2 の論文(arXiv 2602.02269)は、1 kHz の制御周波数を維持することが自らのリアルタイム制御に不可欠で、安全規格が求める最低の周波数でもあるとしています。AWS のブログは、π0 が H100 上で ODE を 1 ステップだけ解くと、50 ステップの動作チャンクを 200 ms 未満で生成し、一秒に約 5 回計画し直せると報告しています。PyTorch のブログは、量子化でモデルの容量が 4 分の 1 になり、推論が 2〜3 倍速くなる、ただしハードウェアとモデルしだいだと述べています。NVIDIA のブログは、Jetson Thor が 130 W の電力の範囲内で最大 2070 FP4 TFLOPS の AI 演算性能を持つとしています。このページはこの回の解説と練習です。文字起こしは繰り返さず、動画が触れるだけにとどめた三つのことを行います。四つの数字をそれぞれのシステムに戻し、どれが制御ループ、どれがプランナー、どれがモデルの容量、どれが消費電力の話かを見分けます。架空の数字を使い、各区間の遅延から周波数の上限、時間超過の回数までを一通り計算します。そして「量子化で何が減るのか」を重みの容量、実行時のメモリ、遅延の三つの帳簿に分け、最後に遅いプランナーの再計画周期と動作チャンクの長さを決めます。全体を通じたルールは一つです。周波数、遅延、倍率は、それを測った、または公称したシステム、ハードウェア、設定のものです。別のシステムの数字を掛けたり割ったりしてはいけませんし、一台のロボットの仕様に組み合わせてもいけません。
この回の動画、文字起こし、出典はこのページの上部にあります。シーズン全体の構成は講座の概要をご覧ください。前回のフィジカルAIラボ 2.5:sim2real のドメインランダム化とシステム同定――二本の論文の数字を元の設定に戻し、コップを押した一本の軌跡から摩擦を手で求めるは、最後に「パラメータが合ったら、モデルをロボットに載せたとき、遅延と計算資源はどこで足を引っぱるのか」と問いかけました。この回はその答えです。三つの周波数がそれぞれどのシステムのものかはフィジカルAIラボ 0.3:見る・考える・動く――3 つの周波数をそれぞれのシステムに戻すで、周波数を周期に直す計算はフィジカルAIラボ 1.2:PIDと制御周波数――3 つの項を手で計算し、周波数を周期に直すで、Jetson Thor の前世代に対する演算性能の倍率はフィジカルAIラボ 0.2:なぜ今なのか、データ・モデル・計算資源の 3 本の曲線で、非同期推論での動作キューの時間の余裕はフィジカルAIラボ 2.3:SmolVLA をファインチューニングする――指示に合わせてお手本を計画し、各数字が何を測ったかを確かめ、非同期の動作キューの時間を計算するで、成功率の対応づけと失敗の分類はフィジカルAIラボ 1.8:評価――「差し引き +2」を対応表に分解し、失敗ラベルと乱数シードを計算で確かめるで、すでに扱いました。この回ではそれらを繰り返さず、この回で新しく使う四つの資料と、遅延・量子化・動作チャンクのあいだで計算しておくべきことだけを扱います。安全チェックを速いループにどう組み込むかは、次回 2.7(制御バリア関数)の内容です。
公開小テストの 5 問には詳しい解説が付いています。ログインすると、三つの練習に取り組めます。架空の 20 周期分の遅延ログから、中央値・平均・最悪値のそれぞれに対応する周波数の上限を求め、三つの目標周波数での時間超過の回数を数える。架空の量子化の測定表を読み、重みの容量・実行時のメモリ・遅延を分けて記録し、四つの主張を判定する。架空のエッジ展開の計画を審査し、遅いプランナーの再計画周期と動作チャンクの長さを決め、三つの資料を引用した文を書き直す。いずれにも段階的な解答例、よくある誤り、20 点満点の採点基準が付いています。
1. 四つの数字は、それぞれどのシステムのものか
動画の四枚の数字カードは、原文の四つの文に対応します。以下に一つずつ独立に引用します。この講座の区分では、論文は R レベル、三つのメーカーまたは公式のブログは O レベルです。数字はすべて著者またはメーカーの報告で、本サイトはどれも再現していません。
multipanda_ros2 の論文(Škerlj ら、arXiv 2602.02269。ページには ICRA 2026 で発表された版であることが記されています)の要旨:
A central focus of this work is sustaining a 1kHz control frequency, a necessity for real-time control and a minimum frequency required by safety standards.
AWS のブログ Fine-Tuning π0 (Pi-Zero) for robotic manipulation on Amazon SageMaker HyperPod EKS:
At 1 ODE step on H100, a full 50-timestep chunk takes under 200 ms, so the policy can re-plan at about 5 Hz while each chunk covers roughly one second of robot motion.
PyTorch のブログ Introduction to Quantization on PyTorch:
Quantization provides a 4x reduction in the model size and a speedup of 2x to 3x compared to floating point implementations depending on the hardware platform and the model being benchmarked.
NVIDIA の技術ブログ Introducing NVIDIA Jetson Thor, the Ultimate Platform for Physical AI(2025-08-25):
Jetson Thor delivers up to 2070 FP4 teraflops of AI compute within a 130 W power envelope.
| 動画での言い方 | 誰の数字か | 原文の条件 | 原文が言っていないこと | レベル |
|---|---|---|---|---|
| 一秒に千回、リアルタイム制御の最低ライン | multipanda_ros2:ros2_control を土台に、一つのプロセスから複数台の Franka Robotics のロボットを制御するオープンソースの ROS 2 フレームワーク | そのリアルタイムのトルク制御ループ。第 II 節は、1 kHz の低レベルのトルク指令ループによって上位の制御器が関節を理想的なトルク源として扱えるとし、ISO 10218 などの安全規格が衝突検知に 1 kHz の計測周波数を定めていると述べています | プランナーや VLA が 1 kHz で動く必要があるとは言っていません。この回では ISO 10218 の原文を確認していません | R(著者の報告) |
| 一秒に約五回、計画し直す | π0:Physical Intelligence の 30 億パラメータの VLA。ブログが使うのは LeRobot への移植版 lerobot/pi0_base | H100 一枚、ODE の積分 1 ステップ、50 ステップの動作チャンク一つを 200 ms 未満で生成、各チャンクはロボットの動き約 1 秒分 | エッジデバイスでの測定ではありません。ブログの精度の評価は、取り置いたエピソードのうち最初の 5 回の平均だけです | O(メーカー自身の測定) |
| 四分の一になり、二〜三倍速くなる | PyTorch の int8 量子化。ブログは、PyTorch 1.3 で量子化が導入され、1.4 で量子化済みモデルが公開された時期のもの | 浮動小数点の実装との比較。速度向上はハードウェアと測定対象のモデルしだい | どのモデルの速度向上も保証していません。4 倍は容量で、速さではありません | O(公式ブログ) |
| 百三十ワット以内で最新のモデルを動かせる | Jetson Thor。仕様表では Jetson T5000 モジュール | 最大 2070 FP4 TFLOPS(仕様表では Sparse FP4)、電力の範囲は 40〜130 W | どのモデルのロボット上での遅延でもありません。2070 はピークの演算性能です | O(メーカーの説明) |
この表を読むときの注意点は四つです。
- 約 5 Hz は、それ自体が逆数の計算です。ブログは「チャンク一つが 200 ms 未満」から「約 5 Hz」を導いています。1 ÷ 0.2 s = 毎秒 5 回です。これはこのハードウェアでこのプランナーが計画し直せる回数の上限であり、ロボットの低レベルのループの周波数ではありません。同じブログは、LIBERO で ODE のステップ数を 10 から 1 に減らすと、精度を落とさずに遅延が 379 ms から 197 ms に下がったとも報告しています。時間を減らす方法は量子化だけではありません。
- 「二桁以上の差」は、二つのシステムを並べたものです。動画は約 5 Hz と 1 kHz を並べて、大規模モデルのプランナーと低レベルのトルクループの周波数がどれほど離れているかを示しています。5 Hz は H100 上の π0、1 kHz は Franka の多腕フレームワークのもので、一台のロボットで測った比ではありません。0.3 で使った π0 の論文の数字(50 Hz で動くロボットで、25 個の動作を実行するごとに、約 0.5 秒ごとに推論し直す)もまた別の条件で、AWS の数字と合わせてはいけません。
- 1 kHz は、すべてのロボットに共通の値ではありません。論文の表 I に並ぶトルク制御ロボットの多くは指令周波数が 1 kHz ですが、Boston Dynamics Atlas 1(2013)は 333 Hz、Berkeley Blue(2019)は 170 Hz です。著者は、これがすべてを網羅した一覧ではないと断っています。
- 130 W の文は、ページ上部の「AI が生成した」と表示された要約にあります。本文の対応する文は、開発者キットが Blackwell GPU と 128 GB のメモリで動き、130 W の電力の範囲内で最大 2070 FP4 TFLOPS を出して最新の生成 AI モデルを動かせると述べています。仕様表は T5000 モジュールの電力を 40〜130 W としています。いずれもメーカーによるハードウェアの能力の説明で、その上で動くどのモデルの遅延も示していません。
ログインすると、このレッスンの続きと確認問題、解答を読めます。
制約と注意点
- multipanda_ros2(arXiv 2602.02269)は R レベルで、ページには ICRA 2026 で発表された版であることが記されています。1 kHz、表 I の周波数、ISO 10218 についての記述は、いずれも著者の記述です。この回が読んだのは要旨から手法の節の冒頭までで、ISO 10218 の原文は確認しておらず、論文の実験結果も読んでいません。
- AWS のブログは O レベルで、メーカーが自分の設定で測ったものです。π0 の LeRobot 移植版、H100 一枚、ODE 1 ステップで、精度の評価は取り置いたエピソードのうち最初の 5 回だけです。本サイトは再現していません。
- PyTorch のブログは O レベルで、PyTorch 1.3 と 1.4 の時期のものです。API の名前、バックエンドの対応、例の数字はその版のもので、この回では後の版を確認していません。
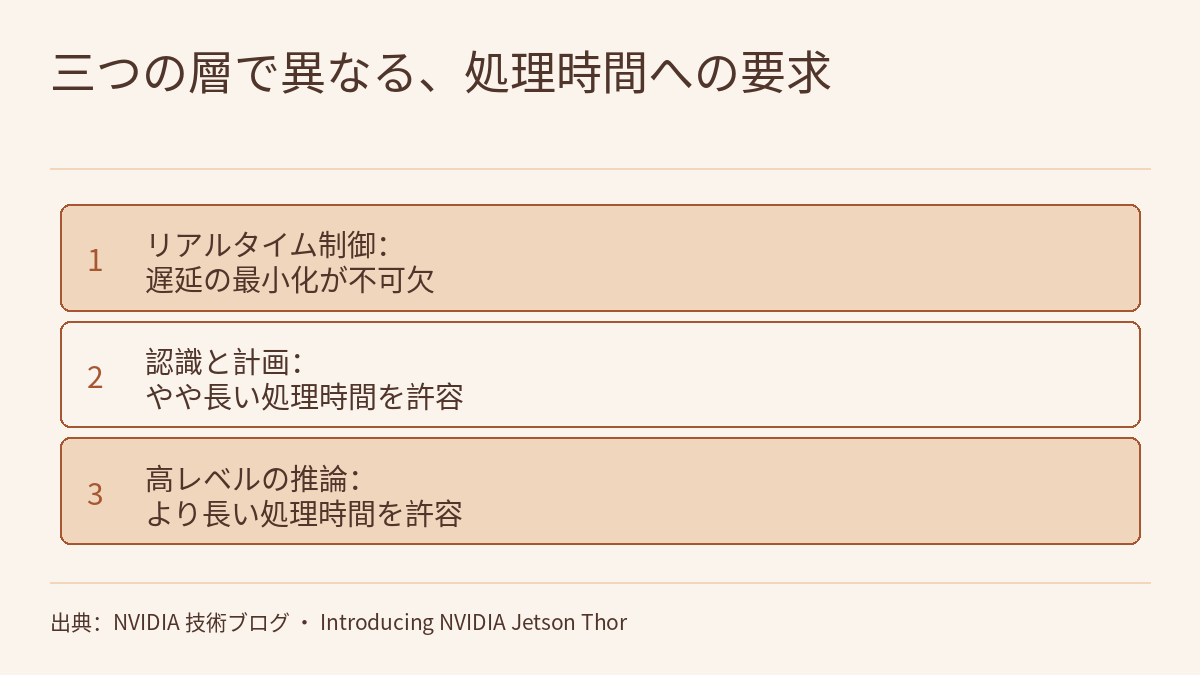
- NVIDIA のブログは O レベルです。動画で使われた 130 W の文は、ページ上で AI が生成したと表示された要約にあり、本文と仕様表の記述もそれと一致しています。2070 FP4 TFLOPS はピークの演算性能で、仕様表は T4000 の数字を暫定としています。四つの層はメーカーによる典型的な人型ロボットの説明で、規格ではなく、ミリ秒の数字もありません。図では、原文が時間の要求を示していないハードウェア抽象化の層を省いています。
- 動画の Notebook の「四分の一になったが、CPU ではかえって遅くなった」は、動画の説明どおりに紹介しているだけです。この回では Notebook を実行しておらず、保存された具体的な遅延も読んでいません。
- 次の点はこの回の補足、モデル化の選択、推論で、原文にはそう書かれていません:一周期が直列に進むという前提とパイプラインについての補足、最悪の反応時間を約 P + L(往復時間を加える場合も含む)とするモデルと「チャンク一つは少なくとも P + 最悪の L を含む」という安全側の単純化、測定と評価の進め方の提案、1 MB = 10⁶ バイトとしスケール係数を無視した計算、AWS の「メモリで制約されていない」を直後の説明から VRAM の容量の話と読んだこと。
- 第 2〜5 節のロボット R と R6、方策ネットワーク S・Q・T、デバイス A と E、プランナー V、チーム W、そしてすべての遅延、パラメータ数、メモリ、誤差、往復時間、作業の要求は架空です。20.8 Hz、25 Hz、1.83 倍、0.72 s などは、これらの仮定のもとでだけ成り立ちます。
- 紙の上の計算とシミュレーションの結果は、ハードウェアの安全性の検証ではありません。時間超過や途切れのときの受け止めの動きには別に安全性の分析が必要で、実機での試験には別に安全の準備が必要です。
リンク
- フィジカルAIラボ:すべての数字を確認できるフィジカルAI講座(講座の概要)
- フィジカルAIラボ 2.5:sim2real のドメインランダム化とシステム同定――二本の論文の数字を元の設定に戻し、コップを押した一本の軌跡から摩擦を手で求める
- フィジカルAIラボ 2.3:SmolVLA をファインチューニングする――指示に合わせてお手本を計画し、各数字が何を測ったかを確かめ、非同期の動作キューの時間を計算する
- フィジカルAIラボ 1.8:評価――「差し引き +2」を対応表に分解し、失敗ラベルと乱数シードを計算で確かめる
- フィジカルAIラボ 1.2:PIDと制御周波数――3 つの項を手で計算し、周波数を周期に直す
- フィジカルAIラボ 0.3:見る・考える・動く――3 つの周波数をそれぞれのシステムに戻す
- フィジカルAIラボ 0.2:なぜ今なのか、データ・モデル・計算資源の 3 本の曲線
- フロンティア・レーダー特集|エッジとリアルタイム性:VLA と世界行動モデルのレイテンシ予算はどこに使われているか(レーダーの 9 月アーカイブにある、ほかの 9 件の資料のミリ秒値)
- Bridging the Sim-to-Real Gap with multipanda_ros2: A Real-Time ROS 2 Framework for Multimanual Systems(arXiv 2602.02269)
- AWS:Fine-Tuning π0 (Pi-Zero) for robotic manipulation on Amazon SageMaker HyperPod EKS
- NVIDIA 技術ブログ:Introducing NVIDIA Jetson Thor, the Ultimate Platform for Physical AI(2025-08-25)
- PyTorch ブログ:Introduction to Quantization on PyTorch