この回の動画
ナレーションは AI 合成音声です。 動画の章・文字起こし・出典
文字起こし
文字起こし
知行の問い
同じ一本のアームなのに、短い指示を出すだけで、なんでその通りに動くの?今回は、公開されている学習済みモデルをファインチューニングします。短い指示を理解させて、物をつかませます。
言葉の指示から動作へ
前回のACTは、一つのタスクしかできません。言い方を変えると、通じません。言葉を学んでいないからです。なぜ一つだけなのか?あの一組のデモだけを見て学ぶからです。教わっていないことは、できません。私たちが欲しいのは、こうです。短い指示と、目の前の画像を渡す。すると、やるべき動作を出力する。ロボットにとって、この短い指示がタスクです。まず理解して、それから動きます。こうしたモデルには名前があります。視覚・言語・行動モデル、略してVLAです。三つのものを一緒に取り込みます。画像、ロボットの状態、そしてあなたの指示です。一つでも欠けると、うまくつかめません。利点ははっきりしています。言い方や目標を変えても、学習し直さずに済みます。試しにやらせることもできます。たとえば、「箱に入れて」と言ったり、「左に置いて」と言ったり。同じモデルで、どちらも試しにやらせられます。うまくいくかは、学習データに似た指示があるか次第です。でも基盤モデルは、あなたのアームも机も見たことがありません。だから、ファインチューニングが必要です。ドキュメントは、まず五十本ほどのデモを収録するよう勧めています。
SmolVLAとは
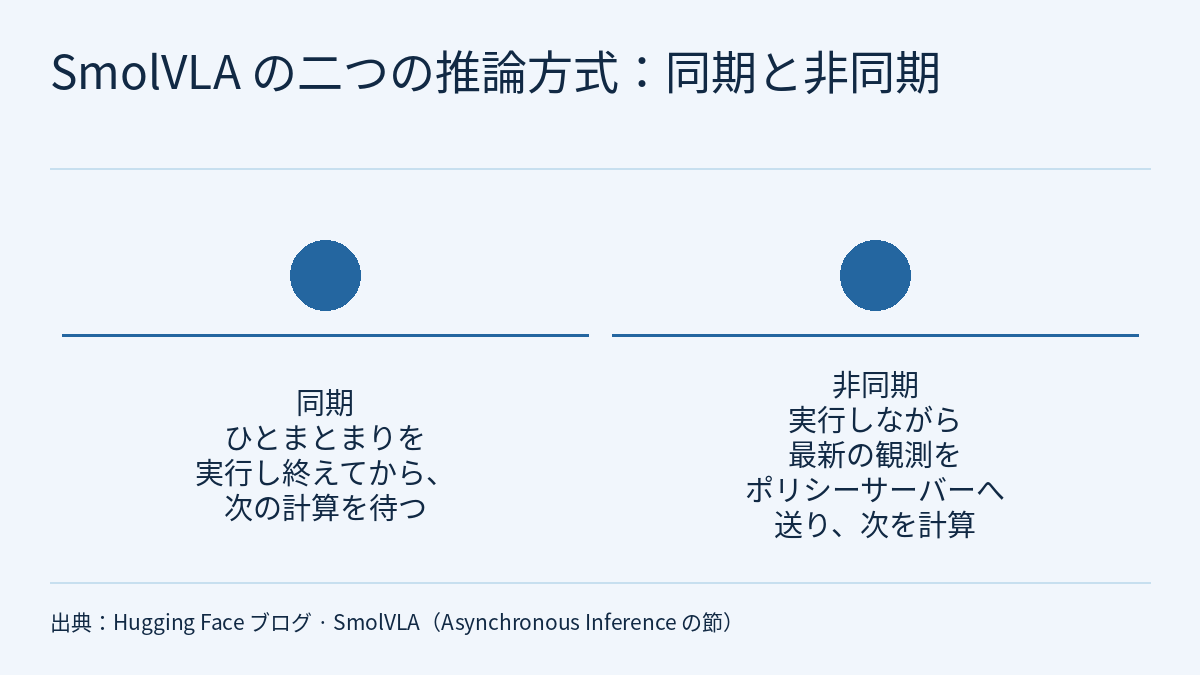
使う基盤モデルは、SmolVLAの基本版です。ハギングフェイスが公開していて、そのままダウンロードできます。膨大な画像と文章を見てきたモデルの、肩の上に立っています。だから、コップも箱も、もともと分かります。言葉の面は、とっくにお手のものです。つまり、世界を知る仕事は、大きなモデルが代わりにやってくれます。こちらは、動作を学ぶことに集中すればいいのです。大きくはありません。公式ブログによると、四億五千万パラメータの、コンパクトなモデルです。論文によると、とても小さいのに、十倍大きいモデルに迫る性能を出せます。どうやって動作を出すのか?アクションエキスパートを使います。ランダムなノイズを、一歩ずつなめらかな動作に整えていきます。なぜこの方法なのか?ひとまとまりの動作を一気に出せて、一つずつ飛び飛びに出さなくて済むからです。動作がなめらかなら、ロボットは震えません。震えると、物を倒したり、つかみ損ねたりします。もう一つ得意技があります。非同期推論です。動作を実行しながら、裏で次のまとまりを計算します。利点は?チームによると、応答が約三割速くなり、一定時間にこなせるタスクの数は倍になります。短い言葉で指示できて、しかも小さなGPUで動く小型モデルなんだ!
実際にファインチューニング
今回のノートブックを開きます。必要なライブラリを入れて、GPUが使えるか確かめます。このGPUの確認は欠かせません。GPUがないと、ファインチューニングは遅すぎて実用になりません。手元になければ、クラウドで借りる手もあります。データは前回と同じ、小型アームで物をつかんで置くデータです。同じデータで、賢いモデルに替えます。もう一度集める手間も省けます。モデルだけ替えるのは、比べてみたいからです。同じデータで、VLAはどこが強いのか。学習させれば分かります。まずデータを見ます。どのデモにも、短いタスク説明が付いています。それこそ、理解させたい言葉です。肝心なのは、基盤モデルからファインチューニングすること。ゼロから学習しません。基盤モデルは、多くの操作を見てきました。データも時間も節約できます。ファインチューニングでは、基盤モデルの力の大部分はそのまま。あなたのデータに合わせて、少しだけ調整します。ベテランの職人が、新しい弟子を育てるようなものです。基礎はもうある。あとは、その仕事のコツを教えるだけです。コマンドは一行。基盤モデルの場所、データの場所、GPUで計算すること。それを伝えます。肝心な設定は、この三つだけ。残りのパラメータは、まずデフォルトのままにします。最初に回すと、GPUメモリが足りないかもしれません。一度に処理するデータ量を減らしましょう。少し遅くなりますが、小さなGPUにも収まります。一度に処理する量とステップ数は、まず小さくしてスモークテスト。うまく通ったら、ドキュメントに沿って大きくします。本番のファインチューニングは、どれくらいかかるのか?ドキュメントによると、二万ステップで、A100一枚でおよそよじかんです。学習中は、いつも通り損失を見張ります。評価は?モデルを実機に戻して、同じ指示でやらせます。評価も一回だけで済ませないこと。言い方や置き方をいくつも試して、はじめて正しく見えます。数字にも中身が伴います。
結果と限界
次は結果です。よく物語る数字が一つあります。コミュニティデータでの事前学習の話です。チームの実験によると、事前学習を済ませると、SO-100での成功率は七十八点三パーセントに跳ね上がりました。事前学習とは、まず大量の操作で基礎を固めること。それから、あなたの小さなタスクを学びます。基礎が厚いほど、覚えるのも速くなります。これは大きな流れでもあります。大きなモデルで土台を作り、少しのデータで仕上げる。お金も手間も節約できます。だから順番はこうです。まず事前学習で基礎を固め、それから少しのデータでファインチューニングします。チームによると、非同期推論は邪魔にも強くします。押されても、物をずらされても、作業を続けられます。実機ではこれがとても大事です。つまり非同期は、速いだけではありません。とっさの出来事にも、ロボットがついていけるようになります。ただし非同期には代償があります。裏でポリシーサーバーを動かす必要があり、一層増えます。小さなプロジェクトなら、まずは使わなくて大丈夫です。まだ解決していないこともあります。見たことのない物に替えると、やはり失敗することがあります。もう一つ落とし穴があります。とんでもない指示ほど、でたらめに動きやすくなります。指示は、学んだ言い方に寄せましょう。結局、ただの生徒です。教えたことにしか、うまく答えられません。言葉は柔軟さをくれます。でも汎化は、やはりデータ次第。多いほど、多様なほど、安定します。まとめです。ポイントは三つあります。一つ目、VLAは、画像と短い指示を一緒に動作に変えます。二つ目、SmolVLAは小さく、四億五千万パラメータで、小さなGPUでファインチューニングできます。三つ目、動作しながら計算するので、応答が速くなります。でも見たことのない物には、やはりもっとデータが必要です。短い指示でタスクを変えられるのは、見てきた世界が広くて雑多だからなんだ!じゃあ歩き方を教えるには、シミュレーションで数えきれないほど練習するって、どうやるの?次回をお楽しみに!
根拠と出典
10倍 · 大きいVLAモデルに匹敵。SmolVLAの論文によると、小型ながら約十倍のパラメータ数のモデルと同等の性能 [R] · arXiv 2506.01844 · SmolVLA
30%速く · 応答が非同期推論で約三割速くなり、一定時間にこなせるタスク数は倍に(SmolVLAチーム、実機実験) [O] · Hugging Faceブログ · SmolVLA
練習とセルフチェック
小テストは公開で、回答するとすぐ解説が出ます。読み物の練習問題の答えはログイン会員向けです。
第 2.3 回の動画は、前回の ACT を SmolVLA に替えます。SmolVLA は視覚・言語・行動モデル(VLA)で、画像、ロボットの状態、ひと言の言葉の指示を一緒に動作に変えます。動画のポイントは三つです。VLA は指示も入力として受け取ること。SmolVLA はコンパクト(約 4.5 億パラメータ)で、ゼロから学習するのではなく、公開された基盤モデル smolvla_base からファインチューニングすること。非同期推論は今のまとまりを実行しながら次を計算しますが、見たことのない物への汎化は、やはりデータ次第であること。動画の数字カードは三つの公開資料に基づいています。Hugging Face の SmolVLA ブログ記事、LeRobot ドキュメントの SmolVLA のページ、そして SmolVLA の論文(arXiv 2506.01844)です。このページはこの回の解説と練習です。文字起こしを繰り返すのではなく、動画が軽く触れただけの三つのことを扱います。ひと言の指示が、モデル、データ、評価コマンドのそれぞれで何に当たるかを確かめること。各数字を、それ自身の実験やドキュメントの条件に戻すこと。架空の動作キューを使って、非同期推論が待ち時間をなくせるのはどんなときか、それでも途切れるのはどんなときかを計算することです。全体を通すルールは、数字はそれを出したモデル、プラットフォーム、設定だけを表すこと、そして評価で使う指示は、収録時にデータに書き込んだあの一文までたどれなければならないことです。
この回の動画、文字起こし、出典はこのページの上部にあります。シーズン全体の構成は講座の概要をご覧ください。前回のフィジカルAIラボ 2.2:LeRobot で ACT を学習させる――データセットのメタデータをモデルの入力に対応づけ、学習と評価のコマンドを一項目ずつ確かめるは、ひと言を理解させてから動かすには、どう学習させればよいのか、という問いで終わりました。この回はそこから始めます。lerobot-train の –dataset.repo_id、–policy.device、–output_dir などの引数の読み方と、ステップ数・バッチサイズ・サンプル数を分けて記帳する方法は 2.2 で扱いました。成功率の条件、対応づけ、試行回数を書くことはフィジカルAIラボ 1.8:評価――「差し引き +2」を対応表に分解し、失敗ラベルと乱数シードを計算で確かめるで練習しました。この回ではそれらを繰り返さず、SmolVLA で新たに加わる部分だけを扱います。言葉の指示がどうモデルに入るか、基盤モデルからファインチューニングするためのデータの組み立てとコマンド、そして非同期推論です。
公開小テストの 5 問には詳しい解説が付いています。ログインすると、三つの練習に取り組めます。架空の「左の箱か右の箱に入れる」タスクについて、お手本の本数、指示の文字列、ファインチューニングのコマンドを計画する。公開資料にある八つの数字が何を測ったかの台帳を作り、検算したうえで四つの主張を判定する。架空の非同期の動作キューについて時間の余裕を計算し、三つの運用の主張を審査する。いずれにも段階的な解答例、よくある誤り、20 点満点の採点基準が付いています。
1. 三つの資料がそれぞれ述べていること
Hugging Face のブログ記事と LeRobot のドキュメントは、SmolVLA のチームが自分たちのモデルを紹介したもので、この講座の区分では O レベルです。論文はプレプリントで R レベルにあたり、この回ではその要旨だけを読みました。三つが示す数字はいずれも著者の報告で、本サイトはどれも再現していません。動画の数字カードに対応する原文は次のとおりで、それぞれ独立に抜き出したものです。
ブログ記事:
Today, we introduce SmolVLA , a compact (450M), open-source Vision-Language-Action model for robotics that runs on consumer hardware.
Supports asynchronous inference for 30% faster response and 2× task throughput .
After pretraining on community-collected data, performance jumps to 78.3% , a +26.6% absolute improvement .
論文の要旨:
Despite its compact size, SmolVLA achieves performance comparable to VLAs that are 10x larger.
ドキュメント(一つ目の文は、25 本しかない類似のデータセットについて述べたものです):
it was not enough leading to a bad performance
Training the model for 20k steps will roughly take ~4 hrs on a single A100 GPU.
同じ資料には関連する数字がほかにもあります。下の表はそれらをそれぞれの条件と並べたもので、この回による資料の整理であり、原文の文ではありません。
| 数字 | 出典とレベル | 測っている対象 | ページに書かれた条件 | この回が読んだテキストに書かれていないこと |
|---|---|---|---|---|
| 450M | ブログ、O | SmolVLA モデル全体のパラメータ数 | コンパクトで公開されており、一般向けハードウェアで動く | — |
| 約 100M | ブログ、O | アクションエキスパート(二つの中核部品の一つ)のパラメータ数 | flow matching で学習するコンパクトな Transformer | — |
| 10× | 論文の要旨、R | 約 10 倍大きい VLA と同等の性能 | シミュレーションと実機のさまざまなベンチマークで評価 | 比較したモデルも具体的なベンチマークも要旨には挙げられていない |
| 約 30%(9.7 s 対 13.75 s) | ブログ、O | 非同期が同期より平均で何割速くタスクを終えるか | 実世界のタスク。両方式の成功率は同程度(約 78%) | この段落にはロボットの型も試行回数もない。TL;DR では response と書かれている |
| 2×(キューブ 19 個対 9 個) | ブログ、O | 一定時間内に終えた数 | fixed-time settings | その一定時間の長さ |
| 78.3%(事前学習なしは 51.7%) | ブログ、O | SO100 での成功率。コミュニティデータでの事前学習の有無を比較 | ページは Table 1 の結果として挙げている | 表の中身と試行回数 |
| 約 50 本(25 本では不足) | ドキュメント、O | 最初に収録を勧めるお手本の本数 | 変化の種類ごとに十分なお手本を用意する | 成功率の保証ではない |
| 2 万ステップで約 4 時間 | ドキュメント、O | smolvla_base からのファインチューニングにかかる時間 | A100 一枚。ステップ数は性能と用途に合わせて調整する | この文にはバッチサイズがない(同じページのコマンド例は 64) |
この表を読むときの注意点は三つです。
- 「30%」と「2×」は別の尺度です。結果の段落は、非同期がタスクを約 30% 速く終えること(9.7 s 対 13.75 s)と、一定時間内に終えた数が倍になること(キューブ 19 個対 9 個)を述べています。前者は平均時間、後者は個数で、ページには一定時間の長さが書かれていないため、一方から他方を導くことはできません。
- 「+26.6%」はポイントです。78.3 − 51.7 = 26.6 は絶対差で、相対的な向上は別に計算する必要があります。
- 二つの「78%」をまとめないでください。事前学習の比較の 78.3% と、同期・非同期の比較の「両方式とも約 78%」は、ブログ記事の別々の結果から来ています。この回が読んだテキストには同じ試行群かどうかが書かれていないので、別々に記録します。
ログインすると、このレッスンの続きと確認問題、解答を読めます。
制約と注意点
- SmolVLA のブログ記事は O レベルで、2025 年 6 月 3 日に公開されました。LeRobot ドキュメントの SmolVLA のページは O レベルで、バージョン番号のないアドレスのものを読みました。どちらも 2026-10-17 に取得しています。ブログのコマンドはスクリプトのパス、ドキュメントは lerobot-train を使っており、コマンド名や引数はバージョンによって変わる可能性があります。この回は LeRobot のバージョンを固定していません。論文は R レベルのプレプリントで、この回では要旨だけを読みました。
- 450M、約 100M、10×、約 30%、2×、78.3%、約 50 本、2 万ステップで約 4 時間は、いずれも著者の報告で、本サイトはどれも再現していません。この回が読んだブログのテキストには表の中身が含まれていないため、これらの結果の試行回数は分かりません。同期・非同期の段落にはロボットの型も書かれていません。
- ページのテキストを取り出した際、コマンドのいくつかの等号のあとと ${HF_USER} の両側に空白が入り、–policy.type が途中で分かれていました。この回ではそれらの空白を取り除いています。ドキュメントの、GPU がなければノートブックで学習できるという文は途中で切れており、この回では補っていません。
- 次の点はこの回の推測または仮定で、資料にそう書かれてはいません。70% を、残りのキューがまとまりの長さに占める割合と読むこと。各カメラの 1 枚の画像を 1 フレームと数えること。継ぎ合わせが実際に実行される動作を変えること。新しいまとまりが届いた瞬間に使えること。「変化ごとに 10 本」を計画の目安にできること。
- チーム M と V、block_two_boxes、位置と目標の箱、スモークテストの値、まとまりの長さ、実行の速さ、遅れ、サーバーの置き場所、練習の中の報告は架空の設定です。1.17 s、19.4%、80 本、87.5%、46.7% などはこれらの仮定のもとでだけ成り立ち、どのシステムの性能でもありません。
- このページでは、動画のノートブック、学習コマンド、評価コマンドのいずれも実行していません。評価コマンドとポリシーサーバーは実際のロボットアームを動かします。ハードウェアの安全対策はこの回の範囲外で、紙の上の計算もシミュレーションの結果も、ハードウェアの安全性の検証ではありません。
リンク
- フィジカルAIラボ:すべての数字を確認できるフィジカルAI講座(講座の概要)
- フィジカルAIラボ 2.2:LeRobot で ACT を学習させる――データセットのメタデータをモデルの入力に対応づけ、学習と評価のコマンドを一項目ずつ確かめる
- フィジカルAIラボ 1.8:評価――「差し引き +2」を対応表に分解し、失敗ラベルと乱数シードを計算で確かめる
- Hugging Face ブログ:SmolVLA: Efficient Vision-Language-Action Model trained on Lerobot Community Data
- LeRobot ドキュメント:SmolVLA
- SmolVLA 論文(arXiv 2506.01844)