この回の動画
ナレーションは AI 合成音声です。 動画の章・文字起こし・出典
文字起こし
文字起こし
知行の問い
前回、場面はできたのに、ロボットはまだつかめない。いったい誰から学ぶの?今回は、人が遠隔操作したお手本のデータを使って、つかめる方策を学習させます。すべてリロボットの中で行い、実機に触らなくても始められます。
お手本から方策へ
まず目標をはっきりさせます。アームに渡すのは二つ。見えている画像と、いまの関節の角度です。具体的には、位置の値が六個。腕の関節が五個、グリッパーが一個です。動作は、それぞれの次の目標位置を表します。出力するのは、次にどう動くか。いちばん簡単なのは、ルールを書くことではありません。人のやり方を見せることです。これが模倣学習です。人のお手本を先生にして、方策にまねさせます。なぜルールを書かないのか。コップ一つつかむだけでも、位置、角度、光は千差万別。ルールはとても書ききれません。お手本はどう作るのか。人がもう一本のアームを握って操作します。ロボットはそれに合わせて動き、画像と動作がいっしょに記録されます。記録するとき、画像と動作はぴったり合っていなければなりません。一瞬ずれるだけで、方策は間違って覚えます。リロボットは、いろいろなロボットのデータを一つの形式にそろえます。だから他の人のデータも、そのまま学習に使えます。リロボットのコミュニティが公開しているデータセットを使います。エスオーシリーズのロボットの腕で録った、物を拾って別の場所へ移すお手本集です。中には五十本の実機のお手本。カメラは二台です。一台は上から全体を、一台は横から細部を見ます。どれも画像と動作が同期しています。データの質がとても大事です。お手本がきれいで多様なほど、方策は安定して学びます。雑なお手本は、悪いくせを教えるだけ。
ACT:一度に短いまとまりを
学習させるモデルは、アクト。動作をチャンクに分けて扱うトランスフォーマーです。リロボットがすすめる入門用の方策です。鍵は名前にあります。動作のチャンク化。一歩ずつ予測するのではなく、未来の短いまとまりの動作を一度に出します。まとまりの長さは調整できます。短すぎると、一歩ずつの予測に逆戻り。長すぎると、変化についていけません。なぜまとめるのか。一歩ずつ予測すると、小さな誤差が雪だるま式にふくらみます。動作もぶるぶる震えがちです。中には、画像を見る視覚ネットワークが一つ。トランスフォーマーが画像と関節角をまとめて、動作を出します。視覚ネットワークは画面を読み取り、トランスフォーマーは時間の流れを受け持つ。二つが組むと、動きがなめらかになります。やっていることは複雑でも、体は大きくありません。ドキュメントによると、パラメータはおよそ八千万個だけです。小さくても、実力は十分。ドキュメントによると、わずか五十本のお手本で、高い成功率が出ることが多いそうです。でも弱点もあります。覚えたのは、このつかむタスク一つだけ。話しかけても、わかりません。ルールを書かなくてもいいんだ!五十本くらいのお手本で、高い成功率が出ることが多いんだね。
実際に学習させてみる
今回のノートブックを開きます。一つ目、リロボットを入れて、GPUが使えるか確かめます。データは手でダウンロードしなくて大丈夫。ハブから取得して、ローカルに保存します。まずサンプルを確認してから、学習を始めます。二つ目、データセットを読み込みます。画像の大きさと、動作が何次元かを見ておきます。三つ目、コマンド一行で学習開始。伝えるのは、アクト方策を使うこと、データの場所、GPUで計算すること。どこで計算するか。一言で、クーダ、つまりGPUです。GPUがなければCPUに切り替わりますが、速度はかなり落ちます。学習が始まると、同じことをくり返します。データからランダムにひとまとまり取り出し、どれだけずれているかを計って、パラメータを少し直します。一度に取り出すデータの数は、まず小さく、たとえば八。メモリに余裕があれば、上げていきます。いきなりGPUのメモリをあふれさせないように。一回目は、小さな設定で走らせて、流れが最後まで通るか確かめます。問題なければ、大きくします。小さな設定なら、数分で終わります。エラーがなく、損失が動いていれば、安心して大きくできます。本番の学習はどれくらいかかるのか。ドキュメントによると、GPU一枚で十万ステップの学習に、数時間ほどです。学習中は、一つの数字を見張ります。損失です。着実に下がっていれば、方策の学習は進んでいます。ログには、損失と速度がずっと表示されます。ダッシュボードを開けば、曲線の動きもリアルタイムで見られます。学習は中断して、あとから再開できます。保存したチェックポイントを、いつでも読み込んで続けられます。学習が終わると、チェックポイントが一つ手に入ります。それが学習済みの方策で、いつでも読み込めます。人と共有したい?引数を一つ足すだけで、方策をハブに上げられます。
評価と限界
ここで、はっきりさせておくことがあります。このデータは実機で記録したもので、対応するシミュレーションはありません。実機での評価は、お金も時間もかかります。だから多くの人は、まずシミュレーションで練習し、うまくなってから実機に移ります。だから本当に評価するには、方策を実機に戻して動かし、本当につかめるかを見るしかありません。実機では、カメラとモーターにつながっています。何度も何度もつかんで見せてもらって、はじめて使えるかどうかがわかります。実機には、面倒なことが山ほどあります。キャリブレーション、遅延、摩耗。シミュレーションでは、まず後回しにできますが、実機では一つずつ向き合うことになります。評価は一回だけで終わらせないこと。何十回も走らせて、平均をとります。一回うまくいっても、ただの運かもしれません。実機がなくても大丈夫。シミュレーション付きのタスクに替えて、評価コマンドを使って、標準のベンチマークで採点します。それから、成功率という数字を一つ見ても、すぐに信じないこと。どんな物で、どんな光で、何回試して測ったのかを問いましょう。結局、汎化はまだ難しい問題です。コップを替え、光を変えれば、成功率は下がるかもしれません。だから、数字を一つだけ報告しないこと。テストの条件をきちんと書く。そうしてはじめて、他の人が再現できます。まとめです。ポイントは三つ。一つ、模倣学習。お手本を見せて、ルールは書かない。二つ、アクトは動作を短いまとまりで一度に出す。モデルは小さく、学習も速い。三つ、実機のデータは実機で評価する。汎化はまだ難しい。ロボットはプログラムされるんじゃなくて、お手本から学ぶんだ!じゃあ、ひとこと聞いてから動けるようにするには、どう学習させるの?また次回!
根拠と出典
約8000万 · が ACT 方策のパラメータ数。軽量で扱いやすい(LeRobot 公式ドキュメント) [O] · Hugging Face · LeRobot ドキュメント:ACT
10万ステップ · の学習は、GPU一枚で数時間ほど(LeRobot 公式ドキュメント) [O] · Hugging Face · LeRobot ドキュメント:ACT
練習とセルフチェック
小テストは公開で、回答するとすぐ解説が出ます。読み物の練習問題の答えはログイン会員向けです。
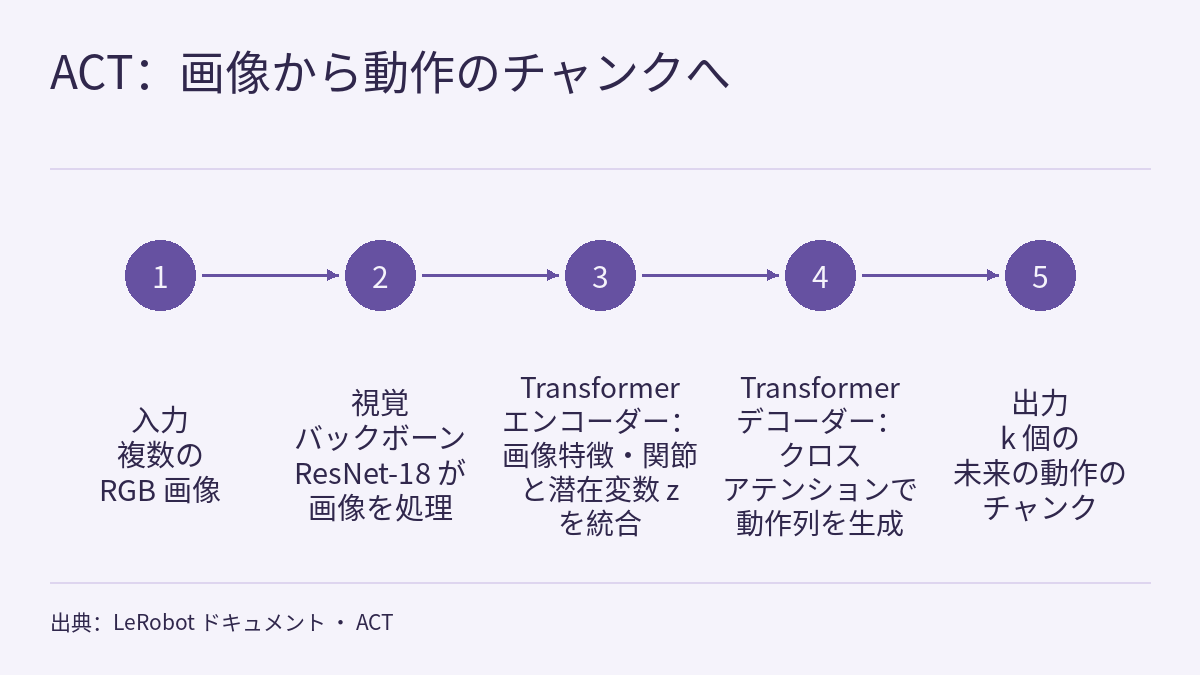
第 2.2 回の動画は、LeRobot を使って「お手本を方策に変える」流れを一度通します。入力は見えている画像といまの関節の角度、出力は次に到達すべき位置です。学習させるモデルは ACT(Action Chunking with Transformers、動作をチャンクに分けて扱うトランスフォーマー)で、未来の短いまとまりの動作を一度に予測します。データは LeRobot のコミュニティが公開しているデータセット svla_so101_pickplace で、SO シリーズのアームで録った 50 本の実機のピック&プレースのお手本が入っています。学習はコマンド一行、評価は実機に戻って行います。動画の数字カードは二つの公開資料から取っています。データセットの meta/info.json と、LeRobot ドキュメントの ACT のページ(パラメータ約 8000 万、50 本のお手本で高い成功率が出ることが多い、GPU 一枚で 10 万ステップに数時間ほど)です。このページはこの回の解説と練習です。文字起こしを繰り返すのではなく、二つの資料を並べて読みます。メタデータの各フィールドが ACT のどの入力・出力に当たるか、ドキュメントの学習コマンドの各引数が何を担い、何を書いていないか、評価の例と学習データがロボットの型とカメラのどこで食い違うか、です。全体を通じたルールは一つです。コマンドも数字も、それを書いたデータとそのバージョンのドキュメントについてだけ成り立つので、実行する前に一項目ずつそろえます。
この回の動画、文字起こし、出典はこのページの上部にあり、シーズン全体の構成は講座の概要にあります。前回のフィジカルAIラボ 2.1:MuJoCo でつかむ場面をつくる――XML に書かれていない質量・単位・ステップ幅・衝突ルールを計算で確かめるは、場面はできた、ではロボットはデータからどうやって自分で動けるようになるのか、という問いで終わりました。今回はその続きです。このデータセットのエピソード数、フレーム数、合計時間は、フィジカルAIラボ 1.5:データはどこから来る?――SO-101 のメタデータからお手本の長さを求め、三つの入手ルートの単位と動作空間を見分けるで同じメタデータから計算しました。ACT 論文の「約 10 分のお手本で成功率 80〜90%」の実験条件は、フィジカルAIラボ 1.6:模倣学習――誤差がお手本のカバー範囲からはみ出すまでを手で計算し、ACT・拡散方策・データのスケーリング則の数字をそれぞれの条件に照らして読むで扱いました。成功率には条件、ペア、試行回数を添えることは、フィジカルAIラボ 1.8:評価――「差し引き +2」を対応表に分解し、失敗ラベルと乱数シードを計算で確かめるで練習しました。この回ではそれらを繰り返さず、動画が新しく使った LeRobot ドキュメントのページと、それとメタデータのあいだで確かめるべき点だけを扱います。
公開小テストの 5 問には詳しい解説が付いています。ログインすると、三つの練習に取り組めます。メタデータのフィールドを ACT の入力と出力に対応づけ、いくつかのチャンク長が何秒に当たるかを計算し、架空のデータセットの学習コマンドを書く。架空の計時で学習の予算を記帳し、ステップ数、バッチサイズ、サンプル数を区別する。架空の実機評価の計画を実行前に審査し、その報告を書き直す。いずれも段階的な解答例、よくある誤り、20 点満点の採点基準付きです。
1. 二つの資料がそれぞれ述べていること
データセットのメタデータ。meta/info.json は JSON ファイルです。下の表は、そこに記録されたフィールドと値を整理したもので、メタデータの事実のまとめであり、原文の文ではありません。
| フィールド | 値 | 読み方 |
|---|---|---|
| robot_type | so100_follower | ロボットの型のフィールド。so101 はデータセット名にしか出てこないため、動画は「SO シリーズのアーム」とだけ言っています |
| total_episodes | 50 | お手本 50 本 |
| total_frames | 11939 | 全フレーム数 |
| total_tasks | 1 | タスクは 1 つだけ |
| fps | 30 | 毎秒 30 フレーム。動作と状態も 30 fps で記録 |
| splits | train: 0:50 | 50 本すべてが train に入っており、メタデータには取り分けたテスト用のエピソードがありません |
| observation.images.up、observation.images.side | video、形状 [480, 640, 3](高さ、幅、チャンネル)、av1 符号化 | カメラ 2 台 |
| observation.state | float32、6 次元 | shoulder_pan.pos、shoulder_lift.pos、elbow_flex.pos、wrist_flex.pos、wrist_roll.pos、gripper.pos |
| action | float32、6 次元 | 名前は observation.state と同じ |
| timestamp、frame_index、episode_index、index、task_index | 各 1 次元 | 時刻と番号 |
| chunks_size | 1000 | 第 2 節を参照 |
動画の二枚の数字カードは、メタデータの次の二か所に対応します。それぞれ独立に抜き出したものです。
"total_episodes": 50
"gripper.pos"
二つ目は、action と observation.state の名前の一覧の最後の項目です。前の五つが腕の関節、最後の一つがグリッパーで、合わせて動画の言う「位置の値が六個」になります。
LeRobot ドキュメントの ACT のページ。動画の三枚の数字カードに対応する三つの文を、それぞれ独立に抜き出します。
Lightweight : Only ~80M parameters, making it efficient and easy to work with
Data Efficient : Often achieves high success rates with just 50 demonstrations
Expect a few hours for 100k training steps on a single GPU
ページにはさらに、ACT は軽量で効率のよい模倣学習の方策で、細かい操作に特に向いていること、学習が速く、計算資源の要求が小さく、性能が高いため、LeRobot を始めるときに最初に推奨するモデルであること、Zhao らの論文 Learning Fine-Grained Bimanual Manipulation with Low-Cost Hardware で提案されたことが書かれています。学習のヒントには、ほかに二つの項目があります。ACT の標準のハイパーパラメータはたいていのタスクでうまく働くこと、バッチサイズは 8 から始めて GPU のメモリに合わせて調整すること、です。
これらの資料を読むときの注意点は三つです。
- どちらも O レベルですが、性質が違います。メタデータはデータセットのファイル自身の記録で、ドキュメントは LeRobot チームが自分たちのモデルを紹介したものです。本サイトでは学習も評価も実行しておらず、どの項目も確認していません。
- 二つの「50」は同じものではありません。データセットにはお手本が 50 本あり、ドキュメントは ACT が 50 本のお手本で高い成功率を出すことが多いと述べています。後者はドキュメントの概括的な記述で、タスク、ロボットの型、評価条件を示しておらず、このデータセットについての予測ではありません。動画の数字カードにも、動画での実測ではないと書かれています。ACT 論文には「10 分または 50 本のお手本」という別の実験条件があります。1.6 を参照してください。
- 「数時間」には GPU の型、バッチサイズ、タスクが書かれていません。これは 10 万ステップにかかる時間の目安で、学習で必ず到達すべきステップ数でも、評価が有効かどうかの条件でもありません。
ログインすると、このレッスンの続きと確認問題、解答を読めます。
制約と注意点
- meta/info.json は、データセットの main ブランチのものを 2026-10-14 に取得して読みました。main ブランチは更新されることがあります。1.5 の回では同じメタデータを固定コミットで読んでおり、そこで報告されたエピソード数、フレーム数、フレームレート、カメラの台数はこの回と一致しています。メタデータは O レベルです。この回ではデータファイルや動画をダウンロード・確認しておらず、メタデータは収録方法、お手本の質、robot_type フィールド以外のハードウェア情報を示していません。
- LeRobot ドキュメントの ACT のページは O レベルのベンダーのドキュメントで、バージョン番号のないアドレスのものを 2026-10-14 に取得して読みました。ページには main、v0.6.1、v0.5.1、v0.4.4 などのバージョン切り替えがあります。この回は LeRobot のバージョンを固定しておらず、コマンド名や引数はバージョンによって変わる可能性があります。パラメータ約 8000 万、50 本のお手本、10 万ステップに数時間ほど、はいずれもドキュメントの概括的な記述で、本サイトの測定でも、このデータセットでのベンチマークでもありません。「数時間」には GPU の型が示されていません。
- ページのテキストを取り出した際、${HF_USER} の両側と –wandb.enable= のあとに空白が入り、評価コマンドでは –task の行のコメントと –duration=60 が同じ行にありました。この回では学習コマンドのその空白を取り除き、それ以外はページの表示どおりに挙げています。ドキュメントの本文は lerobot-record、例は lerobot-rollout で、この回ではどちらが現行のバージョンに当たるかを判断していません。
- –output_dir、–job_name、–policy.repo_id の意味、chunks_size がデータファイルのまとまりを指すこと、action が学習の目標であること、そして「1 サンプルが 1 フレームに当たる」「動作をデータセットのフレームレートで実行する」は、いずれもこの回の推測または仮定で、ドキュメントにもメタデータにもそう書かれてはいません。
- k = 30 と練習の k、cup_pick_v1、すべての計時、チェックポイントの間隔、チーム W の計画と報告、試行回数と成功回数は練習用の架空の設定です。1.0 s、180、67.0 回、4.17 h、33.8 分、85%、45% などは、これらの仮定のもとでだけ成り立ち、どのシステムの性能でもありません。
- 本サイトでは、動画の Notebook、学習コマンド、評価コマンドのいずれも実行していません。評価コマンドは実際のロボットアームを動かします。ハードウェアの安全対策はこの回の範囲外で、紙の上の計算もシミュレーションの結果も、ハードウェアの安全性の検証ではありません。データセット名には so101 が含まれますが robot_type は so100_follower で、収録に使ったハードウェアを確かめる一次資料が本サイトにはないため、このページも動画も「SO シリーズのアーム」とだけ書いています。
リンク
- フィジカルAIラボ:すべての数字を確認できるフィジカルAI講座(講座の概要)
- フィジカルAIラボ 2.1:MuJoCo でつかむ場面をつくる――XML に書かれていない質量・単位・ステップ幅・衝突ルールを計算で確かめる
- フィジカルAIラボ 1.5:データはどこから来る?――SO-101 のメタデータからお手本の長さを求め、三つの入手ルートの単位と動作空間を見分ける
- フィジカルAIラボ 1.6:模倣学習――誤差がお手本のカバー範囲からはみ出すまでを手で計算し、ACT・拡散方策・データのスケーリング則の数字をそれぞれの条件に照らして読む
- フィジカルAIラボ 1.8:評価――「差し引き +2」を対応表に分解し、失敗ラベルと乱数シードを計算で確かめる
- Hugging Face:lerobot/svla_so101_pickplace の meta/info.json
- LeRobot ドキュメント:ACT (Action Chunking with Transformers)