この回の動画
ナレーションは AI 合成音声です。 動画の章・文字起こし・出典
文字起こし
文字起こし
知行の問い
ロボットに歩き方を教えるには、何度も何度も転ばないといけない。実機でそんなに転べる?今回は、シミュレーションの中で、たくさんの環境を同時に開きます。強化学習で、ヒューマノイドに歩き方を教えます。使うのはアイザック・ラボです。
なぜシミュレーションで練習するのか
実機で歩き方を教えるのは、とても大変です。一度転べば、壊れるかもしれません。人がそばで見張る必要もあり、ひどく時間がかかります。言いかえると、実機はたった一つの宝物です。壊したら終わり。思い切り試させる勇気も出ません。実機は遅くもあります。一つの動作を、本当に終わるまで待つしかありません。急げないのです。しかも、一度に教えられるのは一台だけ。速くしたくても、速くなりません。シミュレーションなら、そんな心配はいりません。転んだらやり直すだけ。お金もかからず、部品も一つも壊れません。シミュレーションは速くもできます。中の時間は、現実よりずっと速く進められます。もっと大事なのは並列です。実機は一台だけ。でもシミュレーションなら、同時にずらりと並べられます。シミュレーションの中なら、思い切りやらせられます。どんどん転ばせて、とことん試させるのです。もちろん、シミュレーションは現実ではありません。これは、最後にお話しします。
強化学習:報酬で学ぶ
前の二回は、お手本を見て学びました。今回はちがいます。今回は、お手本がありません。どうやって学ぶのか。試行錯誤です。うまく歩けたら報酬、転んだら減点。子犬のしつけに少し似ています。できたらおやつ、できなかったらなし。ロボットは、歩くとは何かを知りません。知っているのは、どうすれば点が高くなるかだけです。これはいいことでもあり、悪いことでもあります。いちばん楽に点を取る方法を、必死に探すのです。ポイントは一言。与えた報酬の通りに、学びます。安定して、しかも速く歩かせたい?それなら、その方向に点をあげます。利点ははっきりしています。人が一つ一つお手本を見せなくていい。目標と報酬を決めれば、あとは自分で試します。難しさもここにあります。報酬がずれていると、抜け穴をつかれます。たとえば前進だけに報酬を出すと、二、三歩突っ走って、見事にひっくり返るかもしれません。歩く場合なら、前進には報酬、転倒には重い罰。さらに、力を節約するよう促します。これらを一つの点数にまとめます。一歩ごとに、どうすれば点が増えるかを計算しているのです。学習アルゴリズムは既製品で、PPOといいます。試しながら、良かったものを残していきます。手取り足取り教える必要はありません。報酬とルールを決めるだけです。教えなくても、報酬さえ正しければ、自分で歩き方を見つけるんだ!
数千の環境でいっしょに練習
まず環境の話です。一つの環境は、ロボット一台と、小さな地面の一区画。その中で、くり返し練習します。この地面は、平坦なこともあれば、でこぼこのこともあります。本物の力を鍛えさせるのです。平地から坂道へ、階段から石ころの道へ。いろいろ見るほど、しっかり歩けます。この一つの環境を、たくさんたくさんコピーします。全部が同時に走り出します。ここがGPUのすごいところ。たくさんのコピーを同時に計算して、一画面にずらりと並べます。環境はそれぞれ、自分で歩き、自分で転びます。互いに影響せず、いっしょに経験を積みます。坂を登るもの、転ぶもの、もうかなり安定して歩けるもの。全部が同じ画面の中です。一回分走らせると、膨大な経験が、一気にロボットに流し込まれます。公式ドキュメントによると、アイザック・ラボはエンドツーエンドのGPU学習を使い、何千もの環境を同時に並列で動かせます。どのくらい多いのか。入門チュートリアルでは、棒を倒さずに立てる課題ひとつで、もう六十四個の環境を開きます。ヒューマノイドの歩行でも、たくさんのロボットで、いっしょに練習します。差はすぐに出ます。スーパーコンピューターがいると思わないでください。一般向けのグラフィックボード一枚で、大勢を並べられます。いっしょに練習すると、経験が早くたまります。数千回分の経験が同時に入ってきて、あっという間に学びます。同じ時間で見る転び方や歩き方は、実機よりはるかに多いのです。経験が増えると、わかってきます。足をどう置くか、体をどう安定させるか。グラフィックボード一枚の中に、歩く練習をするロボットが、大勢いっしょに立ってるんだ!
やってみる、そして限界
今回のノートブックを開きましょう。まず注意です。NVIDIAのGPUとUbuntuが必要で、インストールは軽くありません。アイザック・シムを入れてから、アイザック・ラボを入れます。コマンドはすべてノートブックに書いてあるので、そのまま写せば大丈夫。インストール中は、依存パッケージをたくさん取ってきます。初回は、しばらく待つかもしれません。入れ終わったら、まず付属の小さな例を動かしましょう。環境に問題がないと確かめてから、大きな課題へ。コマンド一つで学習開始。課題はヒューマノイドの歩行を選び、ヘッドレスモードをつけると、速く走ります。ヘッドレスモードとは、あのきれいなウィンドウを描かないこと。浮いた計算力は、全部練習に回します。まずは小さな設定で試運転。環境を少なめにして、何回か反復させ、動き出すかを見ます。学習中は、報酬の曲線を見張ります。どんどん上がっていけば、うまく歩けるようになっている証拠です。この曲線が、成長の成績表です。画面を見るより、こちらのほうが正確です。曲線がガタガタするのは普通です。大きな流れが上向きなら、見込みありです。報酬が上がらないなら、たいてい報酬の決め方がまちがっています。戻って直して、また練習です。学習が終わったら、再生してみましょう。地形の上で、一歩ずつしっかり歩いていくのが見えます。その瞬間は、ちょっと不思議です。誰も足の出し方を教えていないのに、自分で歩けるようになったのです。これがシミュレーションで学ぶ魅力です。時間もお金も節約できて、しかも安全。だから、インストールの手間をいやがらないで。一度動けば、あとはずっと使い回せます。将来実機に載せるために、学習中にわざと乱れを加えます。床を少しすべりやすくしたり、不意にぐいっと押したり。見てきた落とし穴が多いほど、実機で新しい状況に出会っても、あわてません。でも、シミュレーションはやはり現実ではありません。シミュレーションで安定して歩けても、実機でそうとは限りません。この壁をどう越えるか。ドメインランダム化と、システム同定です。次回、じっくりお話しします。ふりかえりです。ポイントは三つ。一つ、シミュレーションで歩く練習。転んでも痛くないし、大勢でいっしょに練習できる。二つ、強化学習は報酬で学び、お手本はいらない。三つ、GPUで数千の環境を同時に動かし、あっという間に学ぶ。だから何度転んでも大丈夫。全部シミュレーションの中で、グラボ一枚で足りるんだ!でも、シミュレーションで安定して歩けても、実機で転んだらどうするの?また次回!
根拠と出典
練習とセルフチェック
小テストは公開で、回答するとすぐ解説が出ます。読み物の練習問題の答えはログイン会員向けです。
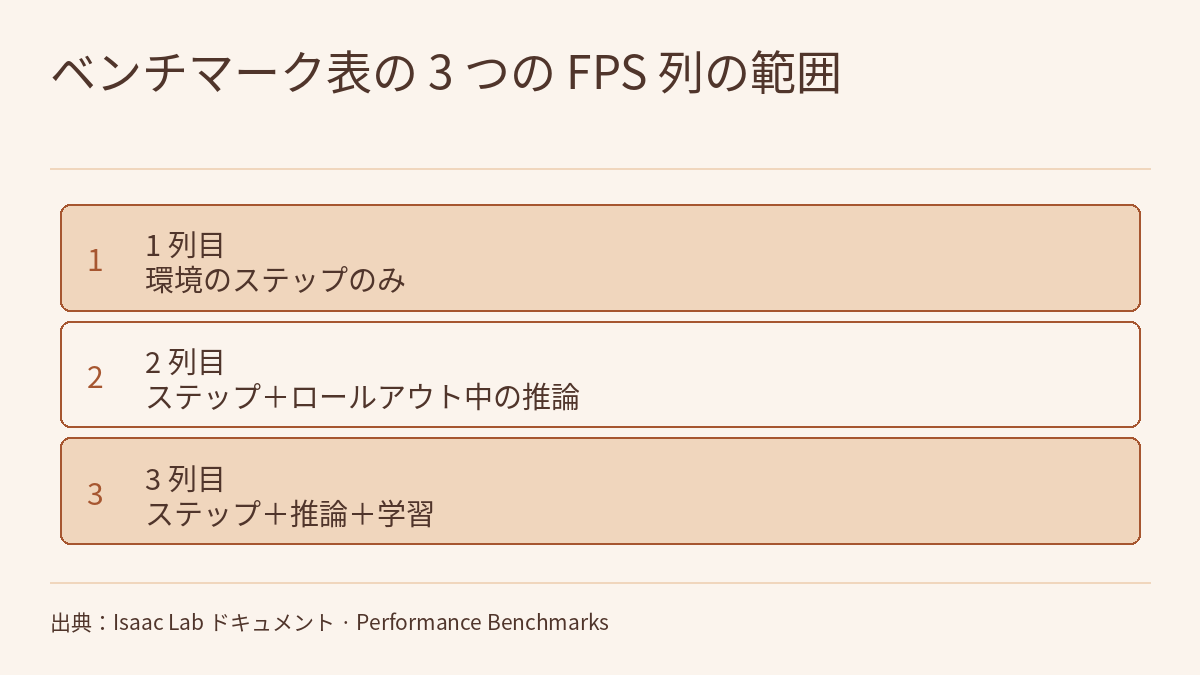
第 2.4 回の動画は、Isaac Lab で強化学習を使い、ヒューマノイドにいろいろな地形の上で歩き方を教えます。ポイントは三つです。シミュレーションなら転んでも痛くなく、大勢でいっしょに練習できること。強化学習は報酬を頼りに試行錯誤で学び、お手本はいらないこと。GPU は数千の環境を同時に並列で動かせますが、シミュレーションは現実ではなく、実機に載せるには sim2real を越える必要があることです。動画の二枚の数字カードは、Isaac Lab 公式ドキュメントの二つのページに基づいています。Performance Benchmarks のページは、Isaac Lab がエンドツーエンドの GPU 学習を使い、数千の環境で高速に並列学習できると述べています。入門チュートリアル Training with an RL Agent では、倒立振子(Cartpole)課題の学習コマンドが –num_envs 64 になっています。このページはこの回の解説と練習です。文字起こしを繰り返すのではなく、この二つのページそのものを丁寧に読みます。ベンチマーク表の 3 つの FPS 列がそれぞれどの処理を含むか、GPU やノードの違う数字をどう比べられ、どう比べられないか。チュートリアルのコマンドの各引数が何を決めるか、–num_envs と –max_iterations がどう組み合わさって一回の学習の総ステップ数を決めるか、ログ、動画、チェックポイントがどこに残るか、です。全体を通すルールは、スループットの数字はその行の課題、環境数、ハードウェア、RL ライブラリだけのものであり、一回の学習の総ステップ数はその学習自身の引数から計算しなければならず、よその表から持ってきてはいけない、ということです。
この回の動画、文字起こし、出典はこのページの上部にあります。シーズン全体の構成は講座の概要をご覧ください。前回のフィジカルAIラボ 2.3:SmolVLA をファインチューニングする――指示に合わせてお手本を計画し、各数字が何を測ったかを確かめ、非同期の動作キューの時間を計算するは、歩き方を教えるには仮想の世界で何度も練習しなければならないが、どう練習するのか、という問いで終わりました。この回はそこから始めます。報酬、収益、報酬の抜け穴、そして Learning to Walk in Minutes の地形カリキュラムとタイムアウト時のリセットはフィジカルAIラボ 1.7:強化学習――1 回分の収益を手で計算して報酬の抜け道を見つけ、論文の地形カリキュラムとタイムアウト時のリセットを読むで扱いました。同じ論文の「数千台のロボット、4 分未満」の実験条件はフィジカルAIラボ 0.4:仮想の世界で一万回練習――シミュレーションの 3 つの数字に実験条件を戻すで一つずつ確かめました。学習予算でステップ数、バッチサイズ、サンプル数を分けて数える練習はフィジカルAIラボ 2.2:LeRobot で ACT を学習させる――データセットのメタデータをモデルの入力に対応づけ、学習と評価のコマンドを一項目ずつ確かめるで行いました。この回ではそれらを繰り返さず、ドメインランダム化とシステム同定(次回の内容)にも触れず、動画で新たに使った Isaac Lab ドキュメントの二つのページだけを扱います。
公開小テストの 5 問には詳しい解説が付いています。ログインすると、三つの練習に取り組めます。チュートリアルの学習スクリプトで、架空の倒立振子の学習のスモークテストと本番のコマンドを書き、–num_envs と –max_iterations から総ステップ数と記録の区切りを計算する。ベンチマーク表の実際の数字で、3 つの FPS 列の差、複数 GPU でのスケーリング、二つの単一 GPU 構成の比を検算し、四つの主張を判定する。ベンチマーク表を使ってヒューマノイド歩行の学習時間と GPU メモリを見積もった架空の計画を審査し、まず測ってから規模を広げる計画に書き直す。いずれにも段階的な解答例、よくある誤り、20 点満点の採点基準が付いています。
1. 二つのページがそれぞれ述べていること
二つのページはどちらも Isaac Lab の公式ドキュメント(動画の数字カードでは NVIDIA 公式ドキュメントと表示)で、この講座の区分では O レベルです。この回が読んだのはバージョン番号のない main ブランチのページで、取得日は 2026-10-19 です。ページにはどの Isaac Lab や Isaac Sim のバージョンに対応するかが書かれておらず、この回もバージョンを固定していません。ドキュメントの数字はプロジェクト自身の報告で、本サイトは再現していません。
Performance Benchmarks のページの冒頭の一文が、動画の「数千」の数字カードです。
Isaac Lab leverages end-to-end GPU training for reinforcement learning workflows, allowing for fast parallel training across thousands of environments.
同じページはベンチマークの条件を明記しています。次の二文はそれぞれ独立に引用したものです。
All benchmarking results were performed with the RL Games library with –headless flag on Ubuntu 22.04.
Isaac-Velocity-Rough-G1-v0 environment benchmarks were performed with the RSL RL library.
Training with an RL Agent のチュートリアルでは、動画の「64個」の数字カードは、一つ目の学習方法(ヘッドレス実行)のコマンドに当たります。
./isaaclab.sh -p scripts/reinforcement_learning/sb3/train.py --task Isaac-Cartpole-v0 --num_envs 64 --headlessチュートリアルによるヘッドレス実行の説明です。
Typically, it speeds up the training process since only physics simulation step is performed.
次の表は、動画の説明と二つのページを対応させたもので、この回の整理であり、原文の文ではありません。
| 動画の説明 | 出典 | ドキュメントが明記する条件 | ドキュメントが述べていないこと |
|---|---|---|---|
| 数千の環境を同時に並列で動かせる | Performance Benchmarks | エンドツーエンドの GPU 学習。ベンチマーク表の環境数は 1024、4096、8192 | 「数千」は上限でも保証でもない。表にほかの環境数はない |
| ヘッドレスモードにすると速く走る | Training with an RL Agent | ヘッドレスでは学習中に描画せず、物理シミュレーションのステップだけを行うので、たいてい速くなる | どれだけ速くなるか |
| 入門の倒立振子で 64 個の環境を開く | Training with an RL Agent | Stable-Baselines3 の PPO で Isaac-Cartpole-v0 を学習し、例のコマンドは –num_envs 64 | 64 が推奨値であること |
| ヒューマノイドの歩行でも大勢でいっしょに練習する | Performance Benchmarks | 表のヒューマノイド課題 Isaac-Velocity-Rough-G1-v0 は 4096 個の環境で、RSL RL で測定。RAM 6.5 GB、VRAM 6.1 GB | この課題の報酬や地形、安定して歩けるまでの学習時間 |
| 一般向けのグラフィックボード一枚で大勢を並べられる | Performance Benchmarks | 単一 GPU の構成の一つは RTX 4090 で、CPU は AMD Ryzen 9 7950X | ページは GPU を分類しておらず、より小さな GPU で何個開けるかも書いていない |
この表を読むときの注意点は三つです。
- 二つのページの倒立振子は課題名が違います。ベンチマーク表は Isaac-Cartpole-Direct-v0(カメラ観測付きの Isaac-Cartpole-RGB-Camera-Direct-v0 もあります)で、チュートリアルとベンチマークスクリプトの例は Isaac-Cartpole-v0 です。表のメモリや FPS を、チュートリアルのコマンドにそのまま当てはめることはできません。
- RL ライブラリが違います。ベンチマーク表は G1 の行以外は RL Games、G1 は RSL RL、チュートリアルは Stable-Baselines3 です。同じ環境で RL ライブラリを替えた比較はページにないので、「学習込み」の列の数字は表のそのライブラリだけのものです。
- 「大勢」はコードの中では一つの次元です。チュートリアルにはこうあります。
The input and outputs of the environment are not numpy arrays, but rather based on torch tensors with the first dimension being the number of environment instances.
つまり –num_envs 64 なら、観測、行動、報酬は、最初の次元が 64 のテンソルです。RL ライブラリごとに期待するインターフェースが違うので(たとえば Stable-Baselines3 は VecEnv インターフェース、つまり numpy 配列のリストを期待します)、Isaac Lab は isaaclab_rl モジュールのラッパーで変換します。チュートリアルは、学習フレームワークのラッパーはほかのすべてのラッパーの後、最後にかけるよう注意しています。環境の API の解釈を変えるため、その後は gymnasium.Env と互換でなくなるかもしれないからです。
ログインすると、このレッスンの続きと確認問題、解答を読めます。
制約と注意点
- Performance Benchmarks と Training with an RL Agent はどちらも Isaac Lab の公式ドキュメントで、O レベルです。この回が読んだのはバージョン番号のない main ブランチのページで、取得日は 2026-10-19 であり、Isaac Lab や Isaac Sim のバージョンは固定していません。コマンド、引数、既定値はバージョンによって変わる可能性があります。ベンチマーク表の数字はプロジェクト自身の報告で、本サイトは再現していません。
- ページは、FPS がすべての環境のステップ数の合計で数えるのかを定義しておらず、複数 GPU のときの環境数が GPU ごとか合計かも、メモリの表をどの GPU で測ったかも書いていません。次のものはこの回の読み方または推論で、原文はそうは述べていません。三つの処理の時間が足し合わされること。FPS がすべての環境のステップ数の合計で数えること。env.step の呼び出し回数が総ステップ数を環境数で割ったものに等しいこと。–log_interval をヘルプの文から n timesteps ごとに 1 回記録すると読むこと。-1 を渡したときに実際に使われたシードが params/agent.yaml に書かれること。
- train.py は n_timesteps を読む前に agent_cfg = process_sb3_cfg(agent_cfg, env_cfg.scene.num_envs) を呼びますが、ページはこの関数が何を変えるかを示していません。総ステップ数の式の結果を実際に学習したステップ数とみなすこと、そして課題 1 の 20,480 と 4,915,200 は、この読み方に基づいています。
- ページのテキストを抽出したとき、ベンチマークスクリプトの例で –task の後の等号の前後に空白がありました。この回では取り除いています。写す前に元のページと照らし合わせてください。
- n_steps = 32、16、24、チーム P と R、そのマシン、8 GB の VRAM、5000 万ステップと 2000 万ステップの予算、計画の四つの文、実測の FPS 40,000 と 52,000、90 s の起動時間は、練習用の架空の設定です。10,240、20,480、4,915,200、609.8 s などはこれらの仮定のもとでだけ成り立ちます。課題 2 の倍率と割合は、表の実際の数字をこの回が割り算したもので、ページ自身は示していません。
- このページは、動画のノートブックも、学習、再生、ベンチマークのコマンドも実行していません。動画の報酬の設計、地形、外乱、「自分で歩けるようになった」画面に対応する数字は、この回が読んだ二つのページにはなく、この回では確かめていません。シミュレーションで安定して歩けても、実機で安定して歩けるとは限りません。紙の上の計算とシミュレーションの結果は、ハードウェアの安全性の検証ではありません。
リンク
- フィジカルAIラボ:すべての数字を確認できるフィジカルAI講座(講座の概要)
- フィジカルAIラボ 2.3:SmolVLA をファインチューニングする――指示に合わせてお手本を計画し、各数字が何を測ったかを確かめ、非同期の動作キューの時間を計算する
- フィジカルAIラボ 1.7:強化学習――1 回分の収益を手で計算して報酬の抜け道を見つけ、論文の地形カリキュラムとタイムアウト時のリセットを読む
- フィジカルAIラボ 0.4:仮想の世界で一万回練習――シミュレーションの 3 つの数字に実験条件を戻す
- Isaac Lab ドキュメント:Performance Benchmarks
- Isaac Lab ドキュメント:Training with an RL Agent