人型ロボットの移動マニピュレーション(loco-manipulation)では、歩行、バランス、物体とのやり取りを同時にこなす必要があります。デモデータは少なく、強化学習をゼロから行うのも困難です。ミュンヘン工科大学(TUM)、マギル大学、INRIA の著者らはプレプリント DiPLO(arXiv 2610.24847、2026-10-17)で、この 2 つの仕事を分けました。拡散モデルによる動作プランナーがロボットの全身と物体の動きを生成し、強化学習で訓練した別の全身追従方策がそれを実行します。論文で最も参考になるのは学習の順序です。事前学習ではプランナーを、人間の動作からリターゲティングした運動学的参照に依存させます。事後学習では、まず自己蒸留(SD:DPO)でこの参照を取り除き、次に拡散モデル向けの強化学習(DA:PPO)でプランナーを固定したトラッカーに合わせます。著者らは、シミュレーションの把持・運搬・配置タスクで成功率が 45.4% から 98.8% に上がり、実機の Unitree G1 では実機での微調整なしに 15 回の実行がすべて成功したと報告しています。以下の数値はすべて著者報告 [R] で、本サイトでは再現していません。
役割分担:プランナーが全身と物体の動きを生成し、トラッカーが実行する
プランナーは、Diffusion Transformer(DiT)をデノイザーとする条件付き拡散モデルです。入力はロボットと物体の状態履歴と、目標の物体姿勢(物体の現在の姿勢に対する相対値)で、任意の入力として IK リターゲティングで得た運動学的参照を受け取ります。出力は n フレーム分のロボット・物体の動作チャンクです。各フレームの状態は、平面上のルート変位、向きの変化、ルートの高さ、ルートの姿勢、29 個の関節位置、物体の位置と姿勢からなります。回転は連続的な 6D 表現で符号化し、1 フレームあたり 48 次元の特徴量になります。ユークリッド特徴量にはコサインノイズスケジュールの分散保存(VP)拡散と v 予測を使い、ルートと物体の姿勢は SO(3) 上で別に拡散します。
トラッカーは、動力学的に実行可能な参照動作を追従するよう mjlab で PPO により訓練した汎用の追従方策です。50 Hz で動作し、計画された動作の 1、2、4、8 フレーム先の参照を読み取り、参照関節位置に加える残差を出力して PD 制御器の関節目標とします。実行は閉ループです。トラッカーはチャンクの最初の m ≤ n フレームだけを実行し、プランナーは計測された状態から再計画します。論文は、これにより再計画が追従誤差を含め実際に実行された動きを考慮すると強調しています。
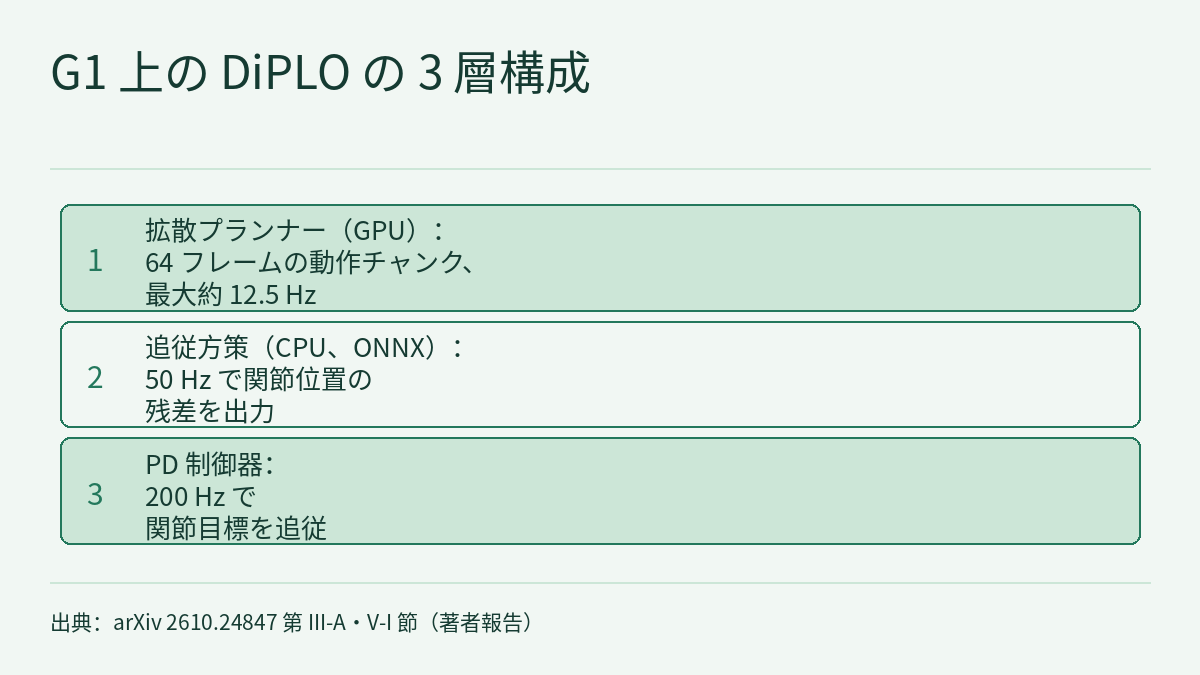
実機への展開では、3 つの周波数が同じ 1 つのシステムのものとして明記されています。プランナーは GPU 上の別プロセスとして動き、10 回のデノイズで 64 フレームのチャンク(1.28 s 分)を生成します。通信遅延と拡散サンプリングを含めた最大周波数は約 12.5 Hz です。トラッカーは CPU 上で ONNX Runtime により 50 Hz で動き、新しいチャンクが届くまで現在のチャンクの実行を続けます。PD 制御器は 200 Hz で関節目標を追従します。12.5 Hz であれば新しいチャンクは最短で約 80 ms ごと、つまりトラッカーの制御 4 ステップごとに届きます(本サイトによる換算)。読んだ本文には実機での m は書かれていません。フィジカルAIラボ 0.3:見る・考える・動くでは、異なるデータセット・モデル・インターフェースの周波数を 1 台のロボットの仕様として組み合わせてはいけないと説明しました。DiPLO の 3 つの周波数は 1 つの展開の記述から来ているので、層として並べて読むことができます。
事前学習:29 本のデモ、動力学的に実行可能なデータ拡張、参照条件が重要な理由
出発点は、既存のデータセット(OmniRetarget)にある 29 本のリターゲティング済みロボット・物体動作で、合計 2.7 分です。運動学的リターゲティングでは、ロボットの動力学や接触の制約が満たされる保証はありません。そこで著者らは、DynaRetarget のサンプリングベースの軌道最適化(SBTO)で各参照を動力学的に実行可能な動作に精緻化します。初期条件に摂動を加え、最適化のシードを変えることで、1 本のデモから実行可能な変種を複数作ります。さらに矢状面での鏡映と、箱の 4 分の 1 回転の回転対称性を使ってデータを増やします。各学習サンプルは、運動学的参照と実行可能な目標動作の組です。事前学習では 50% のサンプルで参照を空トークンに置き換え、同じネットワークが両方の条件でデノイズできるようにします。
データ拡張の効果は論文の表 I(事前学習モデルの閉ループ生存率)に示されています。元の動作のみで 90.0%、対称性を加えて 90.7%、SBTO の変種を加えて 92.3%、両方で 96.5% です。両方の拡張を使った場合、DA:PPO による事後学習で生存率は 100.0%、タスク成功率は 96.4% になります。拡張なしのモデルは事後学習後も 93.3% と 72.3% にとどまります。同じ表では、トラッカーに参照そのものを実行させた結果もあります。IK リターゲティング動作の追従で生存率 93.5%、成功率 53.0%、SBTO 解の追従で 100.0% と 61.6% です。どちらのタスク成功率(53.0% と 61.6%)も、事後学習したプランナーの 96.4% を下回ります。
参照条件の役割は論文の第 V-B 節で調べられています。著者らは 7 種類のタスク事前情報それぞれで 1 つずつモデルを事前学習しました。IK リターゲティングしたロボットと物体の動作全体を条件とした場合が最も良く、OMOMO データセットの人体と物体の姿勢をリターゲティングせずにそのまま使うと生存率は約 9% 下がります。エンドエフェクタと物体の参照を 5 フレームに 1 つだけ残しても、密な参照と比べて目立った低下は見られません。物体の動作だけにすると生存率は約 70%、事前情報をまったく与えないと約 45% まで下がります。著者らは、このような少量データの条件では事前学習に強いタスク事前情報が必要だと結論づけています。これはフィジカルAIラボ 1.5:データはどこから来る?で扱った「人の手はロボットの手ではない」という問題にあたります。DiPLO は人の動作をロボットのデータに変換する作業を、運動学的リターゲティングと動力学的な実行可能性の最適化の 2 段階で行っています。
2 段階の事後学習:SD:DPO で参照を外し、DA:PPO で固定したトラッカーに合わせる
参照をそのまま外すと、事前学習モデルの性能ははっきり落ちます。著者らの説明では、計画と追従の誤差によって学習データでよくカバーされていない状態に入り、そこでは動きをどう続けるかについてデータが手がかりを与えられないためです。SD:DPO(Self-Distillation Diffusion Policy Optimization)の手順は次のとおりです。
- 生徒は状態履歴、目標、空トークンだけを受け取り、教師はそれに加えて運動学的参照を受け取ります。どちらも事前学習したプランナーから初期化します。
- 各計画ステップで生徒と教師がそれぞれチャンクを生成し、確率 1/2 でどちらかを選んで、固定したトラッカーがシミュレーション内で最初の m フレームを実行します。どちらが実行されたかにかかわらず、生徒の提案、開始時のコンテキスト、対応する参照をバッファに保存します。失敗したロールアウトは終了してリセットされますが、それまでに集めた提案は失敗に関わるものも含めて残ります。
- 学習時には保存した提案を 1 つ取り出し、一様にサンプリングした拡散レベルまでノイズを加えます。教師と生徒には同じノイズ付き動作、拡散レベル、コンテキストを与え、教師だけが参照も見ます。損失はユークリッド部分と回転部分のデノイズ予測の平均二乗誤差で、勾配は生徒だけを通り、教師の予測は固定の目標として扱います。
- この損失は、元のデータに基づく事前学習の損失、およびアンカー損失と一緒に学習します。アンカー損失は、参照ありのときの生徒の予測が固定した事前学習モデルのコピーから離れないよう抑えます。教師は生徒の重みの指数移動平均で更新します。
この段階に報酬は必要ありません。著者らは、追加情報を条件とした同じモデルを「自己教師」とする言語モデルの SDPO に着想を得たとしています。
2 段階目の DA:PPO は、各デノイズステップを 1 つの意思決定として扱います(Diffusion-Augmented MDP)。最初の m フレームの実行で得た環境報酬は最後のデノイズステップにだけ割り当てられ、ベルマン再帰によってそのチャンクを生成した各デノイズの決定に伝わります。最大エントロピー正則化項は逆方向と順方向の遷移密度の比から計算し、温度で強さを調整して、生成される計画の多様性を保ちます。微調整中トラッカーは固定され、プランナーは状態履歴と目標だけを受け取ります。論文は、DPPO がデノイズ過程を打ち切って探索するため動きががたつくことがあり、これは人型ロボットの制御で避けたい挙動だと指摘しています。
論文の表 V は、2 つの段階の効果を分けて示しています(把持・配置タスク)。
| プランナー | 生存率(%) | タスク成功率(%) |
|---|---|---|
| 事前情報なしで事前学習 | 46.9 | 32.2 |
| 事前情報なしで事前学習 + DA:PPO | 74.1 | 67.0 |
| 自己教師(事前学習、参照あり) | 96.5 | 51.9 |
| 生徒(事前学習、参照を空に) | 57.7 | 45.4 |
| 生徒 + DA:PPO | 92.1 | 92.1 |
| 生徒 + SD:DPO | 100.0 | 55.1 |
| 生徒 + SD:DPO + DA:PPO | 99.5 | 98.8 |
アブストラクトの「約 99% 対 45%」は、最後の行と参照を空にした生徒を比べたものです。参照ありの自己教師の成功率は 51.9% です。表から読み取れるのは次の点です(本サイトの解釈)。SD:DPO 単独では主に生存率が上がり(57.7% → 100.0%)、成功率は 45.4% から 55.1% への上昇にとどまります。DA:PPO だけでもすでに 92.1% に達し、両方を行うと成功率はさらに約 6.7 ポイント高くなり、生存率も上がります。参照なしで事前学習したモデルは DA:PPO を行っても 67.0% にとどまり、著者らはこれを事前学習段階での参照条件の重要性の根拠としています。キックと押す・引くの 2 つのタスクでは、それぞれ別にプランナーを事前学習しています。キックでは生徒の成功率が 1.2% から SD:DPO で 31.9%、DA:PPO で 68.1% になります(自己教師は 34.4%)。押す・引くでは 12.8% から 21.7%、さらに 52.7% です(自己教師は 23.3%)。この 2 つには「生徒 + DA:PPO」の行がないため、SD:DPO の寄与だけを切り分けることはできません。
指標の定義:生存率は、ロボットが転倒せず物体も落とさなかったロールアウトの割合です。タスク成功率は、生存したロールアウトのうち、最終的な物体の姿勢が目標から 15 cm かつ 30° 以内に収まった割合です。シミュレーションの結果は異なる参照動作にわたる平均 ± 標準誤差で、各動作を 100 回ずつ実行しています。
その他のアブレーション:SO(3) 拡散、動作レベルと行動レベル、報酬、プランナーとトラッカーのどちらを調整するか
- SO(3) 拡散:回転特徴量の拡散方法だけを変えると、SO(3) 上で拡散した場合は生存率 96.5%、成功率 51.9%、物体姿勢の誤差 14.0° です。6D 座標をユークリッド量として拡散すると 85.9%、46.4%、19.6° になります。
- 動作レベルと行動レベルの拡散:3 つの手法には同じタスク情報(状態、目標の物体姿勢、IK リターゲティング動作)を与えています。DiPLO の状態拡散とトラッカーの組み合わせは 96.5% / 51.9%、PDP の方式で構築した行動拡散は 87.5% / 45.3%、BeyondMimic の方式で構築し推論時に誘導する状態・行動拡散は 58.2% / 8.2% です。2 つのベースラインは、事前学習したトラッカーが拡張データを追従したロールアウトから行動クローニングで学習し、50 Hz の各ステップで再計画して最初の行動だけを実行します。著者らの論拠は次のとおりです。生成的な学習は順方向 KL のフィッティングにあたり、近似が不完全だと行動のモード同士の間の領域に確率を置くことがあります。行動レベルでは、そうしたサンプルがそのまま関節指令になり、バランスや接触を崩すおそれがあります。フィジカルAIラボ 1.6:模倣学習では、左回りと右回りが平均されて衝突になる例で同じ種類の問題を扱いました。DiPLO は、拡散モデルには動作を生成させ、シミュレーションで RL により誤差の修正を学んだトラッカーにそれを実行させます。
- 報酬:密な IK リターゲティング動作に沿うことに報酬を与える
r_kinでは、DA:PPO の成功率は 96.4%、MPKPE は 4.3 cm です。目標への接近と生存ボーナスに報酬を与えるr_goalでは 92.9%、8.0 cm です。r_kinはリターゲティング済みのデモがある場合にしか計算できませんが、r_goalは不要です。フィジカルAIラボ 1.7:強化学習では、報酬の書き方が方策の学ぶ内容を決めることを扱いました。ここではどちらの報酬でも生存率と成功率が上がり、r_goalはデモを必要としない代わりに、成功率がやや低く追従誤差が大きくなります。 - 最大エントロピー:温度なしの DPPO 方式の更新は 99.1% / 94.0%、DA:PPO は 100.0% / 96.4% で、追従誤差も小さくなります。著者らは、元の DPPO が探索のために追加の拡散ノイズを注入する手法を、不安定で追従できない挙動につながったため取り除きました。著者らは DA:PPO の優位を最大エントロピーの目的関数によるものとし、DPPO 方式の目的関数は深刻なモード崩壊を起こすとする先行研究を引用しています。
- プランナーとトラッカーのどちらを調整するか:プランナーを事前学習のままにしてトラッカーだけを PPO で 1000 イテレーション微調整すると、成功率は 87.9%(目標項を加えると 89.3%)です。トラッカーを事前学習のままにしてプランナーを DA:PPO で微調整すると 96.5% です。表 I にはプランナーの微調整が 500 イテレーション、並列環境 2048 と書かれていますが、読んだ本文には 2 種類の微調整の計算量の比較はありません。
汎化と実機:成功率 88% の目標グリッドと 15 回の実行
参照を外したことで、プランナーはデータセットにない目標姿勢を受け付けられます。著者らはロボットの出発点の周りの極座標グリッドに、距離 0.5〜5 m で目標を置き、各位置で 0°、90°、180°、270° の 4 つの向きを取りました。デモにある最も遠い目標は 1.9 m です。各目標姿勢を 100 回ずつ実行し、物体の初期姿勢は最大 5 cm、12° の範囲でランダムにずらしています。SD:DPO と DA:PPO を経た生徒は、このグリッドで生存率約 100%、タスク成功率 88% でした。これはシミュレーションの結果です。
実機実験では、29 自由度の Unitree G1 で把持・運搬・配置を行いました。関節エンコーダと搭載 IMU が自己受容的な状態を与え、外部のモーションキャプチャシステムがロボットのベースと物体を追跡します。論文の表 VII の結果は次のとおりです。
| 実験 | 成功 | MPKPE(cm) | 最終的な物体位置の誤差(cm) | 最終的な物体姿勢の誤差(°) |
|---|---|---|---|---|
| 同じ目標で 10 回繰り返し | 10/10 | 6.5 ± 0.7 | 1.8 ± 0.8 | 3.4 ± 1.1 |
| 異なる 5 つの目標で各 1 回 | 5/5 | 6.8 ± 1.1 | 5.7 ± 5.0 | 12.8 ± 12.5 |
誤差は実行間の平均 ± 標本標準偏差です。この数字を読むときは 3 つの点に注意が必要です。実行は合計 15 回です。読んだ本文には、実機の成功判定がシミュレーションと同じ 15 cm・30° に従うかどうか書かれていません。アブストラクトは実機で DA:PPO のプランナー・トラッカーを使ったとしていますが、第 V-I 節にはこのプランナーが SD:DPO を経たものか、運動学的参照をまだ受け取っているかは書かれておらず、異なる 5 つの目標がデモの範囲の外にあるかどうかも説明がありません。フィジカルAIラボ 1.8:評価で扱った回数・条件・失敗の種類についての問いは、この 10/10 と 5/5 にもそのまま当てはまります。
本サイトが以前取り上げたフロンティア・レーダー|HWAMは、近い問題を扱っています。人型ロボットの参照動作は実際に実行される動きと一致しないため、HWAM は方策に参照動作と実行後の身体状態を同時に生成させます。DiPLO のやり方は異なり、トラッカーを固定し、計測した状態から再計画し、実行時の報酬でプランナーを微調整します。2 つの論文はタスクも評価も異なるため、数値を直接比べることはできません。
制約と注意点
- arXiv のプレプリントで、すべての数値は著者報告 [R] です。本サイトでは再現していません。読んだ本文にはコードやモデルの重みの公開についての記述はありません。
- 定量的なアブレーションはすべてシミュレーションで行われています。実機で試したのは把持・運搬・配置の 1 タスク、合計 15 回の実行だけで、外部のモーションキャプチャに依存しています。著者らは搭載センサーによる知覚を今後の課題に挙げています。シミュレーションの結果も、この実機での実行も、ハードウェアの安全性検証ではありません。
- 把持・運搬・配置のデータはデモ 29 本だけで、対称性による拡張には箱の回転対称性を使っています。キックと押す・引くのタスクは、それぞれ別にプランナーを事前学習しています。著者らは、1 つのモデルで複数のスキルを扱うことや、より多様な物体と環境を今後の課題に挙げています。
- 「45% → 99%」は、参照を空にした事前学習の生徒と、事後学習をすべて終えた生徒の比較で、タスク成功率は生存したロールアウトだけで数えています。引用するときはこの 2 つの前提を添える必要があります。
- 行動レベルのベースラインは、著者らが PDP と BeyondMimic の方式に従って構築したもので、それらの研究が公開した結果ではありません。表 VI ではトラッカーの微調整が PPO 1000 イテレーションと示されていますが、読んだ本文には表 VI のプランナー微調整のイテレーション数や計算量が書かれていないため、両者を学習予算で比較することはできません。
- 本記事は論文の HTML 本文の参考文献の冒頭までに基づいており、付録にある報酬、ハイパーパラメータ、ネットワーク構造の詳細は読んでいません。
リンク
- DiPLO: Self-distilled Diffusion Planning for Loco-manipulation(arXiv 2610.24847)
- 論文 HTML 全文
- フィジカルAIラボ 0.3:見る・考える・動く――3 つの周波数をそれぞれのシステムに戻す
- フィジカルAIラボ 1.5:データはどこから来る?――SO-101 のメタデータからお手本の長さを求め、三つの入手ルートの単位と動作空間を見分ける
- フィジカルAIラボ 1.6:模倣学習――誤差がお手本のカバー範囲からはみ出すまでを手で計算し、ACT・拡散方策・データのスケーリング則の数字をそれぞれの条件に照らして読む
- フィジカルAIラボ 1.7:強化学習――1 回分の収益を手で計算して報酬の抜け道を見つけ、論文の地形カリキュラムとタイムアウト時のリセットを読む
- フィジカルAIラボ 1.8:評価――「差し引き +2」を対応表に分解し、失敗ラベルと乱数シードを計算で確かめる
- フロンティア・レーダー|HWAM:人型ロボットの参照動作は実際の動きと一致しない――実行後の身体状態を動作と同時に生成する
- フィジカルAIラボ:すべての数字を確認できるフィジカルAI講座(講座の概要)