ロボットのタスク計画では、最終的に目標に到達するだけでは足りず、途中の各ステップでも順序・相互排他・リソースといった制約を満たす必要があります。物体を最後に正しい場所へ置けたとしても、途中で立入禁止の領域に入ったり、壊れやすい物体を誤った順序で扱ったり、必須の点検ステップを飛ばしたりした計画は受け入れられません。ノートルダム大学(University of Notre Dame)とノースウェスタン大学(Northwestern University)の著者らはプレプリント SLoSa(arXiv 2610.28955、2026-10-20)で、古典的プランナーと形式検証器を推論の段階から学習の段階へ移しました。まずそれらを使って「制約を加えると元の計画が成り立たなくなる」学習問題を作り、次に検証器の段階的な判定結果を GRPO の報酬として、4B–14B の 4 bit 量子化モデルをファインチューニングします。著者報告によると、これらの小型プランナーは 200 問の PDDL テストセットで成功率 70.5–76.0% に達し、Jetson AGX Orin 上で INT4 によりローカル実行したときの平均電力は 17.85–26.41 W です。本記事では見落としやすい点に注目します。検証器は決まった順序で判定するため、計画が実行可能になって初めて安全制約違反かどうかが判断されます。以下の数値はすべて著者報告 [R] で、本サイトでは再現していません。
ここでの「安全」とは何か:形式的な制約と固定された判定順序
論文はタスクを P = (S, A, s0, G, C) と表します。記号的な状態空間、行動集合、初期状態、目標、安全制約の集合です。各行動は高レベルのスキル(pick、move、place など)に対応し、前提条件と効果を持ちます。計画は行動の列です。安全制約は PDDL3 の軌道制約で表され、終点だけでなく状態の軌道全体を検査します。論文は、SLoSa の名前にある「安全への配慮」はこの形式的なタスク仕様への準拠を指し、「低電力」は前提とした性質ではなく経験的なデプロイ目標だと明記しています。
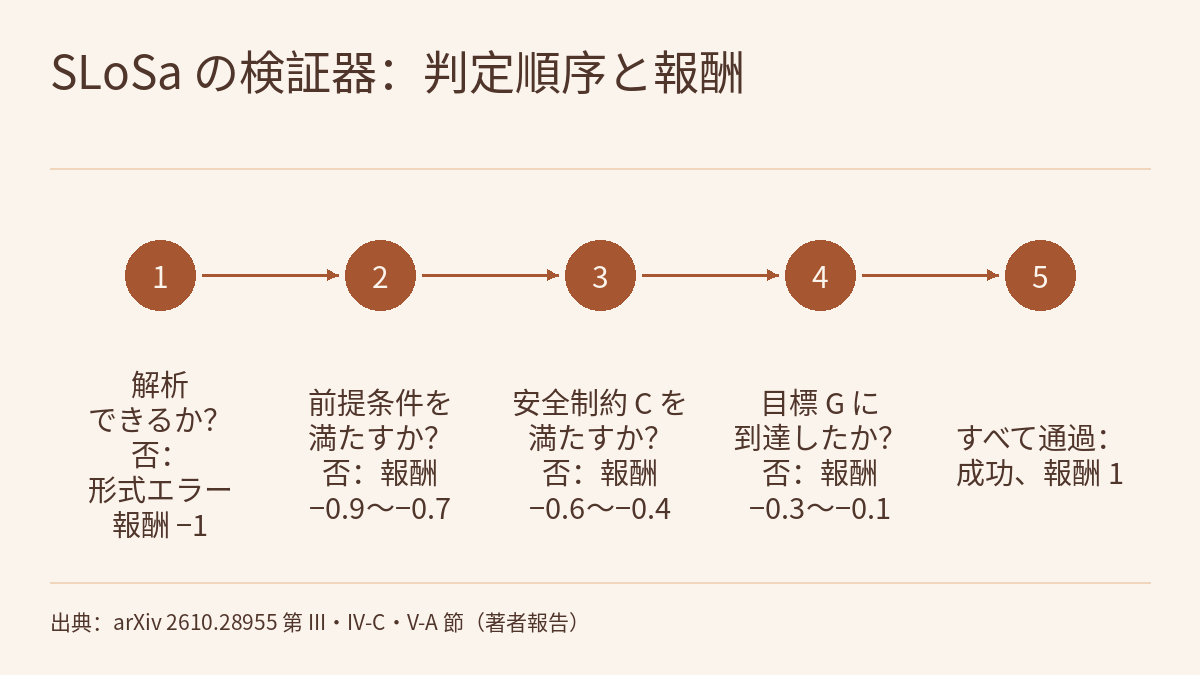
検証器は各出力を決まった順序で判定し、最初に通らなかった検査が結果を決めます。そのため、どの出力もちょうど 1 つの分類に入ります。
- 解析できない、または未定義の行動・オブジェクトを含む:形式エラー。
- 解析できるが、ある行動の前提条件が満たされない:前提条件違反。
- 完全で実行可能な軌道が得られてから初めて制約 C を検査し、C に違反すれば安全違反。
- 安全で実行可能だが目標 G に到達しない:目標未達。
- 上記をすべて通過:成功。
この順序は学習データの選別、報酬設計、評価のすべてに使われ、結果の表の読み方も決めます。下の表の「安全違反」列はいずれも低い値(0–1.0%)ですが、失敗した計画の多くが安全だったことを意味するわけではありません。3 ステップ目で前提条件に違反した計画は、安全の検査まで進まないからです。たとえば直接プロンプトで使った GPT-5.6 Sol は出力の 73.0% が前提条件違反で、安全違反は 0.5% だけです。その 73.0% が制約を満たしているかどうかは、この表からはわかりません(これは論文の定義に基づく本サイトの読み方です)。「制約が行動を変えたか」をより直接に測るのは、次節のデータのアブレーションです。
学習データ:制約によって計画が変わる問題だけを残す
データはロボットの場面を参考にした 4 つの PDDL ドメイン、Blocksworld、Ferry、Grippers、Spanner から作られ、それぞれ操作、運搬、物体の移送、工具の使用に対応します。各基本問題 P0 について、まず古典的プランナーが、実行可能で目標に到達することを検証済みのベースライン計画 τ0 を出します。次にドメインの意味に基づく PDDL3 制約を 1 つ加えて、制約付き問題 Pc を作ります。制約は次の 4 パターンのいずれかに従います。
| パターン | PDDL3 の構文 | ロボットの場面での意味 |
|---|---|---|
| 順序の安全 | sometime-before | ある事象が別の事象より先に起きなければならない |
| 中継の安全 | sometime、sometime-before | ロボットは安全な中間状態を経由しなければならない |
| リソースの制限 | always、not | 安全でない、予約済み、故障したリソースは使えない |
| 点検の義務 | sometime | ロボットはチェックポイントを訪れるか、点検を終えなければならない |
論文の例は、Spanner で「nut1 を nut2 より先に締める」という順序制約です:(sometime-before (tightened nut2) (tightened nut1))。2 つのナットを逆の順序で締める計画も目標には到達しますが、この軌道制約に違反します。
続いてプランナーが Pc を解き、代替計画 τc を得ます。問題を残すのは 3 つの条件がすべて成り立つときだけです。τ0 が元の問題で成功し、τc が制約付き問題で成功し、τ0 が制約付き問題で安全違反と判定されること。つまり、加えた制約が元のやり方を無効にし、なおかつ検証済みの代替案が残っていなければなりません。著者らはこうした問題を behavior-changing(行動を変える)インスタンスと呼びます。論文は、この定義は選んだベースライン計画を基準にしたもので、形式的な仕様が現実のあらゆる危険を捉えていることを意味しないと注意しています。難易度は検証済み計画の長さだけで Easy、Medium、Hard に分けます。各問題から PDDL のプロンプト 1 つと、構造化または叙述形式の自然言語のプロンプト 1 つを作ります。問題の 20% では教師モデル GPT-5.4-mini が追加の候補計画を生成し、同じ検証器を通ったものだけを残します。
データ構成の効果は 1 つの対照実験で確かめられています。著者らは Qwen3-4B で SFT のみを行い、同じ大きさで正例だけを含む 3 種類のデータを比べました。U-SFT は制約なしの計画、OC-SFT は半分の問題では制約が元の解を変えず残り半分では行動を変える混合データ、BC-SFT は行動を変えるインスタンスだけを使います。「条件付き安全違反」は、目標に到達した出力のうち少なくとも 1 つの制約に違反するものの割合です。
| データ | 成功率(95% 信頼区間) | 目標到達 | 条件付き安全違反 |
|---|---|---|---|
| U-SFT | 3.5% [1.7, 7.0] | 17.5% | 80.0% |
| OC-SFT | 53.0% [46.1, 59.8] | 56.0% | 5.4% |
| BC-SFT | 59.0% [52.1, 65.6] | 59.5% | 0.8% |
3 つの列の数字は互いに整合しています(本サイトによる確認):17.5% × (1 − 0.800) = 3.5%、56.0% × (1 − 0.054) ≈ 53.0%、59.5% × (1 − 0.008) ≈ 59.0%。違いが大きいのは条件付き安全違反です。制約なしで学習したモデルでは、目標に到達した計画の 8 割が制約に違反します。行動を変えるインスタンスだけで学習すると 0.8% まで下がります。OC-SFT と BC-SFT の成功率の信頼区間は重なっているので、このデータでは両者の成功率の差ははっきりしません。このアブレーションは 1 つのモデルで、SFT のみの条件で行われています。
報酬:検証器が区間を決め、プランナーの距離は区間内の順位づけだけに使う
GRPO の段階では、プロンプトごとに K = 4 個の候補計画をサンプリングし、別途報酬モデルや critic を学習せず、検証器が直接採点します。形式エラーは −1、成功は 1 に固定されます。中間の 3 種類の失敗にはそれぞれ重ならない負の区間が割り当てられ、論文で使われた値は前提条件違反 [−0.9, −0.7]、安全違反 [−0.6, −0.4]、目標未達 [−0.3, −0.1] です。著者らはこの順序を次のように説明しています。前提条件違反は完全な軌道すら生み出せず、実行可能な計画の中では、安全違反は「安全だが目標に届かない」計画より重大とみなします。
同じ分類の失敗どうしは、古典的プランナーで計算した進捗で区別します。評価状態を 1 つ選び(前提条件違反なら失敗した行動の直前の状態、安全違反なら違反を最初に検出した状態、軌道全体で判定する制約なら終端状態、目標未達なら終端状態)、そこから目標までの最短計画長 d_res を求め、元の初期状態からの最短計画長 d_init と比べます。
ϕ_dist = (d_init − d_res) / (d_init + d_res + ε)
r = ℓ_c + (h_c − ℓ_c) · (ϕ_dist + 1) / 2
プランナーが制限時間内に残りの問題を解けない場合は、最も低い進捗値を与えます。仮の数字で一度計算してみます(本サイトによる例で、論文のデータではありません)。安全違反の計画で d_init = 10、違反した時点の状態から目標までまだ d_res = 4 ステップあるとします。ε を無視すると ϕ_dist = 6/14 ≈ 0.43、報酬は ≈ −0.6 + 0.2 × 0.71 ≈ −0.46 です。前提条件違反の計画が進捗満点(ϕ_dist = 1)でも −0.7 にしかならず、どの安全違反よりも低いままです。つまり進捗の項は検証器が決めた区間の中で順位をつけるだけで、ある失敗の分類をより上の分類へ押し上げることはできません。成功した計画に計画長の項は加えません。目的は計画のコストを最適化することではなく、検証器の受理率を上げることだからです。
フィジカルAIラボ 1.7:強化学習では、1 回分の収益を手で計算して、書き方を誤ったシェーピング報酬が抜け道に使われる様子を示しました。SLoSa の区間による設計はこの問題への構造的な対処の 1 つですが、読んだ本文の範囲では、それで抜け道を防げるかは個別に検証されていません。学習の詳細をもう 2 点。4 つの候補の報酬がすべて同じグループは相対的な選好の信号を持たないため非アクティブとされ、方策の項と KL の項の両方から除かれます。GRPO は Easy/Medium/Hard のサンプリング比 6/3/1、1/6/3、1/3/6 の 3 段階カリキュラムで、それぞれ 125、250、125 ステップ学習します。
結果:成功率の向上は主に前提条件違反の減少から
3 つのバックボーンは、いずれも 4 bit 量子化で読み込み、LoRA(ランク 32)で適応させたオープンなモデルです:Qwen3-4B、Llama-8B(Llama 3.1 8B Instruct)、Qwen3-14B。評価は貪欲デコーディングで、途中の chain-of-thought は出力せず、Qwen3 の思考モードは学習と評価の両方で無効にしています。PT は SLoSa のポストトレーニング前の元のモデルを指します。下の表は 200 問の PDDL テストセットでの結果で、5 列は互いに排他的で合計 100% です。
| モデル | 段階 | 成功 | 目標未達 | 安全違反 | 前提条件違反 | 形式エラー |
|---|---|---|---|---|---|---|
| GPT-5.6 Sol | 直接プロンプト | 26.5 | 0.0 | 0.5 | 73.0 | 0.0 |
| Claude Sonnet 5 | 直接プロンプト | 31.0 | 3.5 | 0.0 | 55.5 | 10.0 |
| Qwen3-4B | PT / SFT / GRPO | 0.0 / 59.0 / 70.5 | 1.5 / 1.5 / 1.5 | 0.0 / 0.5 / 0.5 | 0.0 / 36.5 / 25.0 | 98.5 / 2.5 / 2.5 |
| Llama-8B | PT / SFT / GRPO | 0.0 / 62.0 / 74.0 | 5.0 / 5.5 / 7.5 | 0.0 / 1.0 / 0.0 | 70.0 / 30.5 / 18.0 | 25.0 / 1.0 / 0.5 |
| Qwen3-14B | PT / SFT / GRPO | 0.0 / 67.0 / 76.0 | 0.5 / 2.5 / 1.5 | 0.0 / 0.0 / 0.0 | 0.0 / 30.5 / 22.0 | 99.5 / 0.0 / 0.5 |
PT から SFT への大きな変化は、主にモデルがタスク固有の行動の語彙と厳密な出力形式を身につけたことによります。PT 段階では 2 つの Qwen3 モデルの出力の 98.5%、99.5% が形式エラーです。SFT から GRPO では、3 モデルの成功率が 9.0–12.0 ポイント上がり、同時に前提条件違反が 8.5–12.5 ポイント減っています(表から本サイトが計算)。つまり GRPO の改善の大部分は、計画を実行可能にしたことによるものです。著者らは直接プロンプトの 2 つの大規模モデル(26.5%、31.0%)を挙げ、モデルの規模だけでは安全を意識したポストトレーニングの代わりにならないと述べています。ただし、この 2 モデルはタスク固有の学習を受けておらず、読んだ本文にはプロンプトも示されていません。その失敗も主に前提条件違反です。
著者らは 3 つの Llama-8B チェックポイントを SafePilot にも組み込みました。検証器が棄却した計画はフィードバックとともにモデルへ戻されて最大 3 ラウンド修正され、すべての検査を通った計画だけが受理されます。200 問で、PT、SFT、GRPO の最終成功率は 0.5%、68.0%、77.5% で、初回の成功率よりそれぞれ 0.5、6.0、3.5 ポイント高くなりました。平均反復回数(初回の生成を含む)は 2.995、1.735、1.500、平均トークン数は 5,185.81、2,179.52、1,782.87 です。上昇幅を差し引くと SFT と GRPO の初回成功率は 62.0% と 74.0% になり、上の表の Llama-8B の数字と一致します(本サイトによる確認)。この結果が示すのは、初回の質が高いほど修正ループのラウンド数とトークンが少なくて済むということです。
同じ流れを 2 つの家庭向けベンチマークの改変版でも、Qwen3-4B に別々に適用しています。VirtualHome-Safe の成功率は PT 0.0%、SFT 74.5%、GRPO 80.5%、ALFWorld-FO-Safe は 0.0%、76.0%、85.0% です。どちらも完全観測・非対話の改変版で、モデルは途中の環境フィードバックや再計画なしに完全な計画を一度に出力します。ALFWorld-FO-Safe は記号的な状態をすべて公開しており、標準の部分観測・対話型の ALFWorld プロトコルではありません。論文は、これらの例が評価するのは高レベルの記号的な安全準拠であり、物理的な衝突安全ではないと明記しています。
デプロイ:Jetson Orin では低電力だが、1 つの計画に中央値で約 16〜22 秒
エッジでのテストは NVIDIA RTX 4080(16GB)と Jetson AGX Orin 開発者キット(64GB)で行われ、INT4 推論、バッチサイズ 1、同時リクエスト 1 件の条件です。各モデルは 20 回のウォームアップの後、同じ 100 個の PDDL プロンプトを 3 回実行しました。レイテンシは生成と解析を含み、スループットは生成だけを数えます。計画あたりのエネルギーは、測定した推論エネルギー(リクエスト間のオーバーヘッドを含む)を計画数で割ったもので、モデルの読み込み、ウォームアップ、検証のエネルギーは含みません。
| ハードウェア | モデル | P50(s) | P90(s) | トークン/s | ピークメモリ(GB) | 平均電力(W) | 計画あたりエネルギー(J) |
|---|---|---|---|---|---|---|---|
| RTX 4080 | Qwen3-4B | 6.65 | 8.66 | 11.73 | 3.80 | 71.16 | 464.75 |
| RTX 4080 | Llama-8B | 6.01 | 7.77 | 13.19 | 5.91 | 88.14 | 516.70 |
| RTX 4080 | Qwen3-14B | 8.03 | 11.11 | 9.77 | 11.22 | 122.90 | 983.78 |
| Jetson Orin | Qwen3-4B | 18.28 | 23.53 | 4.30 | 3.89 | 17.85 | 316.33 |
| Jetson Orin | Llama-8B | 15.88 | 20.01 | 5.01 | 6.06 | 23.14 | 355.18 |
| Jetson Orin | Qwen3-14B | 22.00 | 30.04 | 3.55 | 11.50 | 26.41 | 581.14 |
アブストラクトの「17.85–26.41 W」は、この表の Jetson Orin 3 行の平均電力です。同じ表は別の面も示しています。Orin での P50 レイテンシは 15.88–22.00 s で、同じモデルの RTX 4080 での値の約 2.6–2.7 倍です。一方で電力がずっと低いため、計画あたりのエネルギーは RTX 4080 より小さくなります(Qwen3-4B で 316.33 J 対 464.75 J)。これはタスクレベルの高レベルプランナーで、1 つの計画を出すのに中央値で約 16〜22 秒かかるものであり、ミリ秒単位の低レベル制御ループとは別の層です。フィジカルAIラボ 0.3:見る・考える・動くでは、層ごとにそれぞれの周波数があることを説明しました。読んだ本文には、電力をボード全体で測ったのか GPU だけなのかの説明も、測定値のばらつきもありません。もう 1 点区別が必要です。図 4 は 10–50 ブロックの Blocksworld 41 インスタンスで Fast Downward、OPTIC(大きなインスタンスの多くが 300 秒のタイムアウトに到達)と GPT-5.6 Sol の生成時間を比べたもので、SLoSa の小型モデルではありません。本文は GPT-5.6 Sol の生成時間が「比較的安定」と述べるだけで、これらのインスタンスでの有効な計画の割合は示していません。本サイトでは以前、フロンティア・レーダー|EdgeVLNとフロンティア・レーダー特集|エッジとリアルタイム性で 4 bit 推論のエネルギーとレイテンシを取り上げました。それらは別のモデルとハードウェアでの結果で、ここでの数字と直接比べることはできません。
実機デモは、デスクトップ型の 6 自由度アームと第三者視点のカメラで Blocksworld を行うものです。各タスクは、ブロックの初期配置の画像、目標配置の画像、安全制約を説明する自然言語で与えられます。視覚言語モデルがこれを PDDL3 の問題に変換し(読んだ本文ではモデル名は示されていません)、Qwen3-4B の SFT または GRPO チェックポイントが計画を生成し、実行前に SafePilot 方式の検証・修正ループを通します。検証器が受理した計画だけがコントローラに渡され、記号的な行動があらかじめ用意した操作スキルに対応づけられます。各プランナーで 30 回試行しています。
| 指標(/30) | SFT | GRPO |
|---|---|---|
| 検証器が受理した計画 | 17 | 19 |
| 検証器が棄却した計画(実行しない) | 13 | 11 |
| 実行成功 | 13 | 14 |
| 低レベルの失敗 | 4 | 5 |
低レベルの失敗とは、受理された計画が実行精度の不足で積み上げに失敗したか、積み上げたブロックがアームの到達可能な作業空間を超えたために完了できなかった場合を指します。論文はこれらの失敗が操作精度によるもので、符号化された記号的制約への違反ではないと説明しています。2 つのチェックポイントの実行成功の差は 1 回(13 対 14)だけで、30 回の試行では両者を区別するには足りません。フィジカルAIラボ 1.8:評価では、こうした小さな標本での差の読み方を練習しました。この実験が示すのは、検証器が不適格な高レベル計画 11–13 個を止め、ロボットへそのまま送らせなかったことです。ハードウェアの安全性検証ではありません。
制約と注意点
- これは arXiv のプレプリントで、数値はすべて著者報告 [R] です。本サイトでは再現していません。読んだ本文には、コード、データ、モデルの重みの公開先は示されていません。
- 著者ら自身が挙げる制約:SLoSa が扱うのは高レベルのタスク計画だけで、安全の教師信号は記号的な行動モデルと形式検証の結果から得ており、報告された安全性能は対応する高レベル制約への準拠だけを測っています。評価は知覚の誤り、動作レベルの失敗、モデル化されていない物理的リスクを扱っていません。Blocksworld のような長いホライズンのドメインは依然として難しく、デスクトップアームの評価は 1 つの作業セルと固定の低レベルスキルだけで行われています。
- 「行動を変える」インスタンスの定義は選んだベースライン計画を基準にしたもので、形式的な仕様が現実のすべての危険を含むという意味ではありません。実機の流れでは、視覚言語モデルが作った PDDL3 の問題が誤っていても、検証器はその仕様に照らしてしか検査できません。読んだ本文はこの段階の精度を個別に報告していません。
- 結果の表で安全違反の割合が低いことは、判定順序と合わせて読む必要があります。前提条件に違反した計画は安全の検査に進みません。制約が行動に与える影響のより直接的な証拠はデータのアブレーションの条件付き安全違反ですが、それは Qwen3-4B で SFT のみの条件で行われ、OC-SFT と BC-SFT の成功率の信頼区間は重なっています。
- 直接プロンプトの 2 つの大規模モデルはタスク固有の学習を受けておらず、読んだ本文にはプロンプトの設定も示されていません。小型モデルとの比較は同じ条件での比較ではありません。
- エッジでのテストはバッチサイズ 1、単一リクエスト、100 プロンプトの条件です。読んだ本文には電力測定の範囲やばらつきの説明がありません。表の注には “energy per accepted plan” とありますが、定義は計画数で割るもので、受理された計画だけを数えるのかは説明されていません。約 2.6–2.7 倍、9.0–12.0 ポイントと 8.5–12.5 ポイント、初回の 62.0% と 74.0% は、論文の表から本サイトが計算したものです。報酬の節の d_init = 10、d_res = 4 は仮の数字です。
リンク
- SLoSa: Small, Low-Power, and Safe Foundation Models for Robotic Task Planning(arXiv 2610.28955)
- 論文の HTML 全文
- フィジカルAIラボ 0.3:見る・考える・動く――3 つの周波数をそれぞれのシステムに戻す
- フィジカルAIラボ 1.7:強化学習――1 回分の収益を手で計算して報酬の抜け道を見つけ、論文の地形カリキュラムとタイムアウト時のリセットを読む
- フィジカルAIラボ 1.8:評価――「差し引き +2」を対応表に分解し、失敗ラベルと乱数シードを計算で確かめる
- フロンティア・レーダー|EdgeVLN:同じ 4 bit でも、1 ステップのエネルギーは実行経路によって 36.8 倍の差
- フロンティア・レーダー特集|エッジとリアルタイム性:VLA と世界行動モデルのレイテンシ予算はどこに使われているか
- フィジカルAIラボ:すべての数字を確認できるフィジカルAI講座(講座の概要)