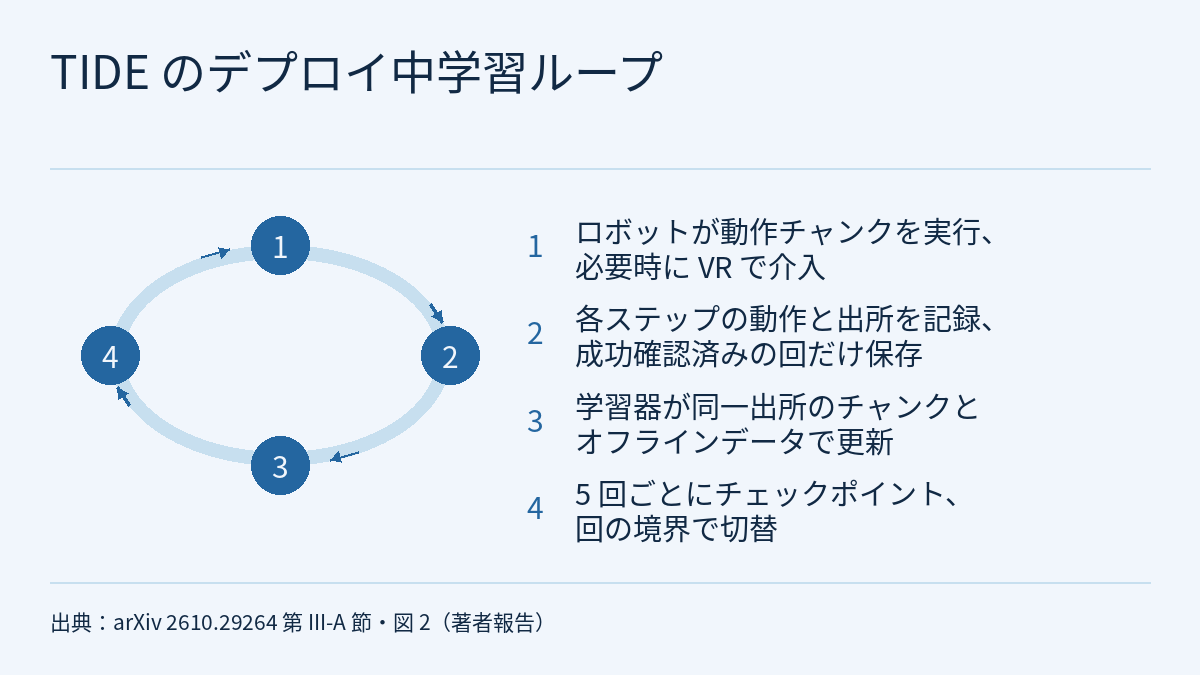
事前学習済みのロボット基盤モデルをオフラインの遠隔操作デモで目的のタスクに適応させても、デプロイ中にはデモがカバーしていない状態に入り込みます。接触の多いインタラクション、回復が必要な場面、高い精度が求められる姿勢などです。復旦大学、Shanghai Innovation Institute、Logos Robotics Group、サリー大学(University of Surrey)の著者によるプレプリント TIDE(Training In DEployment、arXiv 2610.29264、2026-10-21)は、デプロイそのものを学習の過程に変えます。ロボットは現在の方策を実行し、オペレーターは必要なときだけ介入します。システムは 50 ステップの動作チャンクの動作がすべて人、またはすべて方策によるときだけ「人が実行」か「方策が実行」かという出所(provenance)のラベルを付け、人と方策が混在するチャンクは除外します。学習器が同じセッションの中でオンラインに更新して、エピソードの境界で新しいチェックポイントに切り替えます。学習した critic、報酬モデル、動作のスコアラーは使いません。著者報告では、双腕の実機 4 タスクで、TIDE のタスク進捗と完全達成の回数はウォームスタート方策や同量の追加オフラインデモを上回りましたが、「方策を固定して収集し、収集後に学習する」ベースラインとは最終性能が同程度でした。違いは、新しいチェックポイントをデプロイ中に使えることにあります。以下の数値はすべて著者報告 [R] で、本サイトでは再現していません。
課題:オフラインの事後学習は次の周回を待ち、オンライン RL は価値を推定しなければならない
論文は既存の手法を 2 種類に分け、それぞれのコストを指摘しています。1 つ目はオフラインの事後学習です。「収集・学習・デプロイ」のサイクルで進むため、デプロイ中の経験は次のオフライン学習の周回まで使えず、分布シフトへの適応が遅くなります。既存の human-in-the-loop 手法も、デプロイを主に専門家の動作ラベルの供給源として扱いがちです。人が介入した区間はデモとして使われ、方策が生成した区間は捨てられるかラベルなしデータとして扱われます。しかしデプロイ中の経験の大部分は、方策自身が生成したものです。2 つ目はオンライン強化学習です。介入と方策の実行の両方を利用できますが、通常はエピソード単位のまばらな成否のフィードバックで学習した価値関数や critic に依存します。著者は、このような弱い教師信号では高次元の動作チャンクを安定して評価しにくく、学習が複雑で不安定になると述べています。
関連研究の節で著者は、いくつかのシステムがそれぞれループの一部しか閉じていないことを順に説明しています(以下は著者による説明です)。RoboCopilot のワークフローは周回ベースのままで、デプロイされる方策はバッチ再学習から得られます。RECAP はアドバンテージ条件付けでモデル全体の human-in-the-loop 改善を拡張しますが、段階的なオフライン更新で進み、完全に並行するオンラインの枠組みは今後の課題としています。RL Token は凍結した事前学習方策の上で軽量な actor-critic を学習し、バックボーン全体は更新しません。Hi-ORS は結果に基づく棄却サンプリングで critic を避けますが、軌道単位の結果の教師信号に依存します。ConRFT は Q 関数を保持し、オンラインのファインチューニングを人の介入でゲートします。TIDE が狙うのは、実機のデプロイをデータのループに残し、動画バックボーン、クロスモーダルアダプター、動作エキスパートを同時に更新し、教師信号を学習した価値や軌道単位の報酬ラベルではなく動作の出所で整理する、という位置です。
論文は human-in-the-loop 学習を、共変量シフトと誤差の蓄積への対処として位置づけています。現在の方策自身がたどり着いた状態で、人が介入できるからです。フィジカルAIラボ 1.6:模倣学習では、誤差がデモのカバー範囲からはみ出していく様子を扱いました。フィジカルAIラボ 1.7:強化学習では、報酬の書き方と critic の学習目標を扱いました。TIDE が避けているのは後者です。エピソードが成功したかどうかは、そのエピソードをオンラインデータセットに入れるかどうかを決めるだけで、報酬、モデルの条件、学習目標としては使われません。本サイトのフロンティア・レーダー特集|学習と自己改善は VLA の事後学習を 3 つの段階に分け、最後の段階をデプロイ経験からの学習としました。TIDE はこの段階の中で、価値の推定を使わない手法の 1 つです。
1 つのセッションの 3 つの構成要素:ロボット側、推論・記録サーバー、オンライン学習器
TIDE が対象とするのは、事前学習済みの世界・動作方策(world-action policy)です。動画生成バックボーンが観測と言語指示からコンパクトな「世界の事前情報」をつくり、フローマッチングの動作エキスパートがこの事前情報とロボットの状態にクロスアテンションして 50 ステップの動作チャンクを生成します。バックボーンは同じ時間幅の将来の動画フレームも予測します。デプロイ前に、学習可能なモジュールはすべて目的タスクのオフライン遠隔操作データでウォームスタートされます。論文で報告されている方策のパラメーター数は 3B で、8 基の H100 で学習しています。
- ロボット側は低レイテンシの制御を担当します。各制御ステップで観測を取得し、サーバーに動作チャンクを要求し、オペレーターが介入しない限り方策の動作を実行します。RTC を参考に非同期のリアルタイム・チャンキングを採用しており、確定した動作を実行し続けながら、その先の動作をバックグラウンドで更新します。これにより推論による停止を減らし、連続するチャンクのつなぎ目を滑らかにします。介入時、オペレーターは VR の差分制御で現在の状態を基準に小さな動きを指令し、エピソードをリセットせずに制御を方策へ戻せます。引き継ぎのたびに待機中の方策チャンクを消去し、古い動作が実行されないようにします。実行記録と介入フラグは非同期で送信され、制御のクリティカルパスには入りません。別のシステムの非同期推論について動作キューの時間を計算したフィジカルAIラボ 2.3:SmolVLA をファインチューニングすると比べて読むと参考になります。
- 推論・記録サーバーは GPU での推論を一手に引き受け、オンラインのエピソードを共有データセットに書き込みます。エピソードの終わりに、オペレーターがタスクの完了を手動で確認します。保存されるのは成功が確認されたエピソードだけで、失敗、タイムアウト、中断・停止、完了前のリセット、再録画、古くなったもの、回復しなかったエピソードは破棄されます。サーバーは学習器が出力したチェックポイントをエピソードの境界でだけ採用するため、各エピソードは 1 つの世代の方策だけで生成されます。
- オンライン学習器は新しく保存された記録を読み込み、オフラインのタスクデータと合わせて、動画拡散バックボーン、クロスモーダルアダプター/Q-former、動作エキスパート、出所の埋め込みを同時に更新します。事前学習済みのテキストエンコーダーと動画 VAE は凍結したままです。新しく保存された制御フレーム 1 つにつき 0.2 回の最適化ステップを割り当て、保存されたエピソード 5 つごとにチェックポイントを公開します。サーバーは新しい重みを先読みし、次のエピソード境界で切り替えます。
論文が示す時間の測り方は次のとおりです。各タスクについて、オンラインの human-in-the-loop 実行の開始から最後のチェックポイントがデプロイ可能になるまでの連続した実時間は 1 時間未満でした。この区間には非同期のデータ処理、学習、チェックポイントの処理、ロボットの実行、人の介入、エピソードのリセットが含まれ、初期準備と最終的な自律評価は含まれません。この構成では、オンラインの最適化 1 ステップに約 0.4 s かかります。Bit Insertion については具体的なデータがあります。保存されたエピソードは 41 回、制御フレームは 38,839(30 Hz で 21.6 分)で、そのうち人の制御が 1,432 フレーム(3.69%)、方策の制御が 37,407 フレームでした。
論文が示す比率から概算すると(本サイトによる計算で、論文は実際の最適化ステップ数やチェックポイント数を報告していません)、0.2 × 38,839 ≈ 7,768 回の最適化ステップで、1 ステップ約 0.4 s とすると約 3,107 s、つまり約 52 分です。41 エピソードで 5 回ごとに公開すると、チェックポイントは約 8 個になります。動作 1 ステップが 30 Hz の制御フレーム 1 つに対応するなら、50 ステップのチャンクは約 1.67 s に相当します(これも本サイトによる換算です)。
出所ラベル:50 ステップの動作チャンクは、すべて人かすべて方策か
オンラインのエピソードでは、人の介入と方策の実行が交互に現れます。TIDE はエピソード全体を 1 本のデモとして扱わず、動作チャンク単位でラベルを付けます。各制御ステップで、ロボットに送った動作と、それがオペレーターと方策のどちらから来たかを記録します。すべて人が実行したチャンクのラベルは 0、すべて方策が実行したチャンクは 1、人と方策のステップが混在するチャンクは ∅ です。50 ステップの目標動作区間が人または方策のラベルを得るのは、50 個の動作すべての出所が同じ場合だけです。∅ の区間は出所条件付き学習から除外され、引き継ぎ点の前後に追加の除外区間は設けません。
論文は 2 つの境界を繰り返し強調しています。第 1 に、出所ラベルは実行の出所だけを表し、報酬でも正しさのラベルでも品質のスコアでもありません。第 2 に、エピソードの成功はそのエピソードをオンライン学習データセットに入れるかどうかの判断にだけ使われ、モデルの条件、報酬、出所ラベル、学習目標ではありません。学習では、各出所ラベルを学習可能な埋め込みに対応させ、動画バックボーンと動作エキスパートの両方でフロー時間の埋め込みに加えます。目的関数は、将来の動画と動作それぞれのフローマッチング損失の和です。論文で報告されているオンラインの自律実行と最終的な介入なしの評価はすべて、出所の条件を人のモード(ℓ = 0)に固定しています。
データの配分も明記されています。オフラインの遠隔操作データはすべて人の出所(ℓ = 0)のチャンクとして扱います。学習器はオフラインとオンラインのバッファーを別々に持ち、オンラインのサンプルにはオフラインに対して 5:1 の重みを与えます。これは 2 つのバッファーから選ぶ確率が 5/6 と 1/6 であることに相当します。α = 5 は予備的な調整で選んだ値で、報告されたすべてのタスクとバリエーションで固定です。オンラインバッファーの中では、人が実行したチャンクと方策が実行したチャンクのバランスをとり、少ない介入データが大量の自律実行データに埋もれないようにしています。さらに、タスクの成立を保つデータ拡張が 2 つあります。鏡映してもタスクが成り立つ場合に、作業空間の対称面で観測・状態・動作を鏡映する方法と、動作チャンクと対応する将来の観測を異なる実行速度で再サンプリングする方法です。拡張したサンプルは、元のチャンクの出所ラベルを引き継ぎます。
ラベルの定義から次のことが導けます(本サイトの推論で、論文では議論されていません)。50 個の連続した動作の出所が同じでなければ「人が実行」の区間にならないので、50 制御ステップより短い介入からは人のラベルを持つ区間が 1 つも生まれず、その介入を含む区間はすべて ∅ として除外されます。Bit Insertion では人の制御フレームは 3.69% しかありませんが、そのうちどれだけが人だけの区間に入ったか、どれだけの区間が ∅ になったかは論文に報告されていません。
評価:各組み合わせ 20 回の介入なし実行、2 つの指標、3 つの比較対象
実機実験はすべて双腕の UR5e プラットフォームで行われ、グリッパーは Robotiq 2F85、カメラは第三者視点の RealSense D455 が 1 台と手首の RealSense D405 が 2 台です。4 つのタスクとそのマイルストーンは次のとおりです。Bit Insertion(ドライバーのビットをビットホルダーに差し込む。つかむ、差し込む)、Towel Folding(広げたタオルを平らにして正方形に折る。平らにする、1 回目の折り、2 回目の折り)、Towel Hanging(タオルをハンガーに掛ける。ハンガーを取る、タオルを載せる、ハンガーを掛ける)、Chain Packing(金属のチェーンを箱に収める。チェーンを入れる、ふたを閉める、フラップを差し込む)。方策は 50 ステップ、14 次元、関節相対の双腕動作チャンクを出力します。予測した各オフセットを現在の関節状態に加え、その結果を絶対的な関節目標として制御器に渡します。この動作表現を選ぶ前に、著者は同じデータ、初期化、学習予算でオフライン学習のみの 8 種類の動作空間を比較し、この対照研究では関節相対の動作が最も良い結果でした。
各「手法・タスク」の組み合わせは、あらかじめ決めた同じ初期状態の集合から 20 回の自律実行で評価され、人の介入は一切ありません。タスク進捗はマイルストーンで正規化します。1 回の実行で達成したマイルストーン数をそのタスクのマイルストーン総数で割り、20 回で平均します。タイムアウト、安全停止、タスク失敗で終わった実行では、すでに安定して達成したマイルストーンだけを数えます。完全達成は別に k/20 で報告し、すべてのマイルストーンを達成した実行だけを数えます。タスク性能を介入なしの評価だけで測るのは、収集中は人の介入によって、本来なら失敗したエピソードが成功に変わりうるからです。
3 つの比較対象はすべて、タスクごとの同じウォームスタートのチェックポイントから始めます。Warm はウォームスタート方策そのものです。Offline はオンラインデータと同量の遠隔操作デモを新たに収集し、TIDE と同じ回数の最適化ステップで学習します。Fixed Policy は、TIDE と同じ時間の human-in-the-loop 収集の間ウォームスタート方策を固定し、収集後に同じ目的関数、バッファー設定、フィルタリング規則、総最適化予算で学習します。論文は結果を文章で次のように説明しています。
- マイルストーンで正規化した進捗では、Fixed Policy と TIDE はどちらも 4 つのタスクすべてで数値上 Warm と Offline を上回りました。
- TIDE の進捗は Bit Insertion と Towel Hanging で Fixed Policy と同じで、Towel Folding と Chain Packing では上回りました。
- 完全達成の回数は Bit Insertion で同数、2 つのタオルのタスクで TIDE が 1 回多く、Chain Packing で 2 回多い結果でした(いずれも 20 回中)。
- 著者はこれをもとに、この評価のもとでは両者の最終性能は同程度だとしています。TIDE の違いは、収集・学習・再デプロイの別サイクルを待たず、更新したチェックポイントをデプロイのセッション中に使える点です。
読んだ本文には、図 6 に示された各手法の具体的なパーセンテージは記載されていません。各組み合わせ 20 回なので、完全達成が 1 回多いことは 5 ポイントに相当します(本サイトによる換算)。フィジカルAIラボ 1.8:評価では、こうした小さな差を対応のある結果に分解する練習をしました。また本サイトのフロンティア・レーダー|Beyond Binary Successでは、実機での試行回数が限られるときに逐次検定で方策を比較する統計的手法を紹介しました。TIDE と Fixed Policy の 1〜2 回の差にも、同じ問いが当てはまります。
ほかに 2 つの診断が、Bit Insertion だけで行われています。アブレーションでは、すべてのバリエーションが同じウォームスタートのチェックポイントから始め、同じオンラインのインタラクション予算を使い、同じ初期状態から 20 回の介入なし実行で評価されました。TIDE の正規化進捗は 80.0% で、出所条件付けを外すと 65.0%、オンラインで人が実行したチャンクだけを使うと 67.5% でした。著者は、この単一タスクのアブレーションが明示的な出所条件付けと方策が実行したチャンクの利用の両方を支持するとしています。介入比率は、各学習エピソードで人の介入下にあった制御ステップの割合です。論文の図 8(a) では、直近 5 つの保存エピソードについてフレームで重み付けした比率が、デプロイ初期を過ぎると下がっています。著者は、この推移は監督の負担を表すだけで自律性能の指標ではなく、それだけでは学習の効果と時間的な要因を切り分けられないと明記しています。
制約と注意点
- これは arXiv のプレプリントで、数値はすべて著者報告 [R] です。本サイトでは再現していません。読んだテキストにはプロジェクトページのアドレスが載っていますが、コードやモデルの重みを公開しているかどうかは書かれていません。本サイトはプロジェクトページを開いていません。
- 著者自身が挙げる制約:TIDE には人の監督者が必要です。手動で成功が確認されたエピソードだけを残すため、選択バイアスが入る可能性があります。評価は双腕プラットフォーム 1 つ、タスク 4 つ、世界・動作バックボーン 1 つに限られ、長期的な保持やオンライン学習のスケジュールへの感度は検証しておらず、オンライン事後学習のセッションを繰り返したときのばらつきも測定していません。そのため、プラットフォームやアーキテクチャをまたいだ汎化はまだ確認されていません。
- Fixed Policy との比較について、著者自身の結論は「上回る」ではなく「同程度」です。完全達成の差は 0〜2 回(各組み合わせ 20 回中)にとどまります。読んだ本文には図 6 の具体的な数値がなく、本記事は論文の文章による比較を紹介しているだけです。
- 出所条件付けのアブレーション(80.0%、65.0%、67.5%)は Bit Insertion の 1 タスクだけで行われています。介入比率の低下は自律性能の指標ではありません。
- 「1 時間未満」は、オンライン実行の開始から最後のチェックポイントがデプロイ可能になるまでの実時間で、初期準備、オフラインのウォームスタート、最終評価を含みません。また、3B の方策を 8 基の H100 で学習する条件での値です。第 2 節の約 7,768 ステップ、約 52 分、約 8 個のチェックポイント、約 1.67 s は、論文の比率をもとにした本サイトの計算です。第 3 節の短い介入についての指摘はラベルの定義から本サイトが導いたもので、論文には対応するデータがありません。
- 論文での人の介入はデータ収集の仕組みであり、読んだテキストでは安全性の評価として扱われていません。これらの実機の結果も、ハードウェアの安全性を検証したものではありません。
リンク
- Training in Deployment: Human-in-the-loop Online Post-Training for Robot Manipulation(arXiv 2610.29264)
- 論文 HTML 全文
- フィジカルAIラボ 1.6:模倣学習――誤差がお手本のカバー範囲からはみ出すまでを手で計算し、ACT・拡散方策・データのスケーリング則の数字をそれぞれの条件に照らして読む
- フィジカルAIラボ 1.7:強化学習――1 回分の収益を手で計算して報酬の抜け道を見つけ、論文の地形カリキュラムとタイムアウト時のリセットを読む
- フィジカルAIラボ 1.8:評価――「差し引き +2」を対応表に分解し、失敗ラベルと乱数シードを計算で確かめる
- フィジカルAIラボ 2.3:SmolVLA をファインチューニングする――指示に合わせてお手本を計画し、各数字が何を測ったかを確かめ、非同期の動作キューの時間を計算する
- フロンティア・レーダー特集|学習と自己改善:VLA ポストトレーニングの 3 つの段階とオンライン RL の task collapse
- フロンティア・レーダー|Beyond Binary Success:実機試行が限られるなか、逐次検定で方策の優劣を早く見分ける
- フィジカルAIラボ:すべての数字を確認できるフィジカルAI講座(講座の概要)