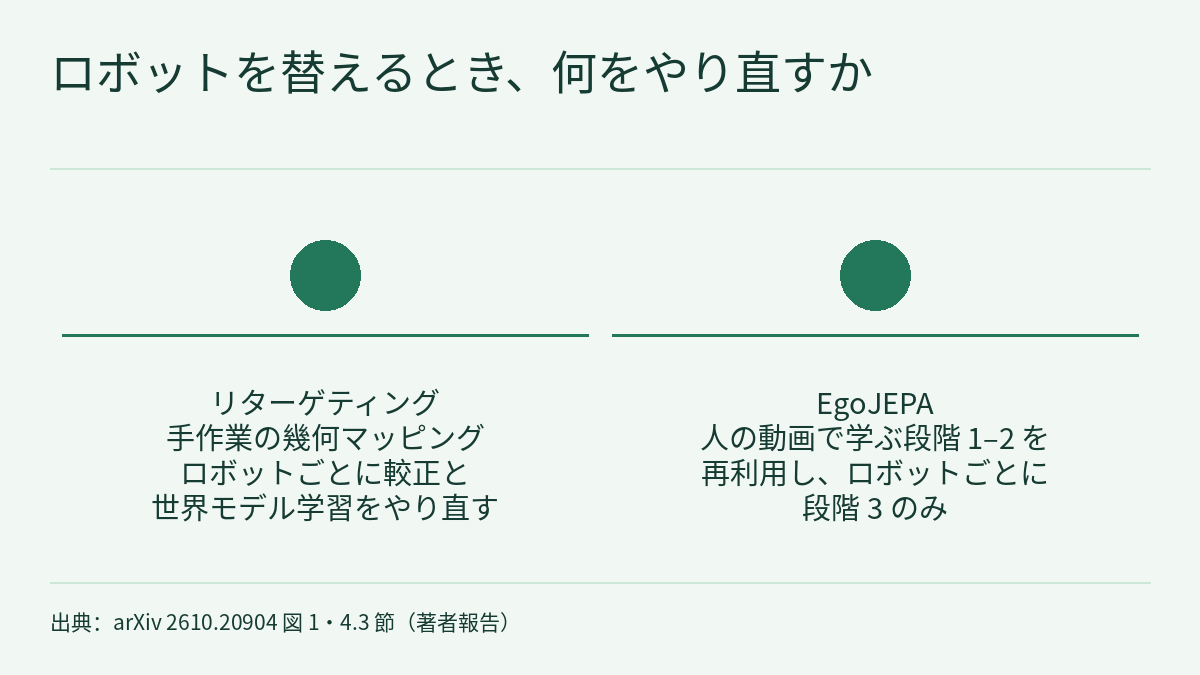
一人称視点の人間の動画から器用な操作を学ぶとき、よく使われるのは、人の手首と指の姿勢を幾何的なルールで特定のロボットの動作へリターゲティングし、それで事前学習する方法です。プレプリント EgoJEPA(arXiv 2610.20904、2026-10-14)はこの段階を置きません。隣り合うフレームの手のアノテーションの差分を条件とする JEPA 型の視覚予測で、ロボットの身体に依存しない潜在動作の空間を学び、人間の動画で世界行動モデルを学習します。ロボットを替えるときは、動作ブランチに 1 組のアダプターを新たに挿入し、ロボットのデモで第 3 段階の調整を行います。著者は、3 種類の身体による実機 5 タスクで分布外の平均成功率 74%、同じアーキテクチャのリターゲティング基準は 65%、5 タスク累計の身体間の実時間(ウォールクロック時間)は 743.2 時間から 392.7 時間へ(47.2% 減)と報告しています。この論文で詳しく読む価値があるのは 2 つの勘定です。リターゲティングのコストが具体的にどこで生じているか、そして各改善が何回の試行に基づいているかです。以下の数字はすべて著者報告 [R] で、本サイトでは再現していません。
リターゲティングの 2 つのコスト
著者はリターゲティングの問題を 2 点にまとめています。1 つ目は、マッピングが身体に縛られることです。手作業の幾何・運動学マッピングは特定のロボット形態向けに書かれ、形態が変われば較正をやり直す必要があります。論文の図 1(a) では、人とロボットの較正だけで 52.1 時間かかり、パイプライン全体の時間の 25.2% を占めます。読んだ本文には、これがどのタスクのパイプラインかは書かれていません。2 つ目は、ノイズがそのまま下流へ伝わることです。手の姿勢推定は遮蔽、視点の変化、時間的なゆらぎの影響を受け、その誤差はリターゲティングを通じて物理的に実行不能なロボット動作になります。人間の動作アノテーションにだけ軸ごとに σ = 10 mm のガウス位置ノイズを加え、ロボットの学習は変えないストレステストでは、ボトルキャップ外しでのリターゲティングの成功率は 60% から 30% に下がりました。
もう 1 つの路線は、手のアノテーションを使わず、フレーム間の視覚的な変化から直接潜在動作を学ぶものです(比較対象の LAPA がこれにあたります)。著者は、こうした潜在変数が、制御可能な手の動きとカメラの動きや受動的なシーンの変化を混同しうると指摘します。EgoJEPA はその中間に位置します。明示的な手の動きを教師に使いながら、どのロボットの座標にも写像しません。
論文の関連研究では、EgoScale、EgoMimic、DexWild などをリターゲティング系に分類し、同時期の Being-H0 が VQ-VAE で MANO 軌道を動作トークンに離散化していることにも触れています。著者の批判は、そのトークナイザーが手の姿勢系列だけを見て、視覚的な文脈を見ないという点です。
3 つの段階:手の動きの差分からロボットごとのアダプターまで
- 段階 1、人間の動作による事前学習:「人間の動作」は隣り合うフレームの手のアノテーションの差と定義されます。アノテーションは 2D/3D キーポイント、MANO パラメータ、その他の手の姿勢表現のいずれでもよく、時間幅 H の差分系列を使います。動作エンコーダーがこの系列を潜在動作に変換し、予測器が直前の各フレームの視覚エンコードと組み合わせて、フレーム t+H のターゲット表現を予測します。ターゲットエンコーダーはオンラインエンコーダーの指数移動平均で、ターゲット側には勾配を流さず、損失は L1 です。著者はこうして得た潜在動作を「効果を考慮した(effect-aware)」ものと呼びます。手の動きが画像に何をもたらしたかを説明しなければならないからです。
- 段階 2、潜在動作に基づく世界モデル学習:段階 1 の動作エンコーダーを凍結し、人間の動画に潜在動作のラベルを付けます。世界行動モデルは言語指示を条件に、結合 flow matching で将来の視覚表現と潜在動作を同時に予測します。動作ブランチの教師はこの潜在動作で、リターゲティングで得た座標レベルのロボット動作ではありません。
- 段階 3、身体ごとの調整:段階 2 から初期化し、動作ブランチに入力・出力の 2 つのアダプター(それぞれ 2 層 MLP で、層の間に ReLU)を挿入します。入力側はロボットの動作トークンを共有動作空間へ、出力側は出力を対象ロボットの動作空間へ写像します。ロボットの動作も、段階 1 の相対的な手の動きに合わせて隣接時刻の差分で表し、視覚エンコーダーは変えません。
実装では、段階 1 の視覚エンコーダーを Wan2.2 VAE エンコーダーから初期化し、予測器は 24 層のフレーム因果 Transformer です。段階 2 の動画 Transformer は Wan2.2-TI2V-5B から初期化し、潜在動作は特徴次元に沿って平均プーリングして 128 次元にします(段階 1 では 1024 次元)。付録の表 A3 には見落としやすい点があります。段階 3 で学習するのは動画 DiT、動作 DiT とアダプターで、アダプターだけではありません。3 つの段階はそれぞれ 32、64、64 基の GPU で 3,500、6,000、3,000 ステップ学習します。段階 1–2 はカメラ 1 台で固有感覚なし、段階 3 はカメラ 3 台で固有感覚の条件を加えます。したがって「軽量アダプター」とは、ロボットごとに追加されるモジュールのことで、ロボットごとに学習するのがそれだけという意味ではありません。
評価の設定と主な結果
人間のデータ:商業的に購入した一人称視点のデータセットで、62,518 回の収録から得た 1,111,943 エピソード、約 20,106.6 時間、21.7 億フレーム、タスク指示 64,686 件、シーンラベル 608 種です。単眼 RGB、約 30 Hz で、手首の姿勢と片手あたり 21 個の 3 次元キーポイントが付いています。付録によれば、非商業の学術研究向けにライセンスされています。
ロボットのタスク:Sharpa 多指ハンドでぬいぐるみをつかむ(動作 56 次元、デモ 750 本)、Wuji 多指ハンドでカップを積む(52 次元、916 本)、ファスナーを引く(623 本)、ボトルキャップを外す(635 本)、Xense Tac UMI グリッパーで紙箱を折る(14 次元、843 本、1 本平均 297.6 秒)。各タスクを分布内と分布外でそれぞれ 20 回試し、成功はタスクを最後まで完了することと定義します。分布外には、未見の物体と、学習分布の外にある位置・向きの配置が含まれます。
比較対象:LAPA(動作アノテーションなしの潜在動作手法)、DexWild(人間の動画とロボットのデモの共同学習)、リターゲティング・パイプライン(EgoJEPA と同じアーキテクチャで、潜在動作を幾何的リターゲティングによるロボットの目標に置き換えたもの。Sharpa と Wuji は公式のリターゲティング SDK、グリッパーは親指と人差し指の指先間距離を開き幅に写像)、ロボットデータのみのアブレーション、段階 1 を VQ-VAE による手の動きの再構成に置き換えた変種です。リターゲティング基準はアーキテクチャを共有しているので、EgoJEPA との主な違いは動作のインターフェースです。
| 手法 | 分布内の平均 | 分布外の平均 |
|---|---|---|
| EgoJEPA | 94% | 74% |
| リターゲティング・パイプライン | 80%(「14 ポイント高い」から本サイトが算出) | 65% |
| EgoJEPA(VQ-VAE の段階 1) | 読んだ本文に記載なし | 63% |
| DexWild | 読んだ本文に記載なし | 40% |
| EgoJEPA(ロボットデータのみ) | 読んだ本文に記載なし | 40% |
著者は、EgoJEPA が 5 タスクすべてで最も高いと報告しています。LAPA の平均値は読んだ本文には書かれていません。分布外で成功率が最も低い 2 タスクはボトルキャップ外しと紙箱折りで、著者は、前者では瓶を支えながらキャップを回す両手の協調が、後者では厳密な幾何的位置合わせを伴う多段階の操作が必要なためと説明しています。人間による事前学習を除くと、分布外の平均は 74% から 40% に、ボトルキャップ外しは 70% から 30% に下がります。JEPA の予測を VQ-VAE の再構成に置き換えると 74% から 63% に下がり、著者はここから、手の動きがもたらす視覚的な結果を学ぶほうが、動きそのものを再構成するより有用だと結論づけています。
分母に注意してください。各タスク・各設定で 20 回なので、1 タスクの 5 ポイントは試行 1 回分です。5 タスクを等しく重みづけすると、74% と 65% の差は分布外 100 回の試行で成功が 9 回多いことにあたります(本サイトの計算)。主な結果には信頼区間も有意性検定も付いていません。
ノイズと身体間の時間:2 つの勘定の読み方
ロボットデータの効率(ボトルキャップ外し、分布外):ロボットのデモを 10% だけ使った EgoJEPA の成功率は 35% で、全デモを使ったロボットデータのみのモデル(30%)を上回ります。50% を使うと 65% で、全デモを使ったリターゲティング基準(60%)を上回ります。論文の図 5 では、20 回の試行に対する 95% のウィルソン区間が網掛けで示されています。20 回に換算すると、35% 対 30% は成功 7 回対 6 回、65% 対 60% は 13 回対 12 回で、いずれも差は 1 回です。本サイトがウィルソンの式で概算すると、7/20 の区間は約 18%–57%、6/20 は約 15%–52% で、大きく重なっています。「どのデータ量でも上回る」は点推定では成り立ちますが、これらの比較だけでは両者を区別できません。
アノテーションのノイズ:摂動は段階 1–2 の人間のアノテーションにだけ加え、段階 3 はきれいなロボットデータを使い、ボトルキャップ外しの分布外設定で評価します。位置ノイズの σ は 0、2、5、10 mm、時間ずれの最大オフセットは 0、3、6、12 フレーム(30 Hz で約 0、100、200、400 ms)、アノテーション欠落は 0%、10%、20%、40% です(欠落区間は線形補間、回転は球面線形補間)。σ = 10 mm では、EgoJEPA は 70% から 60%(14/20 → 12/20)、リターゲティングは 60% から 30%(12/20 → 6/20)に下がります。3 種類の摂動のうち影響が最も大きいのは時間ずれで、12 フレームのオフセットで EgoJEPA は 50% になります。影響が最も小さいのは欠落で、40% の欠落でも 65% です。
身体間の時間:著者は GPU 時間ではなくウォールクロック時間を報告しています。リターゲティング基準の人とロボットの較正がすべて CPU で動くためです。グリッパーによる紙箱折りでは、EgoJEPA の段階 3 が 37.5 時間、リターゲティング・パイプラインが 193.4 時間で、そのうち CPU による較正が 46.7 時間、GPU による世界モデル学習が 109.2 時間です。本サイトで差し引くと、リターゲティングの残りも 37.5 時間で、EgoJEPA の段階 3 と同じになります。論文はこの部分が何かを明記していませんが、これらの数字からは、節約は身体を替えるたびに較正と世界モデル学習をやり直さないことから生じていると読めます。5 タスクの累計は 743.2 時間から 392.7 時間に減り、(743.2 − 392.7) / 743.2 ≈ 47.2% で、論文の値と一致します。
この 47.2% を読むときは 3 点に注意が必要です。第一に、ウォールクロック時間は計算量ではありません。段階 3 は GPU 64 基、較正は CPU を使うので、両者の時間を足しても 1 種類の資源を数えたことにはなりません。第二に、392.7 時間に段階 1–2 の 1 回限りの事前学習が含まれるかは、読んだ本文には書かれていません。第三に、論文はリターゲティングが「新しいロボットの身体を導入するたびに」較正と世界モデル学習をやり直すと述べる一方、図 7 はタスクごとに時間を示しています。Wuji の 3 タスクが 1 回の較正を共有したかどうかは、読んだ本文には書かれていません。
本サイトの既存ページとの関係
フィジカルAIラボ 1.5:データはどこから来る?では、人間の動画の難しさとして、人の手はロボットの手ではないので、まず人の手をロボットの手に「翻訳」する必要があると説明しました。EgoJEPA の答えは、明示的な翻訳をせず、それを各ロボットの段階 3 に先送りして、ロボットのデモに学ばせることです。それでもフレームごとの手のアノテーションは必要で、各タスクでは 600 本台から 900 本台のロボットのデモを使っています。
フィジカルAIラボ 0.2:なぜ今なのかでは EgoScale の 20,854 時間の一人称視点動画を引用しました。EgoJEPA の論文は EgoScale をリターゲティング系に分類しています。EgoJEPA 自身が使った約 20,106.6 時間は別の商業データセットなので、2 つの時間数は異なるデータについてのもので、比べることはできません。
フロンティア・レーダー|DexStitchは逆の路線で、接触に導かれた修復(インペインティング)によって、人の動画を明示的に多指ハンドのデータへ変換します。同じ日の TDV は手か物体の姿勢軌道を中間表現に使い、Being-M0.7 は人間の動画と動作のデータを人型ロボットの全身制御につなぎます。これらの論文はロボット、タスク、指標がそれぞれ異なるため、成功率を論文どうしで比べることはできません。違いは、人間のデータとロボットの動作のあいだにどんなインターフェースを置くかにあります。
フィジカルAIラボ 1.8:評価では、まず分母と条件を確かめる練習をしました。本記事の百分率はどれも、「20 回、どのタスク、分布内か分布外か」と一緒に伝えるべきものです。
制約と注意点
- これは arXiv のプレプリントで、すべての数字は著者報告 [R] です。本サイトでは再現していません。論文の冒頭にはプロジェクトページのアドレスが載っていますが、本サイトでは開いて確認していないため、リンクしていません。読んだ本文にはコード公開の情報はありません。
- 段階 1–2 の人間のデータは商業ライセンスのデータセットで、付録によれば非商業の学術研究向けにライセンスされています。公開されるかどうかは読んだ本文に書かれておらず、外部から同じデータで事前学習を再現するのは難しいでしょう。
- 各タスク・各設定の試行は 20 回だけで、主な結果には信頼区間も有意性検定もありません。データ効率とノイズ耐性の実験はボトルキャップ外しの 1 タスクだけで行われています。
- 「軽量アダプター」に加えて、段階 3 では動画・動作 DiT も微調整し、カメラ 3 台と固有感覚に切り替えています。各タスクで 623–916 本のロボットのデモを使っています。
- 身体間の節約はウォールクロック時間で数えており、CPU による較正と GPU 64 基の学習が混在しています。段階 1–2 の 1 回限りのコストを含むかは、読んだ本文に書かれていません。
- 著者自身が挙げる制約:アノテーションの深刻な劣化(大きな時間のずれ、長い遮蔽)は依然として潜在表現をゆがめうること、ボトルキャップ外しのように細かな接触ダイナミクスを要する分布外タスクでは性能が下がることです。著者は、明示的な相互作用のモデル化や力覚フィードバックの事前知識を取り入れることを今後の方向としています。
- 論文の影響に関する記述では、実環境への展開には安全と物理的な隔離の手順が必要だとしています。本記事で紹介した結果はハードウェアの安全性検証ではありません。
リンク
- EgoJEPA: Beyond Retargeting for Dexterous Manipulation from Egocentric Videos(arXiv 2610.20904)
- 論文の HTML 全文
- フィジカルAIラボ 1.5:データはどこから来る?――SO-101 のメタデータからお手本の長さを求め、三つの入手ルートの単位と動作空間を見分ける
- フィジカルAIラボ 0.2:なぜ今なのか、データ・モデル・計算資源の 3 本の曲線
- フィジカルAIラボ 1.8:評価――「差し引き +2」を対応表に分解し、失敗ラベルと乱数シードを計算で確かめる
- フロンティア・レーダー|DexStitch:「遷移」もスキルとしてラベル付けし、人間の動画から多指ハンドのスキルを切り出し、変換し、つなぎ合わせる
- フロンティア・レーダー|TDV:1 本の人の動画から手か物体の姿勢軌道だけを取り出し、始点を変えて 50 本に増やしてから軌道拡散方策を学習する
- フロンティア・レーダー|Being-M0.7:映像だけ・動作だけの人間データを、3 段階の学習とゲート付き接続で人型ロボットの全身制御につなぐ
- フィジカルAIラボ:すべての数字を確認できるフィジカルAI講座(講座の概要)