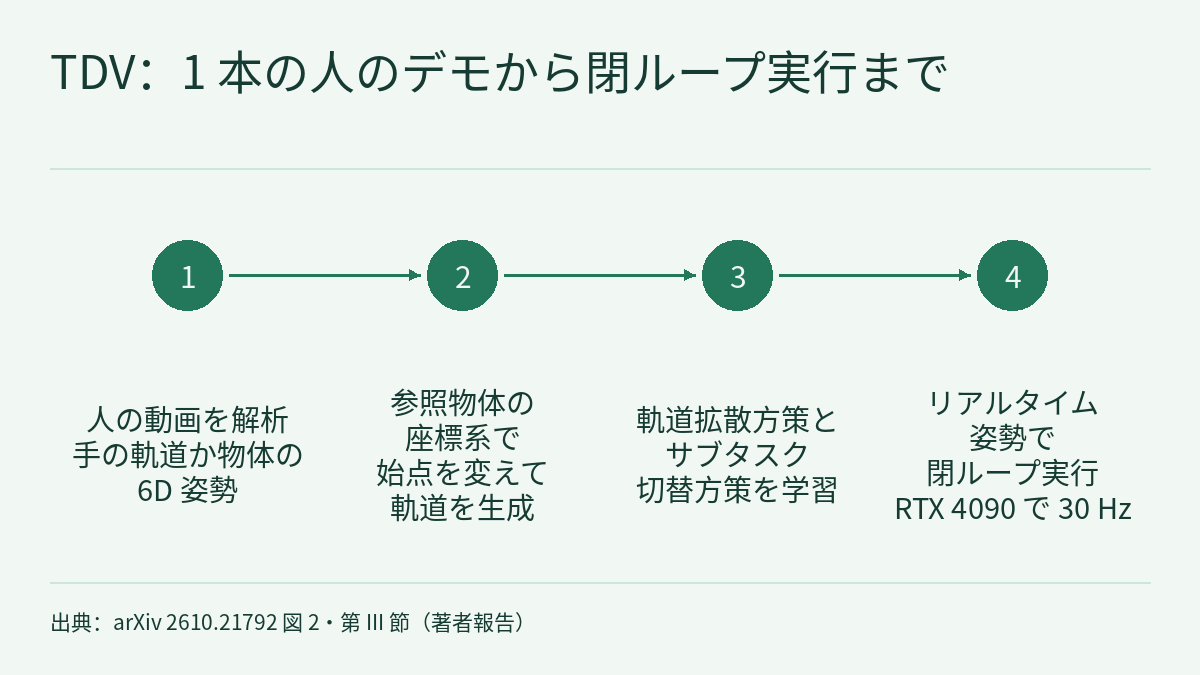
人の動画からロボットに教えるには、2 つの壁を同時に越える必要があります。映っているのはロボットではなく人の手であり、動画にはロボットの動作ラベルもありません。プレプリント TDV(arXiv 2610.21792、2026-10-15)は、方策に画像を一切見せないという方法をとります。1 本の人のデモンストレーションから手または物体の姿勢軌道だけを取り出し、参照物体の座標系で表したうえで、「初期位置を変える」ことで 1 本のデモを 15 本、50 本に増やし、入力も出力も軌道である拡散方策を学習します。著者報告では、RLBench の 12 タスクで平均成功率 91.8%、実機では 1 本の人のデモを 50 本に拡張したあと、3 つの物体タスクの位置汎化が合計 38/39 でした。この論文を読むときは、まず 2 点を区別しておく必要があります。シミュレーションの結果は環境が与える真値の姿勢を使っており、「人の動画から抽出する」段階を経ていません。チェーン全体を検証しているのは実機の結果だけで、その各マスの分母は 5 回か 13 回です。以下の数字はすべて著者報告 [R] で、本サイトでは再現していません。
考え方:姿勢軌道で視覚の差と動作ラベルの欠如を同時に避ける
論文は既存の方法を 2 種類に分け、それぞれの弱点を挙げています。画像編集で画面の人をロボットに置き換えたり人を消したりする方法は、編集の品質に左右されます。オプティカルフロー(flow)を中間表現にする方法は、身体の違いによる見た目の差には頑健ですが、展開時のカメラ視点をデータ収集時と一致させる必要があります。本サイトで紹介した DexStitch は前者に当たり、人の手を多指ハンドに描き替えてから視覚方策に渡します。TDV はそもそも方策に画像を渡しません。著者の理由は、操作タスクで重要なのは誰が実行するかではなくタスクに関わる物体の状態変化であり、6D 物体姿勢の系列からなる軌道は、視覚ドメインにも身体にも依存せずに操作中の状態遷移を記録できる、というものです。
1 本のデモは、まず「動く主体または参照物体が変わるかどうか」でいくつかのサブタスクに分けられ、各区間が 2 種類のどちらかに分類されます。注水を例にとると、やかんをつかむのが手のタスク、続いて注ぐのが物体のタスクです。
- 手のタスク:HaMeR で 21 関節の MANO 手モデルを再構成します。実験では 2 本指グリッパーを使うため、著者は親指 MCP、親指 IP、人差し指 MCP の 3 関節をとり、外積でグリッパー先端の姿勢に合わせた座標系をつくります。位置は親指 MCP と人差し指 MCP の中点です。
- 物体のタスク:まず TRELLIS で物体の近接画像 1 枚から 3D メッシュを生成します。生成したメッシュにはスケールがないため、SAM2 で切り出した点群に対して相似変換の ICP を行い、全体のスケールを推定します。タスクの説明文をテキストプロンプトとして GroundingSAM が最初のフレームのマスクを出し、SAM2 の動画予測器がそれを後続のフレームに伝えます。最後に FoundationPose がメッシュとマスクを使い、RGB-D 入力から物体の 6D 姿勢を推定します。
どちらの軌道も、視点の変化の影響をなくすため参照物体の座標系で表します。これは フィジカルAIラボ 1.1:座標系と運動学で扱ったのと同じことです。原点を変えれば同じ位置でも数字はすべて変わります。軌道を参照物体に結び付けておけば、カメラをどこに動かしても軌道そのものは変わりません。なお、物体の系統には深度と物体の近接画像が必要で、どんな普通の動画でもそのまま入力できるわけではありません。
1 本のデモが 50 本になるまで:初期位置を変える軌道生成
フィジカルAIラボ 1.5:データはどこから来る?では、MimicGen のように少数のデモを自動で増やす合成の方法を扱いました。TDV も MimicGen を引用し、中間表現としての軌道が計算効率とデータ拡張の面で有利だと述べています。拡張のルールは控えめです。元の軌道の実行可能性を保つため、作業空間内で対象物体の初期姿勢だけをランダムに変え、終点は固定します。軌道は参照物体の座標系で表されているので、参照物体の姿勢の変化は対象物体の姿勢の変化と等価に扱えます。
- 位置:元の始点と新しい始点から固定された終点へのベクトルをそれぞれ求め、XY 平面に射影します。元の軌道を元の射影ベクトルの長さで正規化し、新しい射影ベクトルの長さで拡大縮小し、2 つの射影ベクトルのなす角 r だけ回転させると、原点から始まる軌道が得られます。最後に、元の始点から新しい始点へのオフセットベクトルだけ平行移動します。
- 向き:最後の操作を一致させるため、軌道の終わりの一定割合 α∈(0,1) の区間では元の向きを保ちます。新しい始点の向きとこの終端区間のあいだは、球面線形補間(Slerp)で滑らかにつなぎます。論文は α の値を示していません。
仮の数字で例を挙げます(論文のデータではありません)。XY 平面で元の始点が終点から 0.30 m、新しい始点が終点から 0.15 m で方位が 40° 違うとすると、軌道全体を 0.15 ÷ 0.30 = 0.5 倍に縮め、40° 回転させて新しい始点へ平行移動します。終点付近の向きは元のデモのままです。こうして生成した軌道は元のデモの形を保ち、変わるのは始点だけです。本サイトが読んだ本文には、このステップで高さ方向をどう扱うかは別に書かれていません。
方策と閉ループ実行:軌道拡散 Transformer とサブタスク切替方策
方策が学習するのは f(目標軌道の今後 n ステップ | 目標軌道の過去 h ステップ、タスクの説明 l、サブタスク信号 s)で、この条件付き分布を DDPM で近似します。過去の軌道は 2 層の MLP で潜在空間に写され、タスクの説明は BERT でトークン化され、サブタスク信号は学習可能な埋め込みで表されます。3 つはそれぞれの位置エンコーディングを加えたうえで Transformer エンコーダーにより統合されます。デコーダーには DiT ブロックを使い、統合した特徴とタイムステップの埋め込みを条件とします。著者は 2 つの設計を強調しています。入力は現在の姿勢だけでなく一定区間の過去の軌道であり、同じ姿勢に戻る必要があるタスクではこれが重要だという点、そしてエンコーダーをノイズ除去の過程から切り離して推論を効率化した点です。h、n、ノイズ除去のステップ数の値は示されていません。
複数段階のタスクは切替方策で進めます。これは MLP の分類ネットワークで、過去の軌道とタスクの説明から現在のサブタスクが完了したかを判定します。1 を出力すると、サブタスク信号が 1 つ進み、グリッパーの状態が切り替わります。信号がサブタスク数の最大値に達すると、タスクは完了です。学習時には各サブタスク区間の最後のフレームだけを 1、それ以前をすべて 0 とし、クラスの不均衡に対処するため損失の重みの比を 1:100 にしています。
展開時には、物体のタスクでは FoundationPose が動く物体と参照物体の姿勢をリアルタイムに推定し、手のタスクではグリッパー先端の姿勢を動く主体の姿勢とします。これらの姿勢を拡散方策の履歴に戻すことで閉ループになります。著者報告では、パイプライン全体が NVIDIA RTX 4090 1 基で 30 Hz のリアルタイムで動き、操作中に物体が落ちても実行を続けられます。物体の軌道をどのようにアームの先端指令に変換するかは、本サイトが読んだ本文には書かれていません。
RLBench:検証しているのは「軌道を観測とすること」で、人の動画からの学習ではない
シミュレーション実験では RLBench の 12 タスクを選び、各タスクには 2〜60 のバリエーション(色、形、目標位置が異なる)があります。タスクごとに 100 本のデモで学習し、25 本を評価用に残しています。結果は 3 つの乱数シード、各 25 試行の平均です。論文は、ここでは人の動画からの軌道抽出を行わず、動く物体と参照物体の観測をどちらも環境の真値から得ていると明記しています。つまりこの数字が検証しているのは姿勢軌道を方策の観測として使うことの有効性であり、姿勢推定の誤差も、人からロボットへの移行も含みません。
| タスク | OpenVLA | RVT2 | 3D-DA | SPOT | TDV |
|---|---|---|---|---|---|
| Close Jar | 1.3 | 100.0 | 49.3 | 98.7 | 100.0 |
| Drag Stick | 1.3 | 100.0 | 100.0 | 80.0 | 100.0 |
| Insert Peg | 0.0 | 41.3 | 64.0 | 78.7 | 98.7 |
| Meat off Grill | 4.0 | 94.6 | 94.6 | 100.0 | 100.0 |
| Place Cups | 2.0 | 40.0 | 22.6 | 62.7 | 73.3 |
| Place Wine | 4.6 | 86.6 | 92.0 | 100.0 | 98.7 |
| Put in Cupboard | 0.0 | 65.3 | 86.6 | 42.7 | 98.7 |
| Put in Safe | 4.6 | 96.0 | 100.0 | 100.0 | 98.7 |
| Screw Bulb | 0.0 | 88.0 | 76.0 | 48.0 | 81.3 |
| Sort Shape | 0.0 | 48.0 | 49.3 | 32.0 | 69.3 |
| Stack Blocks | 0.0 | 68.0 | 71.0 | 94.0 | 88.0 |
| Stack Cups | 0.0 | 76.0 | 53.3 | 96.0 | 94.7 |
| 平均 | 1.5 | 71.6 | 75.3 | 79.4 | 91.8 |
表は成功率の平均(%)で、論文にある標準偏差は省いています。比較の条件は完全にはそろっていません。RVT2 と 3D-DA は公式の手順でこの 12 タスクに再学習し、OpenVLA は公開チェックポイントを LoRA で微調整しています。SPOT は実装が公開されていないため、元の論文の数字をそのまま載せています。本サイトが読んだ本文には各ベースラインの入力も書かれていません。比較の際は、TDV がここでは真値の姿勢を受け取り、画像から自分で推定する必要がないことを念頭に置いてください。
本文の記述を表と照らし合わせると、次のようになります。要旨の「7 タスクでほぼ 100%」は、TDV が 98.7 以上のタスクがちょうど 7 つあることと一致します。本文は 12 タスク中 8 タスクで TDV が 1 位だとしていますが、表で TDV が単独で最高なのは 4 タスク(Insert Peg、Place Cups、Put in Cupboard、Sort Shape)で、同率首位を含めても 7 タスクです。本文は Insert Peg と Sort Shape で 20% を超えて上回るとしていますが、表ではどちらも次点の手法をちょうど 20.0 ポイント上回っています。本文は平均で従来の最高を 13.4% 上回るとしていますが、表の SPOT の 79.4 との差は 12.4 ポイント、相対では約 15.6%(本サイトの計算)で、どちらも 13.4 ではなく、論文はこの数字の計算方法を示していません。Screw Bulb と Stack Blocks で振るわなかった理由について、著者は RLBench での動作計画の実行不能と、未知の相対的な空間配置による誤差を挙げています。
実機:1 本のデモを何本まで増やせば足りるか
実機は UR5 アームに Robotiq 2F-85 グリッパーを付けたもので、Intel RealSense D435 カメラを 6 自由度の調整式アームに取り付けています。6 つのタスクは 2 種類に分かれます。物体のタスクは Cup-Coaster(カップをコースターに置く)、Stitch-Card(スティッチのぬいぐるみをカードに置く)、Pour-Water(水を注ぐ)、手のタスクは Pull-Drawer(引き出しを開ける)、Unplug-Charger(充電器を抜く)、Pull-Tissue(ティッシュを引き出す)です。
空間汎化は 3 つの物体のタスクだけで評価しています。著者の理由は、手のタスクでは相対的な動きがふつう一定で、参照物体の姿勢もリアルタイムに推定できるため、1 本のデモで足りることが多い、というものです。45 cm × 50 cm の作業空間でランダムに 13 か所を選んで位置汎化(PG)を、その 13 か所でランダムに向きを乱して姿勢汎化(PoG)を評価しました。
| 学習に使った軌道数 | Cup-Coaster PG / PoG | Stitch-Card PG / PoG | Pour-Water PG / PoG | 合計 PG / PoG(本サイトの集計) |
|---|---|---|---|---|
| 1(デモ 1 本) | 6/13 / 6/13 | 4/13 / 5/13 | 4/13 / 1/13 | 14/39 / 12/39 |
| 15(1 本から拡張) | 7/13 / 11/13 | 10/13 / 8/13 | 12/13 / 9/13 | 29/39 / 28/39 |
| 50(さらに拡張) | 13/13 / 12/13 | 12/13 / 12/13 | 13/13 / 9/13 | 38/39 / 33/39 |
軌道が 1 本だけのとき、著者は方策が過学習すると述べています。毎回の実行の最初に学習時の初期姿勢へ戻ってしまい、効率が悪いうえに衝突も起きやすくなります(論文の図 3)。これは フィジカルAIラボ 1.6:模倣学習で扱ったお手本のカバー範囲の問題そのものです。始点がデモでカバーされていない場所に来ると、方策は見たことのある状態に寄っていくしかありません。15 本ではカバーがまだまばらで、拡張したデータの分布から遠い始点では実行に失敗します。本文は 50 本で「成功率が 100% に近づく」としていますが、これが成り立つのは位置汎化(38/39、約 97.4%)で、姿勢汎化は合計 33/39(約 84.6%)です。Pour-Water の PoG は 15 本でも 50 本でも 9/13 で、向上していません。表にはもう 1 つ、論文が説明していない点があります。Cup-Coaster の 15 本のとき、PG は 7/13 で、より難しいはずの PoG の 11/13 を下回っています。
視覚ドメインの汎化は背景と視点を扱います。人のデモはロボットの作業空間とは背景の異なる環境で撮影し、展開時にさらに 4 種類の背景の変化を加えました。また、データ収集時とは異なる 3 つのカメラ視点でも評価しています。各条件・各汎化の種類について、姿勢をランダムにした 5 試行を 6 つのタスクすべてで行いました。
| タスク | PG(7 条件の合計) | PoG(7 条件の合計) |
|---|---|---|
| Cup-Coaster | 35/35 | 34/35 |
| Stitch-Card | 34/35 | 32/35 |
| Pour-Water | 35/35 | 33/35 |
| Pull-Drawer | 34/35 | 33/35 |
| Unplug-Charger | 33/35 | 34/35 |
| Pull-Tissue | 33/35 | 34/35 |
失敗はおもに 2 つの状況で起きました。カメラが急な真上からの角度になるとスティッチのぬいぐるみのような小さな物体の位置を特定しにくいこと、物体の色が背景と近いと姿勢の追跡に失敗することです。この実験で何本の拡張軌道を使ったかは、本サイトが読んだ本文には書かれていません。フィジカルAIラボ 1.8:評価では、まず分母を見る練習をしました。ここでは各マス 5 回、各タスク・各種類 35 回なので、34/35 と 32/35 の差は 2 試行にすぎず、タスクの難易度を比べるには足りません。論文は「身体をまたぐ移行」を視覚ドメイン汎化の一側面に挙げていますが、実験で使ったロボットは 1 種類(UR5 と 2 本指グリッパー)だけです。ここでいう身体をまたぐ移行とは人の手からこの 1 台のアームへの移行のことで、身体をまたぐ移行だけの結果表はありません。
制約と注意点
- arXiv のプレプリントで、数字はすべて著者報告 [R] です。本サイトでは再現していません。著者は清華大学深圳国際大学院、Zerith Robotics、中国科学技術大学に所属し、研究の一部は Zerith Robotics の支援を受けています。本サイトが読んだ本文には、コードやプロジェクトページへのリンクはありません。
- 著者自身が、手法は正確な 6D 姿勢推定に大きく依存し、形状が複雑な物体や変形して安定に追跡しにくい物体には適用しにくいと書いています。
- 序論はインターネット上の大量の人の動画を動機に挙げていますが、物体の系統には物体の近接画像と RGB-D 入力が必要で、実験も自分たちで撮影したデモだけを使っています。インターネットの動画では検証していません。
- RLBench の結果は真値の姿勢を使っており、人の動画からの抽出も姿勢推定の誤差も含みません。SPOT の数字は元の論文からの転載で、同じ手順で再実行したものではありません。本文の「12 中 8 で 1 位」「13.4% の向上」は表 I の数字と合わないため、表を基準にしてください。
- 実機評価は小規模です。空間汎化は各マス 13 回、視覚ドメインは各マス 5 回で、信頼区間は報告されていません。拡張で変わるのは始点だけで、元の軌道の形と終点は保たれるため、終点やつかみ方が違う場合は評価されていません。
- 手のタスクの対応づけは 2 本指グリッパーだけを対象に、親指と人差し指の 3 関節を使っています。多指ハンドは論じられていません。実機での安全性も論じられておらず、これらの結果はハードウェアの安全性検証にはなりません。
リンク
- Trajectory-based Diffusion from One-shot Human Video for Generalizable Manipulation(arXiv 2610.21792)
- 論文の HTML 全文
- フロンティア・レーダー|DexStitch:「遷移」もスキルとしてラベル付けし、人間の動画から多指ハンドのスキルを切り出し、変換し、つなぎ合わせる
- フィジカルAIラボ 1.1:座標系と運動学――2 リンクのアームがコップに届く計算を手で追う
- フィジカルAIラボ 1.5:データはどこから来る?――SO-101 のメタデータからお手本の長さを求め、三つの入手ルートの単位と動作空間を見分ける
- フィジカルAIラボ 1.6:模倣学習――誤差がお手本のカバー範囲からはみ出すまでを手で計算し、ACT・拡散方策・データのスケーリング則の数字をそれぞれの条件に照らして読む
- フィジカルAIラボ 1.8:評価――「差し引き +2」を対応表に分解し、失敗ラベルと乱数シードを計算で確かめる
- フィジカルAIラボ:すべての数字を確認できるフィジカルAI講座(講座の概要)