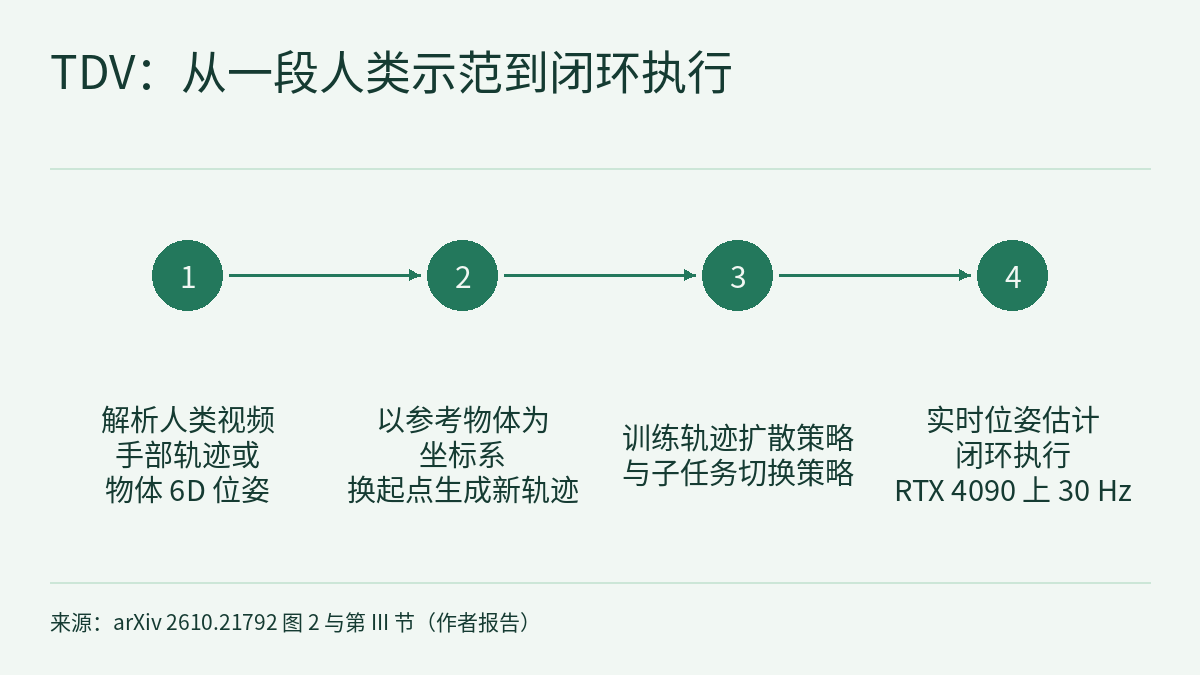
从人类视频教机器人,要同时跨过两道坎:画面里是人手而不是机器人,视频里也没有机器人的动作标签。预印本 TDV(arXiv 2610.21792,2026-10-15)的做法是不让策略看图像:从一段人类示范里只取出手或物体的位姿轨迹,把轨迹写在参考物体的坐标系里,再通过“换起点”把一条示范扩成 15 条、50 条,训练一个以轨迹为输入和输出的扩散策略。作者报告,RLBench 12 个任务平均成功率 91.8%;真机上一段人类示范扩增到 50 条后,三个物体任务的位置泛化合计 38/39。读这篇论文要先分清两点:仿真结果用的是环境给出的真值位姿,没有经过“从人类视频提取”这一步;真机结果才检验了整条链路,而每格的分母只有 5 或 13 次。以下数字均为作者报告 [R],本站未复现。
思路:用位姿轨迹同时绕开视觉差距和动作缺失
论文把已有做法分成两类,并各指出一个短板:用图像编辑把画面里的人换成机器人或直接抹掉,效果取决于编辑质量;用光流(flow)作中间表示,对不同本体造成的视觉差异较鲁棒,但部署时的相机视角要与采集时一致。本站介绍过的 DexStitch 属于前一类,它把人手修补成灵巧手再交给视觉策略;TDV 则完全不把图像交给策略。作者的理由是,操作任务关心的是任务相关物体的状态变化,而不是由谁来执行,所以一串 6D 物体位姿构成的轨迹就记录了操作过程中的状态转移,与视觉域和本体都无关。
一段完整示范先按“运动主体或参考物体是否改变”切成若干子任务,每段归为两类之一。以倒水为例,抓起水壶是手部任务,随后的倾倒是物体任务:
- 手部任务:用 HaMeR 重建带 21 个关节的 MANO 手模型。因为实验用的是两指夹爪,作者取拇指 MCP、拇指 IP 和食指 MCP 三个关节,用叉乘构造一个与夹爪末端位姿对齐的坐标系,位置取拇指 MCP 与食指 MCP 的中点。
- 物体任务:先用 TRELLIS 从物体的一张近景图生成三维网格;生成的网格没有尺度,再对 SAM2 分割出的点云做相似 ICP,估计全局缩放。以任务描述作文本提示,GroundingSAM 给出首帧掩码,SAM2 的视频预测器把掩码传到后续帧;最后 FoundationPose 根据网格和掩码,从 RGB-D 输入估计物体的 6D 位姿。
两类轨迹都写在参考物体的坐标系里,用来消除视角变化的影响。这与 物理AI实验室 1.1:坐标系与运动学讲的是同一件事:同一个位置换个原点,数字就全变;把轨迹挂在参考物体上,相机挪到哪里都不影响轨迹本身。需要注意,物体这一路要用到深度和物体近景图,并不是任意一段普通视频都能直接喂进去。
一条示范怎样变成 50 条:换起点的轨迹生成
物理AI实验室 1.5:数据从哪来讲过 MimicGen 这类“少量示范自动放大”的合成路线;TDV 也引用 MimicGen,说明轨迹作为中间表示在计算效率和数据扩增上的优势。它的扩增规则很克制:为保持原轨迹可行,只在工作空间内随机改变目标物体的初始位姿,终点保持不变。由于轨迹以参考物体为坐标系,参考物体位姿的变化可以等价成目标物体位姿的变化。
- 位置:分别求原起点和新起点指向固定终点的向量,投影到 XY 平面;原轨迹先除以原投影向量的长度归一化,再乘以新投影向量的长度,并旋转两投影向量之间的夹角 r,得到一条从原点出发的轨迹;最后平移一个从原起点指向新起点的偏移向量。
- 朝向:在轨迹末尾按比例 α∈(0,1) 保留一段原始朝向,保证最后的操作一致;新起点朝向与这段末尾之间用球面线性插值(Slerp)平滑过渡。论文没有给出 α 的取值。
举一个假设数字的例子(不是论文数据):若原起点在 XY 平面上离终点 0.30 m,新起点离终点 0.15 m、方位差 40°,那么整条轨迹按 0.15 ÷ 0.30 = 0.5 缩放、转 40° 再平移到新起点,终点附近的朝向仍沿用原示范。这样生成的轨迹保留了原示范的形状,变化的只有起点;所读正文没有单独说明高度方向在这一步怎样处理。
策略与闭环执行:轨迹扩散 Transformer 加切换策略
策略要学的是 f(未来 n 步目标轨迹 | 过去 h 步目标轨迹, 任务描述 l, 子任务信号 s),用 DDPM 近似这个条件分布。历史轨迹经两层 MLP 映射到潜空间,任务描述用 BERT 分词,子任务信号是可学习的嵌入,三者加上各自的位置编码后由 Transformer 编码器融合;解码器用 DiT 块,以融合特征和时间步嵌入为条件。作者强调两点设计:输入是一段历史轨迹而不只是当前位姿,这对需要回到同一位姿的任务很关键;编码器与去噪过程解耦,以提高推理效率。论文没有给出 h、n 和去噪步数的取值。
多步任务靠一个切换策略推进:它是 MLP 分类网络,根据历史轨迹和任务描述,判断当前子任务是否完成。输出 1 时,子任务信号加一,并改变夹爪状态;信号达到最大子任务数,任务即完成。训练时每段子任务只有最后一帧标为 1,其余标为 0,为应对类别不平衡,损失权重比设为 1:100。
部署时,物体任务用 FoundationPose 实时估计运动物体和参考物体的位姿,手部任务以夹爪末端位姿作为运动主体的位姿,这些位姿被送回扩散策略的历史序列,形成闭环。作者报告,整条流程在单块 NVIDIA RTX 4090 上以 30 Hz 实时运行,即使操作中物体掉落也能继续执行。所读正文没有写明物体轨迹怎样换算成机械臂的末端指令。
RLBench:测的是“轨迹当观测”,不是从人类视频学
仿真实验选了 RLBench 的 12 个任务,每个任务有 2–60 个变体(颜色、形状、目标位置不同),每任务用 100 条示范训练、留 25 条评测,结果是 3 个随机种子、每个 25 次试验的平均。论文写明,这里不做人类视频提取,运动物体和参考物体的观测都直接取自环境真值。也就是说,这组数字检验的是“把位姿轨迹当作策略观测”是否有效,不包含位姿估计误差,也不涉及人到机器人的迁移。
| 任务 | OpenVLA | RVT2 | 3D-DA | SPOT | TDV |
|---|---|---|---|---|---|
| Close Jar | 1.3 | 100.0 | 49.3 | 98.7 | 100.0 |
| Drag Stick | 1.3 | 100.0 | 100.0 | 80.0 | 100.0 |
| Insert Peg | 0.0 | 41.3 | 64.0 | 78.7 | 98.7 |
| Meat off Grill | 4.0 | 94.6 | 94.6 | 100.0 | 100.0 |
| Place Cups | 2.0 | 40.0 | 22.6 | 62.7 | 73.3 |
| Place Wine | 4.6 | 86.6 | 92.0 | 100.0 | 98.7 |
| Put in Cupboard | 0.0 | 65.3 | 86.6 | 42.7 | 98.7 |
| Put in Safe | 4.6 | 96.0 | 100.0 | 100.0 | 98.7 |
| Screw Bulb | 0.0 | 88.0 | 76.0 | 48.0 | 81.3 |
| Sort Shape | 0.0 | 48.0 | 49.3 | 32.0 | 69.3 |
| Stack Blocks | 0.0 | 68.0 | 71.0 | 94.0 | 88.0 |
| Stack Cups | 0.0 | 76.0 | 53.3 | 96.0 | 94.7 |
| 平均 | 1.5 | 71.6 | 75.3 | 79.4 | 91.8 |
表中是成功率均值(%),省略了论文给出的标准差。对照条件不完全一致:RVT2 和 3D-DA 按官方流程在这 12 个任务上重训;OpenVLA 用 LoRA 微调官方检查点;SPOT 的实现没有公开,数字直接取自其原论文。所读正文也没有说明各基线的输入,比较时要记住,TDV 在这里拿到的是真值位姿,不必自己从图像里估计。
按表核对正文的几句话:摘要说“七个任务接近 100%”,表中 TDV 达到 98.7 或以上的正好是 7 个任务。正文说 TDV 在 12 个任务中 8 个排第一,但按表计算,TDV 单独最高的是 4 个(Insert Peg、Place Cups、Put in Cupboard、Sort Shape),连同并列最高也只有 7 个。正文说在 Insert Peg 和 Sort Shape 上领先超过 20%,表中两者对次优方法都恰好高 20.0 个百分点。正文说平均比此前最优高 13.4%,表中对 SPOT 的 79.4 是高 12.4 个百分点、相对约 15.6%(本站换算),都不是 13.4,论文没有说明这个数怎么算。作者把 Screw Bulb 和 Stack Blocks 上的失利归于 RLBench 里运动规划不可行,以及没见过的相对空间构型带来的误差。
真机:一段示范扩增到多少条才够
真机是 UR5 机械臂加 Robotiq 2F-85 夹爪,Intel RealSense D435 相机装在可调的 6 自由度支架上。六个任务分两类:物体任务 Cup-Coaster(杯子放到杯垫上)、Stitch-Card(玩偶放到卡片上)、Pour-Water(倒水);手部任务 Pull-Drawer(拉开抽屉)、Unplug-Charger(拔充电器)、Pull-Tissue(抽纸巾)。
空间泛化只测了三个物体任务,作者的理由是手部任务的相对运动通常一致,参考物体位姿又能实时估计,一段示范往往就够。工作空间为 45 cm × 50 cm,随机取 13 个位置测位置泛化(PG),再在这 13 个位置上加随机朝向扰动测位姿泛化(PoG):
| 训练轨迹数 | Cup-Coaster PG / PoG | Stitch-Card PG / PoG | Pour-Water PG / PoG | 合计 PG / PoG(本站换算) |
|---|---|---|---|---|
| 1(单段示范) | 6/13 / 6/13 | 4/13 / 5/13 | 4/13 / 1/13 | 14/39 / 12/39 |
| 15(由 1 段扩增) | 7/13 / 11/13 | 10/13 / 8/13 | 12/13 / 9/13 | 29/39 / 28/39 |
| 50(继续扩增) | 13/13 / 12/13 | 12/13 / 12/13 | 13/13 / 9/13 | 38/39 / 33/39 |
只用一条轨迹时,作者描述策略会过拟合:每次开始都先回到训练时的初始位姿,既低效又更容易碰撞(论文图 3)。这正是 物理AI实验室 1.6:模仿学习讲的示范覆盖问题:起点一旦落在示范没覆盖的地方,策略就只会往见过的状态靠。扩增到 15 条时覆盖仍稀疏,离扩增分布远的起点会执行失败。正文说扩增到 50 条后“成功率接近 100%”,这对位置泛化成立(38/39,约 97.4%),位姿泛化合计是 33/39(约 84.6%),其中 Pour-Water 的 PoG 在 15 条和 50 条时都是 9/13,没有提高。还有一处表中现象论文没有解释:Cup-Coaster 在 15 条时 PG 是 7/13,低于本应更难的 PoG 11/13。
视觉域泛化包括背景和视角:人类示范在与机器人工作区背景不同的环境里录制,部署时再加 4 种背景扰动;另用 3 个与采集时不同的相机视角。每种条件、每类泛化各做 5 次随机位姿试验,六个任务都参与:
| 任务 | PG(7 种条件合计) | PoG(7 种条件合计) |
|---|---|---|
| Cup-Coaster | 35/35 | 34/35 |
| Stitch-Card | 34/35 | 32/35 |
| Pour-Water | 35/35 | 33/35 |
| Pull-Drawer | 34/35 | 33/35 |
| Unplug-Charger | 33/35 | 34/35 |
| Pull-Tissue | 33/35 | 34/35 |
失败主要出现在两种情况:相机取很陡的俯视角时难以定位 Stitch 玩偶这类小物体;物体颜色与背景相近时位姿跟踪失败。所读正文没有说明这组实验用的是多少条扩增轨迹。物理AI实验室 1.8:评测练过先看分母:这里每格 5 次、每个任务每类 35 次,34/35 与 32/35 之间只差两次试验,不足以区分任务之间的难易。论文把“跨本体迁移”列为视觉域泛化的一个方面,但实验只有一种机器人(UR5 加两指夹爪),所谓跨本体指的是从人手到这台机械臂,没有单独的跨本体实验表。
局限 / 注意
- 这是 arXiv 预印本,全部数字为作者报告 [R],本站没有复现。作者来自清华大学深圳国际研究生院、Zerith Robotics 和中国科学技术大学,研究部分由 Zerith Robotics 资助。本站所读文本中没有代码或项目页链接。
- 作者自己写明:方法高度依赖准确的 6D 位姿估计,几何复杂或可变形、难以可靠跟踪的物体不在适用范围内。
- 引言以互联网上的大量人类视频作动机,但物体这一路的流程需要物体近景图和 RGB-D 输入,实验也只用了自行录制的示范;论文没有在互联网视频上测试。
- RLBench 结果用真值位姿,不包含人类视频提取和位姿估计误差;SPOT 的数字取自其原论文,没有在同一流程下重跑。正文中“8/12 排第一”“提升 13.4%”与表 I 的数字对不上,以表为准。
- 真机评测规模小:空间泛化每格 13 次,视觉域每格 5 次,论文没有报告置信区间;扩增只改变起点、保留原轨迹形状和终点,终点位置或抓取方式不同的情况没有测。
- 手部任务的映射只针对两指夹爪,取拇指与食指的三个关节;论文没有讨论多指手。论文也没有讨论真机安全,这些结果不构成硬件安全验证。
链接
- Trajectory-based Diffusion from One-shot Human Video for Generalizable Manipulation(arXiv 2610.21792)
- 论文 HTML 全文
- 前沿雷达|DexStitch:把“过渡”也标成一个技能,从人类视频切出、转换并拼接灵巧手技能
- 物理AI实验室 1.1:坐标系与运动学,手算一条两连杆手臂怎样够到杯子
- 物理AI实验室 1.5:数据从哪来,从 SO-101 元数据算出示范时长,再分清三条来路的单位与动作空间
- 物理AI实验室 1.6:模仿学习,手算误差怎样滚出示范覆盖范围,再把 ACT、扩散策略与数据规模律的数字放回各自条件
- 物理AI实验室 1.8:评测,把“净增 2”拆成配对表,再给失败标签和随机种子算一笔账
- 物理AI实验室:一套每个数字都能核对的物理 AI 课程(课程大纲)