用动作条件的视频世界模型代替真机来评测和后训练策略,前提是它预测出的后果要可信。来自中国科学院自动化研究所、Anyverse Robotics、Open-Phoenix Team、新加坡国立大学、西安交通大学和北京理工大学的作者在预印本 PhysCanvas(arXiv 2610.28613,2026-10-20)里指出,画面看起来合理并不等于接触对了:物体已经滑脱,模型却仍预测稳定的触觉接触或最终成功,这样的推演会误导策略评测和优化。PhysCanvas 把多视角 RGB、触觉图像、触觉标记位移和任务状态排进同一张图像“画布”,共用一个视频 VAE 和预训练生成骨干来预测,再用三个冻结的奖励模型约束场景、视触一致性和任务成败。作者报告,在四项真机双臂任务上,加入任务状态监督后,策略在世界模型中的成功率与真机成功率的平均任务内 Pearson 相关从 0.602 升到 0.885;在加了奖励约束的世界模型里用 GRPO 后训练,π0.5 的真机平均成功率从 SFT 的 59.1% 升到 70.8%。以下数字均为作者报告 [R],本站未复现。
问题:视觉上合理,接触和成败却可能不对
论文认为现有做法有两处缺口。第一,已有的视触世界模型通常需要专门的触觉编码器,以及把触觉特征注入通用骨干的定制接口;换一种触觉数据或传感器配置可能就要重新训练。第二,逐 token 的重建监督强调局部保真,可能漏掉任务是否成功这类高层语义。作者因此提出两个问题:能否用一种简单、通用的机制把异构模态编码进同一个空间;能否不增加额外网络,就把高层语义注入世界模型。
触觉为什么要单独建模,物理AI实验室 1.3:传感器讲过:软胶垫后面藏一个小相机的光学触觉传感器,能看出物体是否打滑、纹理粗细。物理AI实验室 1.4:仿真器地图讲过物理仿真器里最难算的是接触那一下。PhysCanvas 走的是另一条路:不写接触模型,而是让视频生成模型直接预测触觉画面,再检查它和 RGB、任务结果是否说得通。
一张画布:四种观测共用一个视频 VAE,动作也画成图像
作者先检验一个前提:在大规模图像和视频上预训练的视觉 VAE,能否直接编码光学触觉图像。在 UniT 随附发布的 USB 3D-pose 触觉数据集上,不做触觉微调的 Wan VAE 的 PSNR 为 35.51、LPIPS 为 0.0139,触觉专用的 UniT VAE 为 31.72 和 0.0210;SSIM 一项则是 UniT 更高(0.9613 对 0.9539)。作者据此认为视觉表征可以迁移到光学触觉,并选用 Wan 的图生视频模型。
画布的排法写在附录里:
- RGB:一个固定底座视角和两个腕部视角,各裁剪缩放到 224 × 224,横向拼成 224 × 672 的条带,10 Hz 记录。
- 触觉图像:Xense 内部相机相对传感器参考的差分图像(400 × 700 × 3),直接放进画布。
- 标记位移:每个触觉垫上 35 × 20 共 700 个标记,以回合第一帧为参考求三维偏移,每个分量截断到 [−s, s](s = 0.06,缓存原生单位,是编码尺度而非物理上限)后归一化,x、y、z 分别映射到 R、G、B。定量统计仍用未编码的位移计算。
- 任务状态:颜色区分任务,纹理(竖向或横向低频条纹)区分“成功条件未满足 / 已满足”。它只是辅助目标,用来教世界模型任务语义,下游策略不使用预测出的状态。
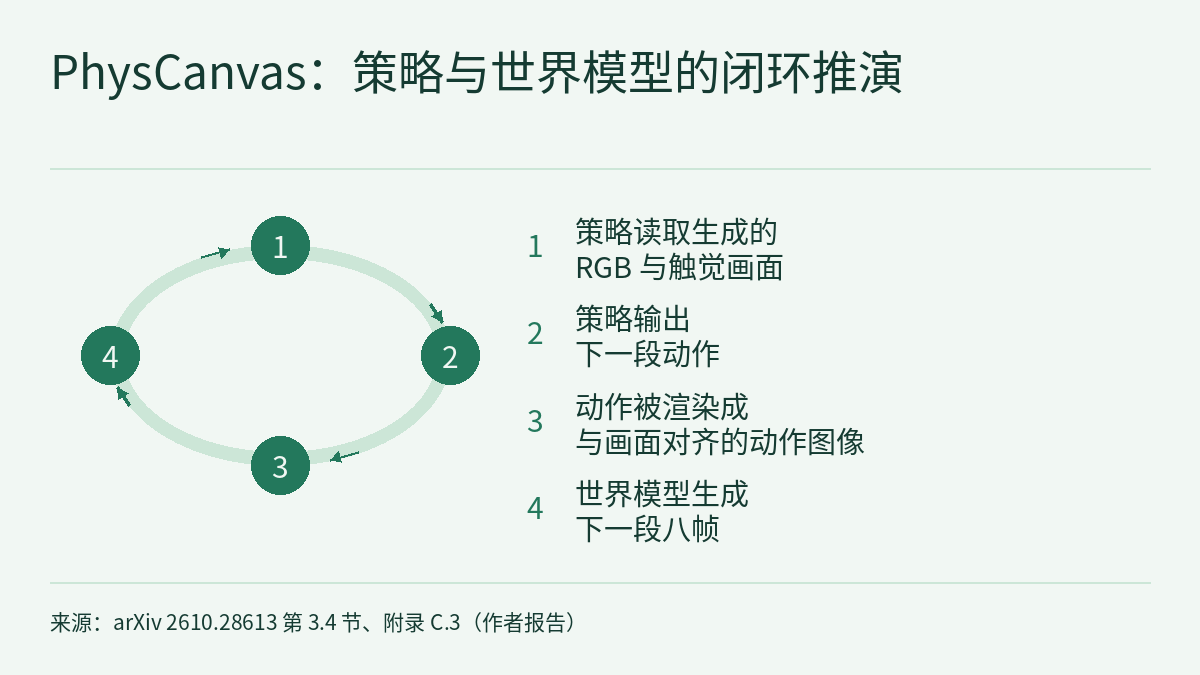
各相机视角横排,各模态纵向堆叠,整张画布交给同一个 VAE 和 Wan 2.2 扩散 Transformer,所有模态共享时空自注意力。动作条件是目标双臂关节位形(含夹爪状态):作者沿用 iMaC 的做法,把关节位形套到机器人 URDF 上做正运动学,再用相机内外参投影到每个视角,得到与画面空间对齐的“动作图像”;它经同一个 VAE 编码后逐位置加到带噪的画布 token 上,任务状态区域除外,迫使状态预测通过自注意力参考其他模态。生成时,回合初始的 RGB 帧作为固定锚点经交叉注意力输入,当前参考 token 则用上一段的最后一帧更新。
训练细节:从 Wan2.2-TI2V-5B(50 亿参数)初始化,冻结 VAE、微调 Transformer,用流匹配目标;每个训练样本递归生成四段、每段八帧,损失在四段上平均,使模型在自己生成的上下文中受训。训练用 64 块 PPU-ZW810E 加速器跑 300 个 epoch,约三天。推理时每段从噪声出发、5 步去噪生成八帧,可以一直续写到整个回合结束。
三个冻结的奖励模型,各管一种一致性
三个奖励模型都是 ResNet-18 编码器加 MLP 或 Transformer 解码器,事先训练好,在后训练世界模型时保持冻结:
- Scene Reward Model:输入回合初始 RGB 和一帧未来 RGB,判断场景身份和物体是否保持。正样本是真实观测和场景一致的生成结果,负样本是场景不一致的生成结果,类别平衡。
- State Reward Model:输入一帧未来 RGB,判断任务的成功条件是否成立。它只用真实轨迹训练:完成前的帧标 0,完成及之后的帧标 1。
- Modality Reward Model:输入成对的 RGB、触觉图像和标记位移区域,判断接触证据是否相容。负样本的做法是保持 RGB 不变,把触觉换成另一种触觉状态,所以它监督的是跨模态是否一致,而不是有没有接触。
状态监督不是把每次预测都推向成功:目标标签来自同一个 State RM 在对应真实帧上的打分(阈值化),生成帧的成功 logit 与之做二元交叉熵,真实轨迹失败时生成也应当失败。场景和模态两项则直接最大化奖励模型给出的分数。梯度穿过冻结的奖励模型和 VAE 解码器回到世界模型,第一阶段的流匹配损失保留。
消融结果并非每项都同向改善。加场景一致性后,RGB 的 LPIPS 降 14.2%、FVD 降 10.4%;再加状态监督,FID 降 26.4%、FVD 降 12.5%,但 PSNR 从 20.975 降到 20.699、LPIPS 从 0.097 升到 0.132;再加模态一致性,接触 MAE 从 0.02491 降到 0.02278,三项标记位移误差都下降,触觉事件 F1 却从 0.4550 略降到 0.4455。作者对图 6、图 7 中“强制张开夹爪后方块下落、触觉响应消失”等示例的说明是:这些是定性展示,不是接触精度的测量。
与 EVAC、Open-Sora、WoVR 的 RGB 对比中,PhysCanvas 在 PSNR、SSIM、LPIPS、FID、FVD 上都最好,末端执行器跟踪误差为 0.685 像素,比次优基线低 51.9%;VBench 的 Subject 和 Smooth 只是小幅领先,背景一致性一项 WoVR 更高(91.082 对 90.565)。
作为评测器:模拟成功率与真机成功率的相关
平台是 ARX AC One 双臂机器人,每臂六个关节加一个夹爪,三台相机,四个 Xense 指尖光学触觉传感器。四项任务都需要双臂协作:试管交接、借桌面在手内调整朝向后插入试管架;拆开两块拼接积木并分别放进同色袋子;一手稳住瓶子、一手拧下瓶盖;把只拧乱一个面的魔方复原。世界模型的训练数据是 3,805 条真机策略执行(四项任务分别为 1,000、1,000、926、879 条),来自对任务策略的随机化执行,包含抓空、过早松手、交接不准、错位、插入或放置未完成等自然失败;每项任务另留 80 条测试执行。
评测时,从真实初始观测出发,策略读取世界模型生成的观测、给出下一段动作,世界模型返回预测的视觉、触觉和任务状态,如此闭环推演。被评测的是 ACT、流匹配策略(FM)和 π0.5,都以 RGB、机器人状态和触觉标记位移为输入。每个“任务-策略”组合有三批、每批 20 个场景,三批在不同时间采集;真机场景是否成功由多位人类专家共同判断。于是每项任务有九个批次点(三种策略 × 三批),每个点比较世界模型中的成功率与真机成功率,先在每项任务内算 Pearson 相关,再对四项任务等权平均。
从只有场景一致性的 ℳ2 到加了状态监督的 ℳ3,平均相关从 0.602 升到 0.885,平均 R² 从 0.413 升到 0.791。提升最大的是试管和积木,瓶盖次之,魔方几乎不变,作者称 ℳ2 在魔方上已接近上限。由于同一步改动带来的低层重建指标有升有降,作者认为评测一致性的提升来自更好的任务语义建模,而不是像素重建更好。
本站介绍过的 Token-World 也用模拟成功率与参考成功率的相关系数来衡量一个世界模型能否当评测器;两篇的任务、策略、批次划分和相关系数的计算方式都不同,0.885 和那篇的数字不能直接比较。前沿雷达专题|仿真与评测整理过“策略导向的仿真保真度”这类问题;PhysCanvas 给出的是一种可以对照真机检查的做法。还要注意,每项任务的相关系数只基于九个点(论文称每项任务含九个评测批次)。
作为训练场:GRPO 之后的真机成功率
后训练时,策略从真实初始观测出发,在世界模型里做想象中的闭环交互,由冻结的 State RM 给任务结果打分,GRPO(组相对策略优化)把这些结果之间的差别转成学习信号;世界模型和奖励模型都不更新,只更新策略,不再采集新的机器人轨迹。参与后训练的是 FM 和 π0.5;ACT 不采用作者 GRPO 实现所假设的扩散或流匹配形式,因此没有做。
注意这里的对照与上一节不同:“RL in WM”用只有空间对齐动作注入、没有任何一致性监督的 ℳ1 作模拟器,“RL in WM+RM”用三项一致性后训练齐全的 ℳ4,两者都用冻结的 State RM 打分。真机成功率为三次运行的均值 ± 总体标准差:
| π0.5 | 试管 | 瓶盖 | 积木 | 魔方 | 四项平均 |
|---|---|---|---|---|---|
| SFT | 50.0 ± 7.0 | 88.3 ± 4.7 | 46.6 ± 2.3 | 51.6 ± 6.2 | 59.1 |
| RL in WM(ℳ1) | 60.0 ± 4.0 | 90.0 ± 0.0 | 56.6 ± 4.7 | 63.3 ± 4.7 | 67.5 |
| RL in WM+RM(ℳ4) | 60.0 ± 8.1 | 86.6 ± 2.3 | 63.3 ± 4.7 | 73.3 ± 4.7 | 70.8 |
FM 的四项平均从 11.2% 升到 16.6%(ℳ1)和 19.1%(ℳ4),提升只出现在瓶盖和积木上,试管和魔方始终为 0。π0.5 在 ℳ4 中相对 ℳ1 的额外提升主要在积木和魔方(6.6 和 10.0 个百分点;积木的 6.6 是作者给出的数字,按表中数值相减为 6.7),瓶盖则从 90.0% 降到 86.6%,按表中数字也低于 SFT 的 88.3%(本站对照)。作者的结论是平均真机成功率提高了,但收益因任务而异。
用学到的奖励在生成的环境里优化策略,物理AI实验室 1.7:强化学习讲过的“奖励被钻空子”就是需要盯住的风险;这篇的检验办法是最后回到真机评测。物理AI实验室 1.8:评测练过怎样判断几个百分点的差别是否站得住:表中多组差值与标准差同一量级(例如试管 50.0 ± 7.0 对 60.0 ± 8.1),所读正文没有报告显著性检验。
局限 / 注意
- 这是 arXiv 预印本,全部数字为作者报告 [R],本站没有复现。本站读到的正文止于附录 D.3(策略结构),未读到其后的附录;所读文本给出了项目页地址,但没有说明代码、数据或权重是否发布,本站也没有打开项目页。
- 评测器的结论(0.602→0.885)比较的是 ℳ2 与 ℳ3;后训练的结论(59.1%→67.5%→70.8%)比较的是 ℳ1 与 ℳ4。两组数字出自不同的模型变体,不能合并成“一致性监督带来多少”的单一结论。
- 只有一个双臂平台、四项任务、三种策略;每项任务的相关系数基于九个批次点。π0.5 在瓶盖任务上的后训练结果低于 SFT;FM 在两项任务上始终为 0。
- State RM 既为世界模型提供状态监督,又在 GRPO 中给策略打分,它本身是只用真实轨迹 RGB 训练的二分类器;所读正文没有单独报告它的判别准确率。
- Wan VAE 与 UniT VAE 的触觉重建对比只在一个公开触觉数据集上做,SSIM 一项 UniT 更高。图 6、图 7 的示例按作者说明是定性展示,不是接触精度测量。
- 世界模型的预测和真机成功率都不是硬件安全验证;论文没有把这套方法作为安全评估。
链接
- Physical Canvas: A Vision Tactile World Model for Robot Policy Evaluation and Learning(arXiv 2610.28613)
- 论文 HTML 全文
- 前沿雷达|Token-World:在 VLM token 空间里推演世界模型,不经 RGB 重建来模拟 VLA 策略
- 前沿雷达专题|仿真与评测:VLA 评测在初始状态成功率之外缺了什么
- 物理AI实验室 1.3:传感器,用一只杯子手算像素、深度量程与夹紧力
- 物理AI实验室 1.4:仿真器地图,手算步长代价、找出接触分叉点,再给三个提速数字标清基线
- 物理AI实验室 1.7:强化学习,手算一局回报看奖励怎样被钻空子,再读论文里的地形课程与超时重置
- 物理AI实验室 1.8:评测,把“净增 2”拆成配对表,再给失败标签和随机种子算一笔账
- 物理AI实验室:一套每个数字都能核对的物理 AI 课程(课程大纲)