基于 flow matching 的 VLA 从高斯噪声采样动作块:同一观测、同一指令,换一个噪声种子,得到的动作块质量可能不同,但部署时策略通常只取一个样本就执行。香港大学团队的预印本 VeriVLA(arXiv 2610.21985,2026-10-15)把这种随机性当作可以挑选的资源:先用两个初始样本算出一个免训练的“两轴”触发分数,判断当前是不是值得多算的关键状态;触发后再补采 8 个、共 10 个候选,由一个基于 JEPA 的潜世界模型预测每个候选执行后的未来潜状态和任务进度增量,执行预测进度最大的那个。作者报告,真机三项任务的平均完成度分数从 50.8% 升到 65.5%,每次触发的决策在单块 RTX 4090 上多花 326 ms;仿真中 RoboTwin 2.0 和 LIBERO 也有提升,但 RoboTwin 2.0 的主表用的是常开验证,不是触发模式。以下数字均为作者报告 [R],本站未复现。
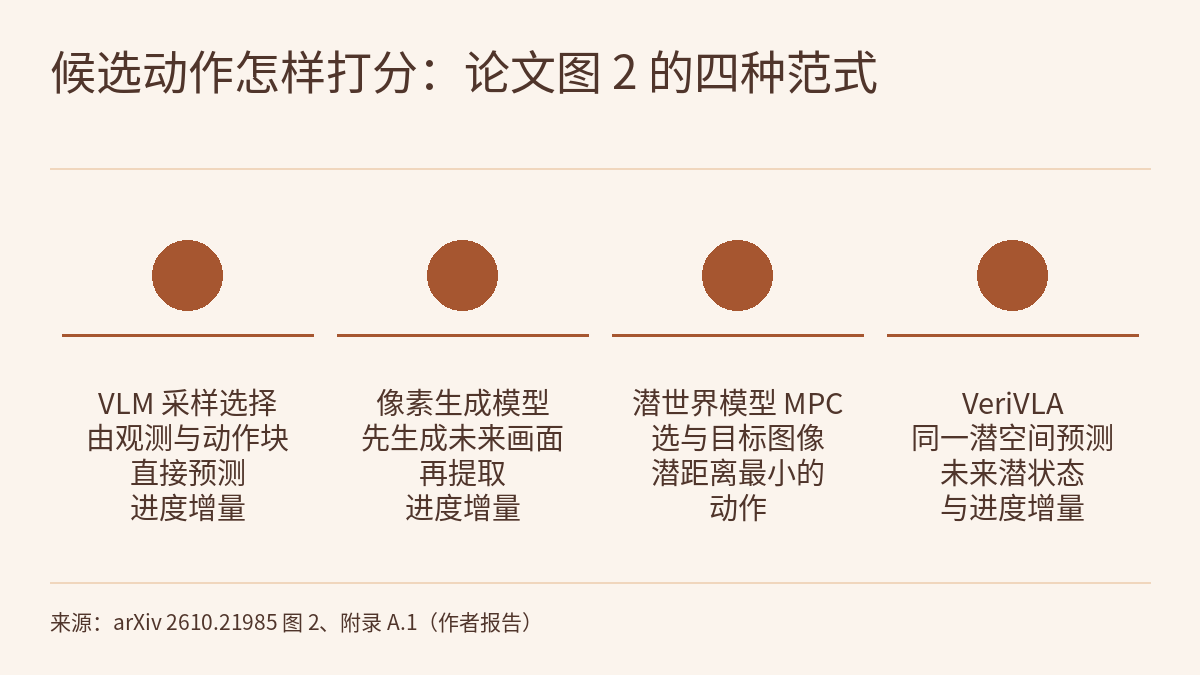
论文图 2、附录表 6 和相关工作部分(§2、§3.4)把同类做法分成几种。RoboMonkey 在合成的动作偏好上微调一个 7B VLM,由当前观测和动作块直接给出评分;GPC-RANK 和 DreamAvoid 先生成未来的像素画面,再从中提取奖励或进度,是两段式的;DINO-WM、V-JEPA 2-AC 这类潜世界模型用搜索做规划,需要一张目标图像。VeriVLA 保留世界模型,但在同一个潜空间里一步给出未来潜状态和进度增量,不重建像素,也不需要目标图像。作者的理由是:判断一个动作块推进了多少是一个标量问题,画面中大部分像素与它无关;像素级世界模型生成慢,而且要先解决更难的画面生成,再做更容易的进度估计,验证质量因此受生成质量牵连。
何时值得多算:两个样本、两条轴
作者观察到,策略方差沿任务并不均匀:在 LIBERO 中重复采样,末端执行器靠近接触密集区域时动作方差更高,失败也多发生在这些高方差段(论文图 1)。据此,触发器要满足两个条件:在接触密集、操作更复杂的区域启动(C1);在重复采样能产生多样候选、验证器有得可选的状态启动(C2)。
每个决策步先从策略采 k = 2 个动作块。为了不偏向快速运动的阶段,每个动作块先除以自身的平均动作幅值做归一化。之后从两条轴计算:
- 时间轴(对应 C1):每个动作块内相邻两步动作之差的平方均值,再对 k 个样本取平均,记作 T_temp。
- 样本轴(对应 C2):各样本在每一步上偏离 k 个样本均值的平方均值,记作 T_cross;作者称其思路来自 AdaFlow 的方差自适应计算。
部署到新环境前,先用基础策略跑少量回合,在每个时间步计算 T_temp 和 T_cross,得到两个经验参考分布。运行时把两个值换成各自分布里的百分位,取较大者 τ = max(τ_temp, τ_cross),超过阈值 τ0 就触发,相当于“任一条轴超标即触发”。τ0 是触发器唯一的超参数。不触发时不再额外采样,直接执行第一个样本。
作者在仿真里用两个诊断指标评估触发器。Status AUC 衡量触发分数与“关键时刻”标签的一致程度:标签只依据仿真器的特权状态,在夹爪与物体、物体与物体的接触状态翻转时刻放置高斯核,叠加后截断到 1,再以 0.5 为界二值化,不使用触发器所用的画面或动作。Variance Correlation 是触发分数与每个状态下 K 个样本估出的参考方差之间的 Spearman ρ。附录写明,DINO 基线与其他方法一起在 LIBERO-Plus 的扰动集上评估。
| 触发方法 | Status AUC | Variance Correlation | 样本数 k / 额外延迟(ms) |
|---|---|---|---|
| 随机 | 0.487 | – | – |
| DINOv2 特征 + MLP(需训练) | 0.702 | 0.630 | 0 / 0 |
| 动作块熵 ACE | 0.588 | 0.716 | 2 / 14 |
| 只用 T_temp | 0.704 | 0.789 | 1 / 0 |
| 只用 T_cross | 0.694 | 0.877 | 2 / 14 |
| 两轴触发器 | 0.727 | 0.887 | 2 / 14 |
时间分量的 Status AUC 更高,样本分量的方差相关更高,作者据此认为两者互补;合并后两项都略高于任一分量。这两个指标衡量的是触发分数与接触时刻、策略方差的一致程度,不是闭环成功率;闭环的成功率与计算量权衡在论文图 6 中另行评估。真机实验中,作者把阈值设在“接触密集阶段开启验证”的水平,具体阈值和各任务的触发率只出现在图 5b 中,本站所读的正文没有给出数值。
怎样打分:在潜空间里预测一块动作推进了多少
论文把一个动作块的质量定义为执行它前后的任务进度之差,即 delta progress(进度增量)Δp = p_{t+H} − p_t。作者认为,与绝对进度相比,增量直接对应这一块动作的效果。
验证器建立在 JEPA 世界模型框架上:视觉编码器是冻结的预训练 V-JEPA 2,把当前观测压成潜表示;动作条件的自回归预测器在 DROID 数据集的 23k 条轨迹上预训练过,负责预测潜状态在动作作用下怎样演化。为适配具体机器人,作者为每种本体加了状态编码器和动作编码器,并把长度为 H 的动作块均分成 M 个子块逐段推演(真机实验的超参数表中 M = 5)。
在此之上加一条进度预测分支。同样的状态变化,对“关上柜门”是正进度,对“打开柜门”是负进度,所以进度预测需要任务信息:作者为每个任务设一个可学习的查询 token,预测器对每个子块先预测下一个潜状态,再预测对应的进度增量。注意力掩码禁止潜状态预测看到这个任务 token,以免任务语义渗进动态模型,让潜动态保持与任务无关。
训练时以进度估计为主目标:在每个子块上,Huber 回归损失拟合进度目标,同任务样本对之间的成对排序损失保持先后顺序(排序损失沿用 DreamAvoid),再加上按 V-JEPA 2-AC 定义的潜状态 L1 预测损失;训练中同时使用 teacher forcing 和 self-forcing。绝对进度由 Robometer 自动标注,再由此算出增量。数据方面,每个真机任务用 50 段示范微调基础策略 π0.5,另采 50 段策略回放并用 Robometer 标注;同一环境的全部任务共用一个验证器,在单块 H800 上训练,仿真实验采用同样的流程。
推理时,预测器只以自己预测出的潜帧为条件,在每个候选的 M 个子块上自回归推演,得到 M 个进度增量;求和后,执行累计预测进度最大的候选。为了能在真机上跑,作者叠加了三项延迟优化:在自回归推演中复用 KV cache;把彼此独立的计算重叠起来,例如并行生成候选动作块、在 VLA 生成动作的同时做潜特征编码;PyTorch 层面的预编译等优化。图 5a 显示 KV cache 带来的延迟降幅最大,正文没有给出各阶段的具体数字。
结果:真机三项任务与两个仿真基准
真机实验用 AgileX PiperX 双臂机器人,配一个前置 RealSense D455 和两个腕部 RealSense D435。三项任务分别是插笔(拿起笔插进酸奶瓶)、移液(用移液管把液体从右边的瓶子移到左边)和放苹果(拿起苹果放进容器),其中一项单臂、两项双臂。每种方法每个任务 50 次,触发用 k = 2,验证用 K = 10。完成度分数按阶段计分:插笔和放苹果各分两个阶段、各 0.5 分,放苹果若需多次尝试才放进去,该阶段只得 0.25 分;移液分四个阶段、各 0.25 分。
| 方法 | Rank 损失 ↓ | Huber 损失 ↓ | 插笔(%) | 移液(%) | 放苹果(%) | 平均(%) |
|---|---|---|---|---|---|---|
| π0.5(单次采样) | – | – | 45.0 | 52.5 | 55.0 | 50.8 |
| + RoboMonkey(VLM 验证器) | 1.19 | 0.37 | 49.0 | 55.5 | 63.5 | 56.0 |
| + GPC-RANK(像素级世界模型验证器) | 1.18 | 0.30 | 46.0 | 54.5 | 58.0 | 52.8 |
| + VeriVLA | 1.09 | 0.25 | 60.0 | 63.5 | 73.0 | 65.5 |
两项损失是验证集上的离线指标:Rank 损失衡量同一任务内给样本排序的能力,Huber 损失衡量进度增量的回归精度;完成度分数是闭环结果。RoboMonkey 基线的训练目标改成了进度增量估计。作者对基线差距的解释是:RoboMonkey 在只需粗定位的任务(如放苹果)上有竞争力,但在精细操作上吃力,“可能”因为它的 VLM 缺少对世界动态的显式理解;GPC-RANK 用真实观测估计进度时表现不错,换成测试时生成的推演画面就变差,说明生成质量成了瓶颈。本站所读的正文没有说明基线是否使用同一个触发器和同样的候选数,也没有给出置信区间。
消融(表 4)在同样三项真机任务上进行,视觉编码器在所有变体中都是预训练的。去掉潜状态预测目标、只预测进度增量,平均完成度从 65.5% 降到 55.2%(插笔 52.0、移液 55.5、放苹果 58.0),略低于 RoboMonkey 基线的 56.0%;预测器改为随机初始化、不用 DROID 预训练,平均降到 59.5%(54.0、61.0、63.5)。作者指出,泛化要求更高的放苹果下降最多,瓶子位置几乎固定的移液下降较小。
仿真部分,每种方法每个任务同样跑 50 次。RoboTwin 2.0 用 Hy-Embodied-0.5-VLA 作基础策略,选了五个基线成功率较低的精细任务;表 2 的两组结果都是常开验证,Clean2Random 设置中策略和验证器只在干净数据上训练、在随机化环境中评测。LIBERO 用 π0.5 和 StarVLA-GR00T 两个基础策略,覆盖 40 个任务,每个基础策略有自己的验证器权重,在 40 个任务间共用;本站所读的正文没有写明 LIBERO 结果用的是触发还是常开验证。
| 基准(基础策略) | 基线(%) | + RoboMonkey(%) | + GPC-RANK(%) | + VeriVLA(%) |
|---|---|---|---|---|
| RoboTwin 2.0 Clean 五任务平均(Hy-VLA) | 66.4 | 65.2 | 68.8 | 73.6 |
| RoboTwin 2.0 Clean2Random 五任务平均(Hy-VLA) | 62.8 | 64.8 | 64.8 | 69.6 |
| LIBERO 四个套件平均(π0.5) | 96.9 | 97.3 | 95.3 | 97.6 |
| LIBERO-10(π0.5) | 92.4 | 94.0 | 89.0 | 94.0 |
| LIBERO 四个套件平均(StarVLA-GR00T) | 96.2 | 96.3 | 96.7 | 97.2 |
| LIBERO-10(StarVLA-GR00T) | 91.0 | 91.6 | 92.4 | 93.6 |
RoboTwin 2.0 每个任务 50 次时,一次试验对应 2 个百分点;五任务共 250 次,Clean 的 7.2 个百分点约相当于多成功 18 次,Clean2Random 的 6.8 个百分点约相当于多成功 17 次(本站换算)。逐任务看,VeriVLA 并非处处领先:Clean2Random 的 Seal 任务上它是 78%,GPC-RANK 是 80%;Clean 设置下 RoboMonkey 的平均值低于基础策略。LIBERO 的提升主要在尚未饱和的 LIBERO-10,π0.5 上 VeriVLA 与 RoboMonkey 同为 94.0%。触发模式在仿真中的效果见图 6:在 Clean 设置下为全部任务调整一个统一阈值,使大约 r 比例的决策步触发验证;作者称常开验证在五个任务上都提高了成功率,触发器能在前四个任务上保留大部分提升、同时减少计算;图中的具体数值没有出现在本站所读的正文里。
延迟与显存:326 ms 包括什么
附录表 9 给出真机部署的分项,策略和验证器在同一块 RTX 4090 上运行:
| 组成 | 延迟(ms) |
|---|---|
| VLA 策略 | 82 |
| 两轴触发器(k = 2) | 14 |
| 补采样(K − k = 8 个候选) | 80 |
| 验证器前向(全部 K = 10 个候选) | 246 |
| 未触发的决策合计 | 96 |
| 触发的决策合计 | 422 |
| 仅验证带来的额外延迟 | 326 |
326 ms 是补采样与验证器前向之和(80 + 246),不含 14 ms 的触发器;未触发时一次决策是 82 + 14 = 96 ms,触发时是 422 ms(本站核算)。显存方面,VLA 策略占 9.8 GB,验证器前向(10 个候选)占 8.7 GB,合计 18.5 GB。每个动作块平均多出的延迟取决于触发率,只画在图 5b 中。本站所读的正文没有说明触发决策的这段计算期间机器人是否等待,也没有说明它与动作块执行怎样重叠。
和站内已有内容的关系
物理AI实验室 1.6:模仿学习讲过,扩散策略的长处是能学到“同一场景有好几种正确做法”的多峰动作分布,而不是把左绕、右绕平均成一次碰撞。VeriVLA 关注的是这种随机性在部署时的另一面:每次只执行一个样本,抽到的样本可能是差的;它在关键时刻多抽几个,再挑一个。1.6 讲的误差累积也是这篇论文的出发点之一:一个差的动作块可能直接导致失败,或者让轨迹漂出分布。
两篇近期的雷达与它各有一部分重叠。前沿雷达|RESETTLE同样从冻结策略的两次采样判断何时介入,但它在两次采样持续分歧时才介入,触发后检索同任务示范、只执行一个纠正动作;VeriVLA 用块内时间变化和跨样本方差两条轴、任一超标即触发,触发后从 10 个候选里挑一个。前沿雷达|LiteNWM也在潜空间里给候选打分、不为每个候选生成 RGB 画面,不过对象是导航轨迹,而 VeriVLA 预测的是操作任务的进度增量。三篇论文的基准、基础策略和硬件都不同,彼此没有直接比较,不能按数字排先后。
读 VeriVLA 的数字时,可以对照物理AI实验室 1.8:评测的问法:真机平均是三项任务完成度分数的平均,完成度含部分得分;每任务 50 次,正文没有给出逐次的变好、变坏数,也没有置信区间;仿真主表是常开验证,“自适应”带来的计算节省只在图中给出。
局限 / 注意
- 这是 arXiv 预印本,全部数字为作者报告 [R],作者均来自香港大学。本站没有复现任何结果。
- 参考文献 [11](DreamAvoid)的作者署名为 X. Fan、Y. Lu、… H. Zhao,与本文三位作者的姓名缩写相同;论文没有说明他们是否为同一批人。本文排序损失的样本对构造沿用 DreamAvoid,触发器对比中的 DINOv2 + MLP 基线代表的是 DreamAvoid 一类的视觉触发(附录 C.3)。DreamAvoid 本身没有出现在表 1–3 的闭环对比里。
- 进度标签由 Robometer 自动生成,验证器学习的是这个奖励模型给出的进度;本站所读的正文没有报告这些标签与人工判断的一致程度。
- RoboTwin 2.0 的主结果是常开验证;触发模式下的成功率与计算量权衡(图 6)和真机触发率(图 5b)只以图形给出。触发器诊断(表 5)依赖仿真器的特权接触状态,这类标签在真机上无法直接获得。
- 真机只有三项任务、每任务 50 次,完成度分数含部分得分,没有置信区间;326 ms 只在一块 RTX 4090、π0.5 和 K = 10 的配置下测得。
- 作者写明的局限:验证器只能在策略给出的候选中挑选,不同随机种子带来的多样性仍然有限;视觉编码器是冻结的,它的表示没有专门为进度估计优化,可能漏掉物体构型、接触状态或任务完成上的细微变化。
- 验证器挑选的目标是预测进度,不是碰撞或力的约束。仿真结果和真机试验都不是硬件安全验证。
链接
- VeriVLA: Adaptive Test-Time Verification for Flow-Based VLAs with Latent World Models(arXiv 2610.21985)
- 论文 HTML 全文
- 物理AI实验室 1.6:模仿学习,手算误差怎样滚出示范覆盖范围,再把 ACT、扩散策略与数据规模律的数字放回各自条件
- 物理AI实验室 1.8:评测,把“净增 2”拆成配对表,再给失败标签和随机种子算一笔账
- 前沿雷达|RESETTLE:冻结策略的两次采样持续分歧才介入,按示范参考只执行一个纠正动作
- 前沿雷达|LiteNWM:编码一次,在潜空间联合预测 16 条候选与现行轨迹的后果,导航世界模型不再逐条生成 RGB 画面
- 物理AI实验室:一套每个数字都能核对的物理 AI 课程(课程大纲)