从第一视角人类视频学灵巧操作,常见做法是先把人的手腕和手指姿态按几何规则重定向成某台机器人的动作,再拿去预训练。预印本 EgoJEPA(arXiv 2610.20904,2026-10-14)不做这一步:它把相邻帧手部标注的差值当作条件,用 JEPA 式的视觉预测学一个与机器人本体无关的潜动作空间,在人类视频上训练世界动作模型,换机器人时在动作分支新增一对适配器,并用机器人示范做第三阶段微调。作者报告,在三种本体的五项真机任务上,分布外平均成功率 74%,同架构的重定向基线为 65%;五项任务累计的跨本体墙钟时间从 743.2 小时降到 392.7 小时(减少 47.2%)。这篇论文值得细读的是两笔账:重定向的代价具体花在哪里,以及这些提升各自建立在多少次试验上。以下数字均为作者报告 [R],本站未复现。
重定向的两笔代价
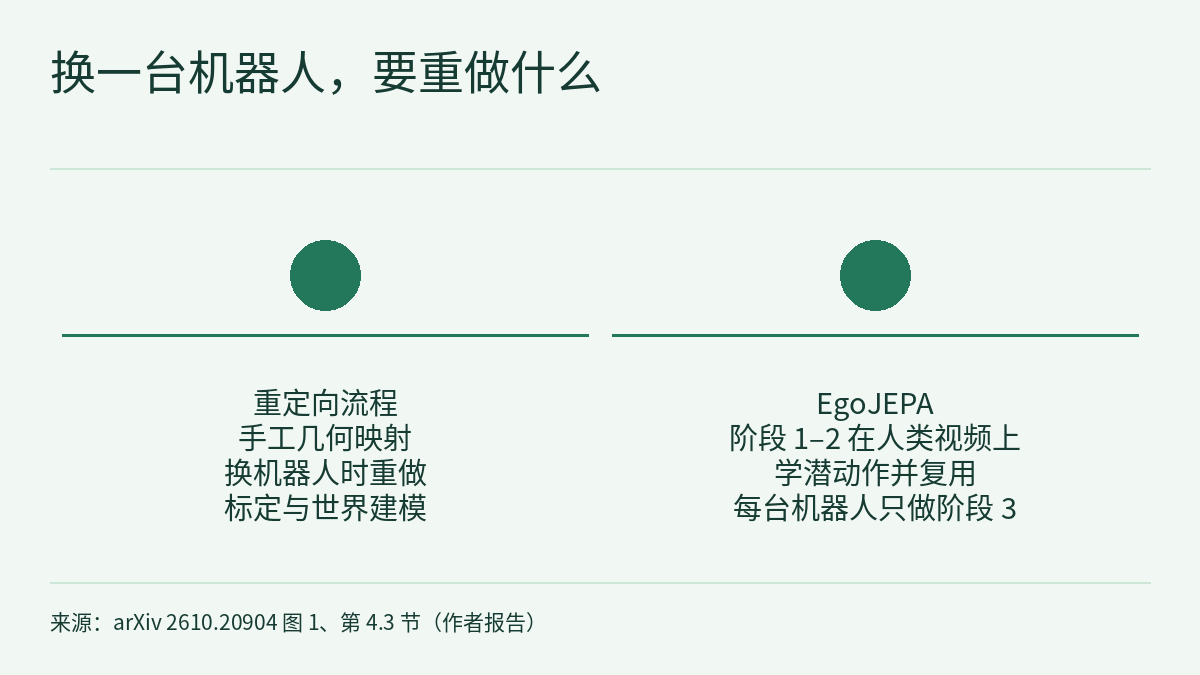
作者把重定向流程的问题归为两点。第一是映射绑定本体:手工的几何或运动学映射针对某一种机器人形态,形态一变就要重新标定。论文图 1(a) 中,仅人–机标定一项就用了 52.1 小时,占整条流程时间的 25.2%;所读正文没有写明这是哪一项任务的流程。第二是噪声直接传下去:手部姿态估计受遮挡、视角和时间抖动影响,误差会经重定向变成物理上不可行的机器人动作。作者做了一个压力测试:只在人类动作标注上加每轴 σ = 10 mm 的高斯位置噪声、机器人训练不变,重定向流程在拧瓶盖任务上的成功率从 60% 降到 30%。
另一条路线是不用手部标注、直接从帧间视觉变化学潜动作(论文的对照 LAPA 属于这一类)。作者认为这类潜变量可能把可控的手部运动与相机运动、被动的场景变化混在一起。EgoJEPA 的位置在两者之间:用显式的手部运动作监督,但不把它映射到任何一台机器人的坐标上。
论文在相关工作里把 EgoScale、EgoMimic、DexWild 等方法归入重定向一类,并提到同期的 Being-H0 用 VQ-VAE 把 MANO 轨迹离散成动作 token;作者的批评是后者的 tokenizer 只看手部姿态序列,不看视觉上下文。
三个阶段:从手部动作差分到每台机器人的适配器
- 阶段 1,人类动作预训练:“人类动作”定义为相邻帧手部标注之差,标注可以是 2D/3D 关键点、MANO 参数或其他手部姿态表示;取一个时间窗 H 内的差值序列。动作编码器把这段差值编成潜动作,预测器结合前面各帧的视觉编码,预测第 t+H 帧的目标表示;目标编码器是在线编码器的指数滑动平均,目标分支不回传梯度,损失为 L1。作者称这样学到的潜动作是“效果感知”的,因为它必须解释手的运动在画面上造成了什么变化。
- 阶段 2,基于潜动作的世界建模:冻结阶段 1 的动作编码器,用它给人类视频产生潜动作标签;世界动作模型在语言指令条件下,以联合 flow matching 同时预测未来视觉表示与潜动作。动作分支的监督来自这些潜动作,而不是重定向得到的坐标级机器人动作。
- 阶段 3,本体特定微调:从阶段 2 初始化,在动作分支插入输入、输出两个适配器(各为两层 MLP,中间 ReLU),分别把机器人动作 token 映射进共享动作空间、把输出映射回目标机器人的动作空间。机器人动作也写成相邻时刻的差值,以对齐阶段 1 的相对手部运动;视觉编码器保持不变。
实现上,阶段 1 的视觉编码器从 Wan2.2 VAE 编码器初始化,预测器是 24 层帧因果 Transformer;阶段 2 的视频 Transformer 从 Wan2.2-TI2V-5B 初始化,潜动作沿特征维平均池化成 128 维(阶段 1 为 1024 维)。附录表 A3 有一个容易忽略的细节:阶段 3 的可训练模块是视频 DiT、动作 DiT 加适配器,并不只是适配器;三个阶段分别用 32、64、64 块 GPU,训练 3,500、6,000、3,000 步;阶段 1–2 用单路相机、无本体感觉,阶段 3 用三路相机并加入本体感觉条件。所以“轻量适配器”说的是每台机器人新增的模块,不是每台机器人只需训练的部分。
评测设置与主结果
人类数据:一个商业采购的第一视角数据集,1,111,943 段、62,518 次录制,约 20,106.6 小时、21.7 亿帧,64,686 条任务指令、608 个场景标签;单目 RGB,约 30 Hz,带手腕位姿和每只手 21 个三维关键点。附录说明其授权用于非商业学术研究。
机器人任务:Sharpa 灵巧手抓毛绒玩具(动作 56 维,750 段示范);Wuji 灵巧手叠杯子(52 维,916 段)、拉拉链(623 段)、拧瓶盖(635 段);Xense Tac UMI 夹爪折纸盒(14 维,843 段,平均每段 297.6 秒)。每项任务在分布内和分布外各测 20 次,成功定义为完整完成任务;分布外包括没见过的物体实例和训练分布之外的摆放位置与朝向。
对照:LAPA(无动作标注的潜动作方法);DexWild(人类视频与机器人示范共训);重定向流程(与 EgoJEPA 同架构,只把潜动作换成几何重定向得到的机器人目标,Sharpa、Wuji 用官方重定向 SDK,夹爪用拇指–食指指尖距离映射开合);仅用机器人数据的消融;把阶段 1 换成 VQ-VAE 重建手部运动的变体。重定向基线与 EgoJEPA 共享架构,因此主要差别在动作接口这一项。
| 方法 | 分布内平均 | 分布外平均 |
|---|---|---|
| EgoJEPA | 94% | 74% |
| 重定向流程 | 80%(本站由“高 14 个百分点”推算) | 65% |
| EgoJEPA(VQ-VAE 阶段 1) | 所读正文未给出 | 63% |
| DexWild | 所读正文未给出 | 40% |
| EgoJEPA(仅机器人数据) | 所读正文未给出 | 40% |
作者报告 EgoJEPA 在五项任务上都是最高;LAPA 的平均值在所读正文里没有写出。分布外成功率最低的两项是拧瓶盖和折纸盒,作者的解释是前者要双手协调稳住瓶身再旋转,后者是多步且几何对齐要求严格的操作。去掉人类预训练后,分布外平均从 74% 降到 40%,拧瓶盖从 70% 降到 30%;把 JEPA 预测换成 VQ-VAE 重建,分布外平均从 74% 降到 63%,作者据此认为学习“手的运动造成了什么视觉后果”比只重建运动本身更有用。
分母需要记住:每项任务每种设置 20 次,一个任务上 5 个百分点就是 1 次试验。五项任务等权平均时,74% 与 65% 的差相当于 100 次分布外试验中多成功 9 次(本站换算)。主结果没有报告置信区间或显著性检验。
噪声与跨本体时间:两笔账怎么读
机器人数据效率(拧瓶盖,分布外):只用 10% 的机器人示范,EgoJEPA 成功率 35%,高于用全部示范的仅机器人模型(30%);用 50% 示范为 65%,高于用全部示范的重定向基线(60%)。论文图 5 用阴影标出 20 次试验的 95% 威尔逊区间。按 20 次换算,35% 对 30% 是 7 次对 6 次,65% 对 60% 是 13 次对 12 次,各差 1 次;本站按威尔逊公式估算,7/20 的区间约 18%–57%,6/20 约 15%–52%,大幅重叠。“各数据量下都更好”在点估计上成立,单看这几组比较不足以区分。
标注噪声:只在阶段 1–2 的人类标注上加扰动,阶段 3 用干净的机器人数据,在拧瓶盖分布外设置下评测。位置噪声 σ 取 0、2、5、10 mm;时间抖动最大偏移 0、3、6、12 帧(30 Hz 下约 0、100、200、400 ms);标注缺失比例 0%、10%、20%、40%(缺失段线性插值,旋转用球面插值)。σ = 10 mm 时,EgoJEPA 从 70% 降到 60%(14/20 → 12/20),重定向从 60% 降到 30%(12/20 → 6/20)。三类扰动中时间抖动影响最大,EgoJEPA 在 12 帧偏移下为 50%;缺失影响最小,40% 缺失下为 65%。
跨本体时间:作者报告的是墙钟时间而不是 GPU 小时,理由是重定向基线的人–机标定完全在 CPU 上运行。以夹爪折纸盒为例,EgoJEPA 的阶段 3 用 37.5 小时,重定向流程用 193.4 小时,其中 CPU 标定 46.7 小时、GPU 世界建模 109.2 小时。本站相减,重定向剩下的部分也是 37.5 小时,与 EgoJEPA 的阶段 3 相同;论文没有标明这部分是什么,但按这组数字,节省来自每次换本体时不再重做标定和世界建模。五项任务累计从 743.2 小时降到 392.7 小时,(743.2 − 392.7) / 743.2 ≈ 47.2%,与论文一致。
读这个 47.2% 时要注意三点。其一,墙钟时间不等于计算量:阶段 3 用 64 块 GPU,标定用 CPU,两者的小时数相加不代表同一种资源。其二,所读正文没有写明 392.7 小时是否计入阶段 1–2 的一次性预训练。其三,论文说重定向在“引入新本体时”要重做标定和世界建模,而图 7 按任务列出时间;三项 Wuji 任务是否共用一次标定,所读正文没有说明。
和站内已有内容的关系
物理AI实验室 1.5:数据从哪来讲过人类视频的难处:人手不是机器手,得先把人手“翻译”成机器手。EgoJEPA 的回答是不做显式翻译,把翻译推迟到每台机器人的阶段 3,由机器人示范去学;它仍然需要逐帧手部标注,每项任务也仍用了 600 多到 900 多段机器人示范。
物理AI实验室 0.2:为什么是现在引用过 EgoScale 的 20,854 小时第一视角视频;EgoJEPA 论文把 EgoScale 归入重定向路线。EgoJEPA 自己用的约 20,106.6 小时是另一个商业数据集,两组小时数属于不同数据,不能互相比较。
前沿雷达|DexStitch走的是相反的路:用接触引导的修补,把人类视频显式转换成灵巧手数据。同日的 TDV 用手或物体的位姿轨迹作中间表示,Being-M0.7 则把人类视频与动作数据接到人形机器人的全身控制。这几篇论文的机器人、任务和指标都不同,成功率不能横向比较;它们的差别在于人类数据和机器人动作之间放了什么接口。
物理AI实验室 1.8:评测练过先问分母和条件。本文的每一个百分数都应连同“20 次、哪项任务、分布内还是分布外”一起转述。
局限 / 注意
- 这是 arXiv 预印本,全部数字为作者报告 [R],本站没有复现。论文首页列了一个项目页地址,本站没有打开核实,文中不链接;所读文本中没有代码发布信息。
- 阶段 1–2 的人类数据是商业授权数据集,附录写明授权用于非商业学术研究;所读文本没有说明是否公开,外部很难用同一数据重做预训练。
- 每项任务每种设置只有 20 次试验,主结果没有置信区间或显著性检验;数据效率和噪声鲁棒性实验只在拧瓶盖一项任务上做。
- “轻量适配器”之外,阶段 3 仍微调视频与动作 DiT,并改用三路相机和本体感觉;每项任务用了 623–916 段机器人示范。
- 跨本体节省按墙钟时间统计,混合了 CPU 标定和 64 卡 GPU 训练;是否计入阶段 1–2 一次性成本,所读正文没有写明。
- 作者自己列出的局限:标注严重退化(严重时间错位、长时间遮挡)仍会扭曲潜表示;需要精细接触动力学的分布外任务(如拧瓶盖)表现下降,作者把引入显式交互建模或力反馈先验列为后续方向。
- 论文的影响声明提到,真机部署需要建立安全与物理隔离规程;本文的结果不构成硬件安全验证。
链接
- EgoJEPA: Beyond Retargeting for Dexterous Manipulation from Egocentric Videos(arXiv 2610.20904)
- 论文 HTML 全文
- 物理AI实验室 1.5:数据从哪来,从 SO-101 元数据算出示范时长,再分清三条来路的单位与动作空间
- 物理AI实验室 0.2:为什么是现在,数据、模型、算力三条曲线
- 物理AI实验室 1.8:评测,把“净增 2”拆成配对表,再给失败标签和随机种子算一笔账
- 前沿雷达|DexStitch:把“过渡”也标成一个技能,从人类视频切出、转换并拼接灵巧手技能
- 前沿雷达|TDV:从一段人类视频只取手或物体的位姿轨迹,换起点扩增到 50 条再训练轨迹扩散策略
- 前沿雷达|Being-M0.7:把只有视频或只有动作的人类数据,经三段训练和门控接入,接到人形机器人的全身控制
- 物理AI实验室:一套每个数字都能核对的物理 AI 课程(课程大纲)