本节视频
配音由 AI 合成。 视频章节、文字稿与出处
文字稿
文字稿
知行问
同样一个模型,在电脑上跑得飞快。上了机器人,怎么就跟不上手脚了?上一集,我们在仿真里把策略调好了。这一集,把它搬上真机器人。这一关,绕不开三个词:量化、延迟、控制频率。
延迟与控制频率
先记住一条铁律。每个控制周期,机器人先拿到当前的观测。再算出下一个动作,发给电机。算一次要花多久?这就决定了一秒最多能算几次。延迟和频率,本是一枚硬币的两面。低层控制这头有多快?一篇论文说,控制回路要每秒跑一千次。它把这当作实时控制的底线。延迟由好几段组成。读图像、前处理、模型推理。最后,把动作发出去。还有通信。传感器到计算,计算到电机,都要走线。这几段加起来,也不能忽略。这背后是硬实时的要求。每一步,都必须准时交货。差一点点,就可能前功尽弃。为什么非要这么快?慢一拍,接触力就冲过头。要么打滑,要么把东西碰坏。换个说法。你眨一次眼的工夫,它已经默默纠正了许多回。快到你根本看不见。那大模型呢?视觉-语言-动作模型,想一次要慢得多。据亚马逊实测,一个这样的模型一秒约重新规划五次。两头一比,频率差了两个多数量级。这不是打比方。是实打实的鸿沟。原来这就是“大脑想得慢、小脑动得快”!差的正是频率。还有个坑。真实系统看的,不是平均延迟。是最坏的那一下,尾部延迟。偶尔卡顿一下,平均值根本看不出来。可机器人就在那一下,可能就摔了。所以要死盯最坏情况。想提速,得先看哪一段最慢。往往,就是模型推理这一段。所以我们盯着它下手。
量化:把模型压小
怎么让模型在小设备上跑得动?第一招,量化。用更少的位数,来存和算。什么意思?把一大片连续的数值,映射到有限几档整数。再记住一个缩放系数,随时还原。我们用的是动态量化。权重先压成八位整数。激活值,在推理时临时量化。先看体积。PyTorch官方称,换成八位整数,模型能缩小四倍。这是最稳的收益。再看速度。同一篇官方博客称,推理能快两到三倍。但具体要看硬件和模型。讲准不夸大。这集Notebook里,模型确实小了四倍。可在这台CPU上,它反而更慢了。为什么?这个网络太小,又跑在CPU上。量化的额外开销,盖过了省下的计算。那什么时候才提速?模型够大,又卡在内存带宽上的时候。整数搬得快,也算得快。还有个现实。边缘设备的内存,往往小得可怜。先能装下,才谈得上跑得动。精度掉多少能忍,要看任务。抓个杯子,也许无所谓。做手术,就半点不能马虎。量化不是唯一的招。还有剪枝、蒸馏、换更小的骨干。它们常常一起上。但量化最省事。一行代码,就能把线性层换成整数版。这也是我们先讲它的原因。量化也有代价。它本质是近似,精度会掉一点点。好在,通常掉得很小。原来量化不是魔法。省地方最靠谱,提速要看情况!
上边缘,让它真跑起来
体积压下来,还得有地方算。据英伟达介绍,有一款机器人计算模组。一百三十瓦内,就能跑最新的模型。为什么一定要在机器人身上算?上云要来回传,延迟高,还怕断网。摄像头数据,也未必想外传。但再快的芯片,也扛不住每一步都跑一遍大模型。延迟这道坎,绕不过去。工程上的解法,是把慢的和快的分开。让大模型低频地想。一次,就想出一整段动作。再交给一个很快的控制器,一步一步执行。这个办法,叫动作分块。动作分块也有讲究。块太长,来不及对新情况反应。块太短,又回到老问题。所以要在两者之间权衡。既想得够远,又不失反应。这就是边缘部署的手艺。把慢快分开,还带来一个附带好处。像安全检查这种活儿,可以专门放进那个快回路。一步一步,兜住每一个动作。原来关键不是让模型更快。是让它别挡在快回路上!这样,慢规划器按自己的节奏想。快控制器按自己的节奏动。两条频率,各行其道。还没解决的是:延迟只是变少了,没有消失。网络一抖,块与块之间还可能接不上。这时候,就得有人兜底。打开这一集的Notebook,跟着做一次。量化前后各测一遍延迟。再换算成能跑多少赫兹。你会亲眼看到那条铁律。延迟的倒数,就是控制频率的天花板。数字,不会骗人。回顾一下,三个要点。一,延迟决定频率上限,是倒数关系。二,量化最稳的是省体积,提速要实测。三,慢规划配快控制,用分块把两者拆开。把大模型搬下云端、装上机器人。靠的不是更快的芯片,是更聪明的分工!可万一模型算出一个危险的动作,谁来拦住它?下一集见!
证据与出处
动手与自测
小测公开,答案与解析在作答后显示;图文课里的练习答案需登录查看。
第 2.6 集的视频把上一集在仿真里调好的策略搬上机器人,讲了三件事:控制频率的上限是单圈时延的倒数,真实系统要盯的是尾部延迟,不是平均延迟;量化最稳的收益是省体积(int8 约缩到四分之一),提速要看硬件,得实测;大模型想得慢、低层控制要快,工程上用动作分块把两者分开,延迟只能被管理,不会消失。片中四张数字卡出自四份公开材料:multipanda_ros2 论文(arXiv 2602.02269)称,维持 1 kHz 控制频率是其实时控制所必需,也是安全标准要求的最低频率;AWS 博客报告,π0 在 H100 上 ODE 只解 1 步时,一个 50 步的动作块不到 200 ms,约可每秒重规划 5 次;PyTorch 博客称,量化让模型体积缩小 4 倍、推理快 2–3 倍,视硬件和模型而定;NVIDIA 博客称,Jetson Thor 在 130 W 的功耗范围内提供最高 2070 FP4 TFLOPS 的 AI 算力。本篇是这一集的图文课与练习,不重复文字稿,而是做三件视频只点到的事:把四个数字放回各自的系统,分清哪个说的是控制回路、哪个是规划器、哪个是模型体积、哪个是功耗;用一组假想数字把“各段时延、频率上限、超时次数”完整算一遍;把“量化省了什么”拆成权重体积、运行时内存和时延三笔账,最后为一个慢规划器定重规划周期和动作块长度。贯穿全文的规则:一个频率、时延或倍数,只属于测出或标称它的那个系统、硬件和设置;不同系统的数字不能相乘、相除,也不能拼成一台机器人的参数。
本节视频、文字稿与出处在本页上方,全季安排见课程大纲。上一课物理AI实验室 2.5:sim2real 的域随机化与系统辨识,把两篇论文的数字放回原设定,再从一条推杯轨迹手算摩擦结尾问:参数对上了,模型装上机器人,延迟和算力又怎么卡?本课接着回答。三个频率各属哪个系统,物理AI实验室 0.3:看-想-动,把三个频率放回各自的系统已经练过;把频率换成周期,物理AI实验室 1.2:PID 与控制频率,手算三项输出,再把频率换成周期已经算过;Jetson Thor 相对上一代的算力倍数,物理AI实验室 0.2:为什么是现在,数据、模型、算力三条曲线已经讲过;异步推理时动作队列的时间余量,物理AI实验室 2.3:微调 SmolVLA,为一句指令配好示范数据,核对每个数字的口径,再给异步动作队列算时间账已经算过;成功率怎样配对、失败怎样分类,物理AI实验室 1.8:评测,把“净增 2”拆成配对表,再给失败标签和随机种子算一笔账已经练过。本课不再重复这些,只讲本集新用到的四份材料,以及延迟、量化和动作块之间要算清的几笔账。安全检查怎样挂进快回路,是下一集 2.7(控制障碍函数)的内容。
公开小测的 5 道题附完整解析;登录后可完成三项练习:从一份虚构的 20 圈时延日志算出中位数、均值和最坏值各自对应的频率上限,并数出三个目标频率下的超时次数;读一张虚构的量化测速表,分开记权重体积、运行时内存和时延,再判断四条说法;审一份虚构的边缘部署方案,为慢规划器定重规划周期和动作块长度,并改写引用三份材料的句子。每项都附分步解法、常见错误与 20 分评分标准。
一、四个数字,各自属于哪个系统
片中四张数字卡对应四句原文,下面各自独立摘录。按本课程的分级,论文属 R 级,三篇厂商或官方博客属 O 级;数字都是作者或厂商报告,本站没有复现其中任何一项。
multipanda_ros2 论文(Škerlj 等,arXiv 2602.02269,页面注明已发表于 ICRA 2026)的摘要:
A central focus of this work is sustaining a 1kHz control frequency, a necessity for real-time control and a minimum frequency required by safety standards.
AWS 博客 Fine-Tuning π0 (Pi-Zero) for robotic manipulation on Amazon SageMaker HyperPod EKS:
At 1 ODE step on H100, a full 50-timestep chunk takes under 200 ms, so the policy can re-plan at about 5 Hz while each chunk covers roughly one second of robot motion.
PyTorch 博客 Introduction to Quantization on PyTorch:
Quantization provides a 4x reduction in the model size and a speedup of 2x to 3x compared to floating point implementations depending on the hardware platform and the model being benchmarked.
NVIDIA 技术博客 Introducing NVIDIA Jetson Thor, the Ultimate Platform for Physical AI(2025-08-25):
Jetson Thor delivers up to 2070 FP4 teraflops of AI compute within a 130 W power envelope.
| 片中说法 | 说的是谁 | 原文的条件 | 原文没有说什么 | 等级 |
|---|---|---|---|---|
| 每秒一千次,实时控制的底线 | multipanda_ros2:一个基于 ros2_control、从单个进程控制多台 Franka Robotics 机器人的开源 ROS 2 框架 | 它的实时力矩控制回路;第二节说,1 kHz 的低层力矩指令回路让上层控制器可以把关节当作理想力矩源,并称 ISO 10218 等安全标准为碰撞检测规定了 1 kHz 的测量频率 | 没有说规划器或 VLA 要跑到 1 kHz;本课没有查阅 ISO 10218 原文 | R(作者报告) |
| 一秒约重新规划五次 | π0:Physical Intelligence 的 30 亿参数 VLA,博客用的是 LeRobot 移植版 lerobot/pi0_base | 单块 H100,ODE 只积分 1 步,生成一个 50 步动作块不到 200 ms,每块约覆盖 1 秒机器人动作 | 不是边缘设备上的测量;博客的精度评测只平均了前 5 个留出回合 | O(厂商自测) |
| 缩小四倍、快两到三倍 | PyTorch 的 int8 量化;博客写于 PyTorch 1.3 引入量化、1.4 发布量化模型的时候 | 与浮点实现相比;提速取决于硬件平台和被测模型 | 不保证任何一个模型的提速;4 倍说的是体积,不是速度 | O(官方博客) |
| 一百三十瓦内就能跑最新的模型 | Jetson Thor;规格表里对应 Jetson T5000 模块 | 最高 2070 FP4 TFLOPS(规格表注为 Sparse FP4),功耗范围 40–130 W | 不是任何一个模型在机器人上的时延;2070 是峰值算力 | O(厂商自述) |
读这张表要注意四点:
- 约 5 Hz 本身就是一次取倒数。博客由“一个动作块不到 200 ms”推出“约 5 Hz”:1 ÷ 0.2 s = 5 次/秒。它是这个规划器在这套硬件上重规划次数的上限,不是机器人底层回路的频率。同一篇博客还报告,在 LIBERO 上把 ODE 步数从 10 降到 1,时延从 379 ms 降到 197 ms,精度没有损失。省时间的办法不只有量化。
- “差了两个多数量级”是两套系统并排。视频把约 5 Hz 和 1 kHz 放在一起,是为了说明大模型规划器和低层力矩回路的频率差距有多大;5 Hz 来自 H100 上的 π0,1 kHz 来自 Franka 多臂框架,两者不是在同一台机器人上测出的比值。0.3 用过的 π0 论文数字(在以 50 Hz 运行的机器人上,每执行 25 个动作、约 0.5 秒重推理一次)也是另一组条件,不能与 AWS 的数字合并。
- 1 kHz 不是所有机器人的共同参数。论文表 I 列出的力矩控制机器人里,多数的指令频率是 1 kHz,但 Boston Dynamics Atlas 1(2013)为 333 Hz,Berkeley Blue(2019)为 170 Hz;作者说明这是一份不完整的清单。
- 130 W 那一句出自页面顶部标注为 AI 生成的摘要。正文的对应句子说,开发者套件由 Blackwell GPU 和 128 GB 内存驱动,在 130 W 功耗范围内提供最高 2070 FP4 TFLOPS,可以运行最新的生成式 AI 模型;规格表把 T5000 模块的功耗列为 40–130 W。这些都是厂商对硬件能力的描述,不说明任何一个模型在上面的时延。
登录后继续阅读本课其余各节、自测题与答案。
局限 / 注意
- multipanda_ros2(arXiv 2602.02269)属 R 级,页面注明已发表于 ICRA 2026;1 kHz、表 I 的频率和关于 ISO 10218 的说法都是作者的陈述。本课读的是摘要到方法一节开头,没有查阅 ISO 10218 原文,也没有读论文的实验结果。
- AWS 博客属 O 级,是厂商在自己设置下的测量:π0 的 LeRobot 移植版、单块 H100、ODE 1 步;精度评测只覆盖前 5 个留出回合。本站没有复现。
- PyTorch 博客属 O 级,写于 PyTorch 1.3 与 1.4 的时期;文中的 API 名称、后端支持和样例数字只对应那一版,本课没有核对之后的版本。
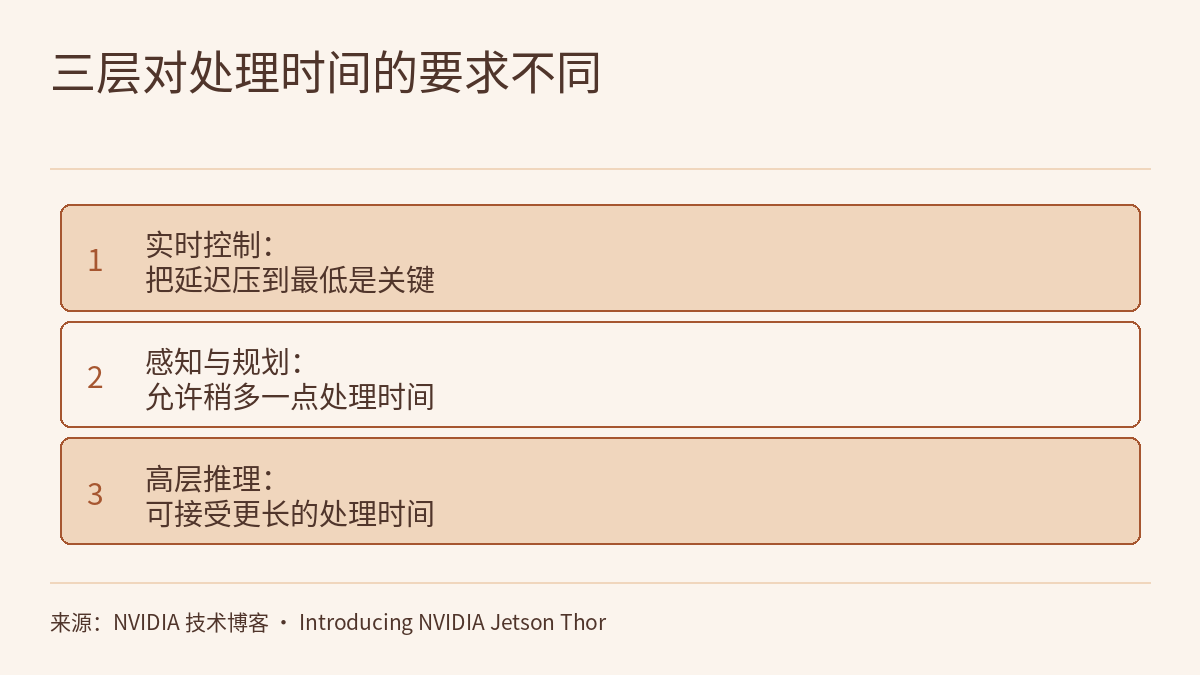
- NVIDIA 博客属 O 级。片中 130 W 那一句出自页面上标注为 AI 生成的摘要,正文与规格表的说法与之一致;2070 FP4 TFLOPS 是峰值算力,T4000 的规格页面注为初步数据。四层分工是厂商对典型人形机器人的描述,不是标准,也没有毫秒数;配图省略了原文没有给出时间要求的硬件抽象层。
- 视频里 Notebook 的“小了四倍、在 CPU 上反而更慢”只按视频转述;本课没有运行 Notebook,也没有读到它保存的具体时延。
- 以下是本课的说明、建模选择或推断,原文没有这样写:串行完成一圈的前提与流水线的说明;最坏反应时间约为 P + L(加上往返时间)的模型和“一块至少覆盖 P + 最坏 L”的保守简化;测速与评测的建议做法;1 MB = 10⁶ 字节和忽略缩放系数的算法;“AWS 说的内存限制指显存容量”是按其后一句解释所做的读法。
- 第二到第五节的机器人 R 与 R6、策略网络 S、Q 与 T、设备 A 与 E、规划器 V、团队 W,以及所有时延、参数量、内存、误差、往返时间和任务要求都是虚构的;20.8 Hz、25 Hz、1.83 倍、0.72 s 等只在这些假设下成立。
- 纸面计算和仿真结果都不是硬件安全验证;超时与断档时的兜底行为要单独做安全分析,真机试验要另做安全准备。
链接
- 物理AI实验室:一套每个数字都能核对的物理 AI 课程(课程大纲)
- 物理AI实验室 2.5:sim2real 的域随机化与系统辨识,把两篇论文的数字放回原设定,再从一条推杯轨迹手算摩擦
- 物理AI实验室 2.3:微调 SmolVLA,为一句指令配好示范数据,核对每个数字的口径,再给异步动作队列算时间账
- 物理AI实验室 1.8:评测,把“净增 2”拆成配对表,再给失败标签和随机种子算一笔账
- 物理AI实验室 1.2:PID 与控制频率,手算三项输出,再把频率换成周期
- 物理AI实验室 0.3:看-想-动,把三个频率放回各自的系统
- 物理AI实验室 0.2:为什么是现在,数据、模型、算力三条曲线
- 前沿雷达专题|边缘与实时性:VLA 与世界动作模型的延迟预算花在哪里(雷达 9 月归档中另外 9 项材料的毫秒数)
- Bridging the Sim-to-Real Gap with multipanda_ros2: A Real-Time ROS 2 Framework for Multimanual Systems(arXiv 2602.02269)
- AWS:Fine-Tuning π0 (Pi-Zero) for robotic manipulation on Amazon SageMaker HyperPod EKS
- NVIDIA 技术博客:Introducing NVIDIA Jetson Thor, the Ultimate Platform for Physical AI(2025-08-25)
- PyTorch 博客:Introduction to Quantization on PyTorch