
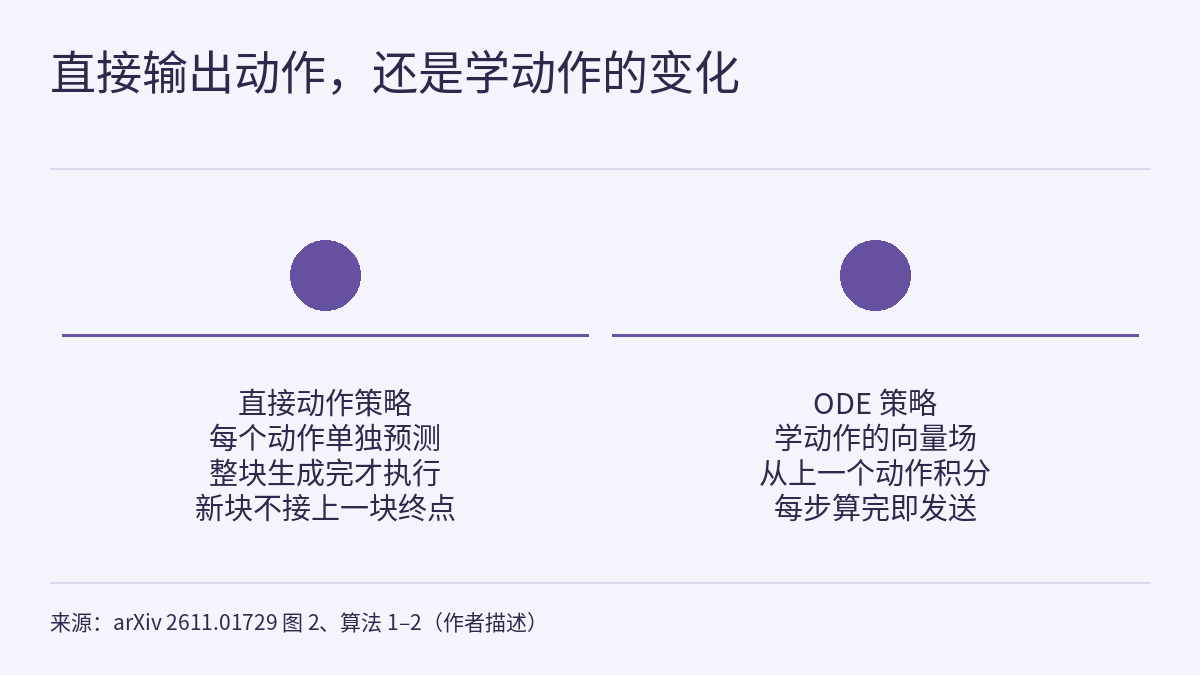
预印本 ODE Policy(arXiv 2611.01729,2026-11-01,南洋理工大学 MARS Lab)改的是机器人策略的输出:网络不再直接给出每个控制步的动作值,而是学动作随时间变化的速度,也就是动作的向量场,再从上一个动作积分出下一个。这样,执行出来的动作轨迹在构造上就是连续的,相邻两个动作块之间也不会跳变。作者把同一套做法用作视觉运动策略、π0.5 与 ImageWAM 的动作头、GR00T N1.7 在人形机器人上的动作头,以及 SuperMimic 的 RL actor。读结果时要注意,它最大的优势出现在训练早期;多个设置里,基线后来追平了。以下数字均为作者报告 [R],本站未复现。
直接动作策略缺了什么
论文把现有策略统称为“直接动作策略”(direct-action policy):编码观测和本体状态,直接输出未来动作的数值。无论是回归头、扩散或 flow matching 生成头,还是 RL 的 actor,每个动作都是单独的一个值,模型本身不约束相邻动作之间的关系,运动的连续性只能从数据里隐式学到。作者指出了三处后果:
- 独立预测的动作块在边界处可能不一致,指令会跳变。
- 扩散和 flow matching 推理时虽然也解微分方程,但积分变量是没有物理意义的“生成时间”;中间样本不是机器人能到达的状态,每个块都从头生成,与上一个块停在哪里无关。生成式策略每块还要多次网络前向,整块生成完才能执行第一个动作。
- 在 RL 里,没有显式正则时,actor 的动作常在相邻控制步之间高频振荡。
论文的出发点是:机器人是在时间上连续运动的宏观系统,遥操作示范基本上是一条连续动作轨迹按控制频率采样的结果。论文也说明,动态运动基元等用 ODE 描述机器人运动的方法早已有之,但它们固定了向量场的形式或要求它收敛到吸引子,每个模型只能表示少数几种运动;ODE Policy 不对向量场加结构约束,用一个场覆盖大规模任务。
怎么训、怎么跑
向量场。图像历史和指令编码成 z_t,网络 f_θ(a(t), s_t, z_t) 输出动作的速度。时间 t 以控制步为单位,是机器人的物理时间;本体状态 s_t 直接输入向量场,而不是和观测一起编码。积分出来的是发给底层控制器的目标动作,不是实测的机器人状态。
分块积分与路径损失。每个决策步只算一次 z_t,在整个块内保持不变,从上一个动作 â_{t−1} 出发积分 H 步得到一个动作块。训练时从示范动作出发积分 H 步,用积分路径与示范的平方误差作损失。块很短,梯度直接穿过求解器步反传,不需要伴随法(adjoint);向量场也从不对着由示范差分出来的速度标签做回归,作者认为那样会放大示范里的抖动。
收缩扰动(contractive perturbation)。执行时策略从自己上一次的输出继续积分,误差会带进下一步、下一块,状态逐渐离开示范。训练时按概率 p 给起点加一个高斯扰动 δ,要求积分路径在第 k 步回到 a_{t+k} + ρ^{k+1}δ(0 < ρ < 1),偏差按几何级数缩小,向量场就学会把附近的状态拉回示范。这依赖于向量场把当前动作当输入,作者指出直接动作策略没有对应的做法。它不需要额外数据,推理时也没有额外计算。
推理。每个动作由上一个积分一步得到,下一个块从上一个块的最后一个动作接着积分,而不是从实测状态重新开始,论文称之为无缝分块(seamless chunking)。作者列了三点好处:块与块之间没有跳变;每个动作积分出来就能发给控制器,不必等整块生成;积分步长可以在部署时选,例如配合更高的控制频率。
多样性头。确定性的向量场拟合的是示范的平均速度,左绕和右绕的示范会被平均成直撞障碍物。作者加了一个轻量的头:每块开始时从 K 个分量的高斯混合里采一个方向 ε,再给每步一个非负速率 λ_k,把 λ_k ⊙ ε 加到速度上。它读向量场的隐藏特征时截断梯度,不改变向量场的梯度。作者也说明,强多模态只出现在少数任务里:LIBERO 上同一观测下的动作差别很小,所有 IL 实验虽然都带这个头,但在 LIBERO 上用的是分量均值,而不是采样。
RL。actor 每个控制步只算一个动作(H = 1),从上一个动作走一步 Euler:â_t = â_{t−1} + f_θ(…)。critic 和算法都不变。SuperMimic 通过 32 个想象步反传回报,而这一步让 ∂â_t/∂â_{t−1} 含有单位阵,梯度可以沿动作链传到早期动作。
结果:要按训练轮次读
摘要的总括是:模仿学习中,与 flow matching 相比,训练一个 epoch 后成功率是其 5.9 倍、泛化 5.4 倍、模态均衡 3.9 倍,生成动作快 10.8 倍。正文的细节显示,前三个倍数集中在训练早期(10.8 倍是推理速度,与训练轮次无关):
| 设置 | 1 个 epoch 后 | 之后 |
|---|---|---|
| 视觉运动策略,LIBERO 四个套件(3 个种子) | 79.2%,6 个基线最高 43.2% | 第 2 个 epoch 超过 85%,第 100 个 epoch 仍领先 |
| π0.5 动作头(1 个种子) | 96.0%,随机初始化的 FM 专家 75.5% | 用 π0.5 预训练权重初始化的 FM 专家从第 2 个 epoch 起追上 |
| ImageWAM 动作头(1 个种子) | 82.6%,原动作头 24.6% | 三种动作头从第 6 个 epoch 起收敛 |
| LIBERO-plus 零样本扰动(视觉运动策略) | 30.1%,ACT 22.6% | 之后与最强基线持平 |
| 2D 导航四条路线,模态均衡 γ | FM-DiT 的 3.9 倍 | 第 10 个 epoch FM-DiT 更均衡,第 20 个 epoch 两者相近 |
摘要和引言写的是“96.0% 对其 flow matching 专家的 75.5%”,第 6.1.2 节说明,75.5% 对应的是随机初始化的 FM 专家。ODE 头约 13.7M 参数,替换的是 430M 的原动作专家(论文称约 3%),同样随机初始化。
数据和参数上的结果同样出自 LIBERO:每个任务 20 条示范时,第 100 个 epoch 达到 87.7%,高于用全部 50 条训练的 FM-DiT(85.4%);编码器之外只有 1.5M 参数的 ODE Policy 在第 10 个 epoch 达到 92.5%,高于 48M 的 FM-DiT 在任何 epoch 的成绩(最高 87.5%)。作者据此认为优势来自 ODE 的表述方式,而不是模型容量。
速度方面,用 Euler 时一块 8 个动作耗时 5.7 ms,与 A2A-DiT 相当,比 FM-DiT 快 10.8 倍,比 DDPM 快约 100 倍;ACT 稍快,但成功率低得多。在 π0.5 中,ODE 头约比 10 步去噪的 FM 专家快 14 倍,整个模型的时间省下约三分之一;在块边界处,指令的变化约为原来的一半。在 ImageWAM 中,每块耗时约降到四分之一。
真机 14 项任务与 RL
真机部分用了四台机器人:Franka Research 3 单臂、Galaxea R1 Lite 双臂、带 Sharpa 灵巧手的 Sharpa North,以及带 Inspire DFX 灵巧手的 Unitree G1 人形机器人。每项任务评测 20 次;默认训练 300 个 epoch,单臂只训 50 个 epoch(有意考察早期表现),人形训 90 个 epoch。每台机器人上的对照基线不同。作者称 ODE Policy 在全部 14 项任务上成功率最高,以下是几组:
- 单臂(每任务 40 条示范):叠袜子 15/20、插方块 14/20,最好的基线分别为 8/20 和 4/20。
- 双臂:微波炉任务只有 34 条示范,75% 对 FM-DiT 的 20%;左右臂都可能去放苹果的多模态抽屉任务中,左臂 8 次、右臂 12 次,合计成功 60%,FM-DiT 两只手都会去拿苹果,但从未放进抽屉。
- 灵巧手:只用另一实验室公开的 SharpaDex 数据(每任务 50 条)训练,在作者实验室部署,扶正倒下的杯子 17/20(FM-DiT 一次也没抓住杯子),双手倒药片 17/20(FM-DiT 10/20),叠方块 13/20(两个基线全部失败)。
- 人形:作为 GR00T N1.7 的动作头(约 5M 参数的向量场,H = 16,Euler),每任务 90 条示范,两项走动加抓取的长程任务成功率 60% 和 70%,GR00T 原动作头为 35% 和 30%。
每项 20 次时,1 次相当于 5 个百分点(本站换算);所读正文没有给出真机结果的置信区间。在三台机器人各一项任务上,生成一块比扩散和 flow matching 基线快 3.5–27 倍;块边界处的指令加速度与示范持平或更低(单臂上接近示范),基线可达示范的数倍。
RL 部分把 SuperMimic 的 actor 换成 ODE actor,世界模型、critic、奖励和超参数都不变,在仿真里用 Unitree G1 跟踪 40 段 LAFAN1 动作,每种方法 3 个种子,单块 GPU 训练 3 小时。0.75 小时时训练回报高 37%(0.630 ± 0.007 对 0.460 ± 0.008);全部 40 段上的评测回报在 0.4 小时高 30%,到训练结束时为 0.885 ± 0.007 对 0.845 ± 0.009;PPO 3 小时后为 0.452 ± 0.021。第一个想象动作与最后一个的梯度范数之比,直接动作 actor 约 0.57,ODE actor 为 1.0–1.1;作者认为提速“可能”来自这条梯度路径。3 小时后,ODE actor 动作的加速度比原 actor 低 21%。
哪些设计在起作用:消融
- 块长。训练和执行都用 H = 1 时,第 100 个 epoch 只有 76.4%,每个动作也最慢(每步都要跑编码器);从 H = 4 起都高于 91%,默认的 H = 8 最好;H ≥ 12 时训练偶有损失尖峰。
- 求解器。RK4 换成 RK2 或 Euler,第 100 个 epoch 的成功率变化不到 1 个百分点,在种子间波动以内。作者据此认为性能来自 ODE 的表述方式,而不是精确的求解器;用 Euler 时训练时长与 FM-DiT 相当。
- 收缩扰动。去掉后,1 个 epoch 的成功率从 79.8% 降到 58.4%(这组消融每任务 10 个回合,所以默认值是 79.8% 而非 79.2%),差距到第 20 个 epoch 消失;扰动幅度加倍的设置后期略低。
- 无缝分块。改成每块从实测状态重新开始,1 个 epoch 的成功率从 79.8% 降到 47.8%。论文的解释是,这丢掉了目标动作领先于实测状态的那一段。
本站的解读是:这两项消融说明,早期的大幅领先有相当一部分来自“训练时教会向量场回到示范”和“执行时从上一个指令接着积分”这两件事。这一归因是本站的读法,论文没有这样表述;论文在第 8 节还指出,即使去掉收缩扰动,ODE policy 在 1 个 epoch 后仍明显领先 FM-DiT 和 A2A-DiT。所读正文给出的是早期数字,后期差距的完整曲线在图 17 里,本站没有读到图中的数值。
和本站课程与前沿雷达的关系
物理AI实验室 1.6:模仿学习 讲过两件事:行为克隆的误差会把机器人带出示范覆盖的范围;左右两种正确绕法会被平均成一次碰撞。ODE Policy 对这两点各给了一个结构上的回应:收缩扰动在训练时教向量场把偏离的状态拉回示范,多样性头在每块开始时选定一个方向。它也沿用了 1.6 里 ACT 的动作分块,只是把块当作积分单位。
物理AI实验室 2.3:微调 SmolVLA 里的动作专家用 flow matching 把噪声一步步修成一段动作,异步推理则是边执行当前块、边算下一块。ODE Policy 的“流式执行”是另一回事:同一个块里,每个动作积分出来就发出,下一个块从上一个块的终点接着算。物理AI实验室 2.6:上边缘 讨论过块长的取舍,本文的 H 消融是同一取舍在一个具体方法上的数字,但只在 LIBERO 上测得。RL 一节的 actor 与回报,可以对照 物理AI实验室 1.7:强化学习 阅读。
前沿雷达|ActionUNet 同样关心 VLA 动作的平滑,做法是在冻结主干的动作特征上加时间 U-Net 和连续解码器;ODE Policy 则替换掉整个动作头。两者的基准和对照不同,数字不能互比。读本文的表时,可以用 物理AI实验室 1.8:评测 的方法追问:π0.5 和 ImageWAM 只有 1 个种子,真机每项 20 次,早期优势在多大程度上能延续到训练结束。
局限 / 注意
- 这是 arXiv 预印本,全部数字为作者报告 [R],本站没有复现。论文首页列有项目页和代码,本站没有打开核对。
- 本站读到的正文止于第 8 节消融的中段,第 9 节(含只有实测状态时怎样处理目标动作与实测状态之差、夹爪改用向量场积分的消融)和全部附录、补充表都没有读到。
- “5.9 倍、5.4 倍、3.9 倍”都是训练 1 个 epoch 后的比值。π0.5 中预训练过的 FM 专家从第 2 个 epoch 起追上,ImageWAM 中三种动作头从第 6 个 epoch 起收敛,LIBERO-plus 上后期与最强基线持平,导航任务第 10 个 epoch 时 FM-DiT 更均衡。
- 视觉运动策略的实验有 3 个种子;π0.5 和 ImageWAM 的结果只有 1 个种子。真机每项任务 20 次,每台机器人的基线不同,人形上只与 GR00T 原动作头比较;所读正文没有给出真机结果的置信区间。
- LIBERO 上的二值夹爪指令由一个单独的分类头(0.27M 参数)预测,不经过向量场积分;多样性头在 LIBERO 上用分量均值,不采样。
- 积分出来的是发给底层控制器的目标动作。对只有实测状态的数据(如 UMI 采集或人类视频),作者在第 9 节讨论,本站没有读到。
- LIBERO-plus 上换相机视角时所有方法都失败;RL 结果只在仿真中跟踪动作,没有真机 RL。所有结果都不是硬件安全验证。
链接
- ODE Policy: Robot Learning via Action Dynamics, Not Actions(arXiv 2611.01729)
- 论文 HTML 全文
- 物理AI实验室 1.6:模仿学习,手算误差怎样滚出示范覆盖范围,再把 ACT、扩散策略与数据规模律的数字放回各自条件
- 物理AI实验室 1.7:强化学习,手算一局回报看奖励怎样被钻空子,再读论文里的地形课程与超时重置
- 物理AI实验室 1.8:评测,把“净增 2”拆成配对表,再给失败标签和随机种子算一笔账
- 物理AI实验室 2.3:微调 SmolVLA,为一句指令配好示范数据,核对每个数字的口径,再给异步动作队列算时间账
- 物理AI实验室 2.6:上边缘,从时延日志算出控制频率上限,分清量化省下的是体积还是时间,再给动作块定长度
- 前沿雷达|ActionUNet:在 VLA 动作特征上加时间 U-Net 与连续解码器,兼顾多尺度与动作平滑
- 物理AI实验室:一套每个数字都能核对的物理 AI 课程(课程大纲)


