
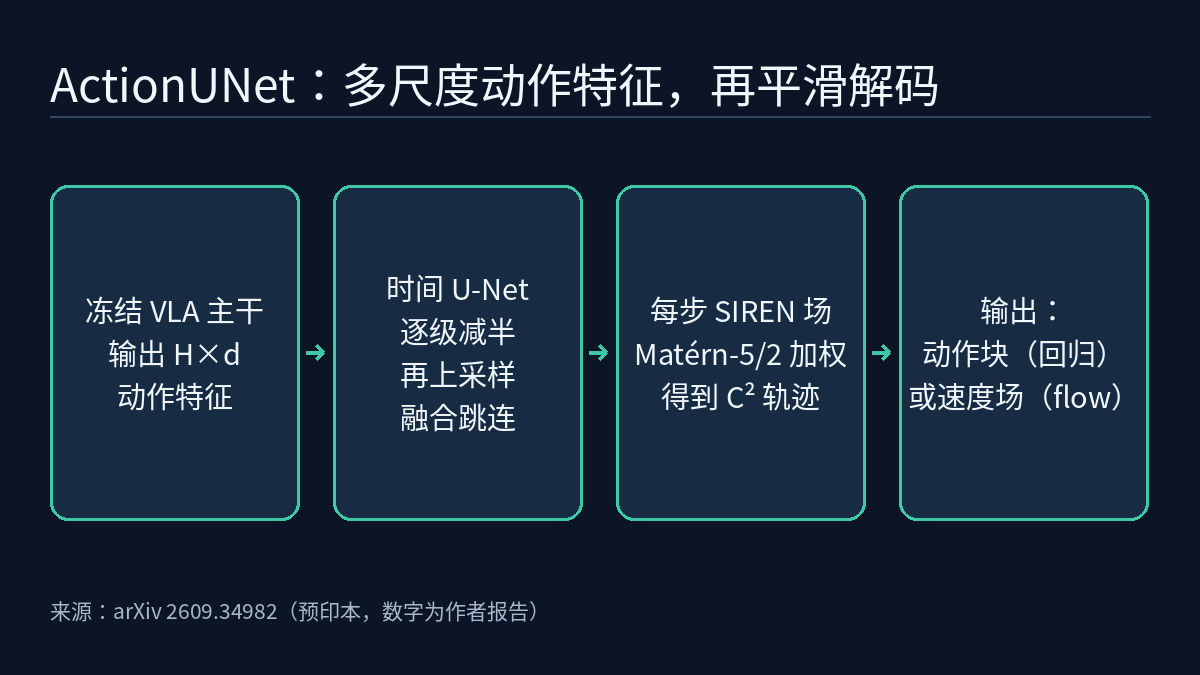
VLA 的动作专家通常把视觉-语言模型给出的高层语义逐步映射成动作,但同一个任务里,有的阶段手臂大幅移动,有的阶段每步位移很小、属于细尺度动作。中国科学院大学团队的预印本 ActionUNet(arXiv 2609.34982,2026-09-28,证据等级 [R])把这种差异称为“时间尺度错配”,并在冻结的 VLA 主干之后加了两个轻量模块:一个在动作特征上做多尺度编码的时间 U-Net,和一个保证动作块内部二阶连续的条件 SIREN 解码器。作者报告,π0.5 在 RoboTwin 2.0 困难设置、LIBERO-Plus 和真机困难设置上的成功率分别提高 9.8、6.1 和 11.4 个百分点,单次策略调用慢约 6.5%。这篇论文值得看的地方在消融:两个模块单独使用时,各自只改善一种设置、却拖累另一种。
问题:一个动作块里混着不同尺度的动作
作者用相邻两个记录步之间左右末端执行器的位移之和来刻画“动作尺度”:位移大是粗尺度动作,位移小是细尺度动作。论文图 1 显示,这个量不仅在不同任务之间差别很大,在同一任务(如 Stack Blocks Two)的不同阶段之间也差别很大。单位是 m/step,作者明确说它是数据集层面的尺度代理量,不是物理执行速度。
作者的论点是:标准微调中,动作头逐个时间步地从高层多模态特征解码动作,是单尺度映射;模型因此过度依赖抽象语义,抓不住抵抗局部扰动所需的细粒度时间线索。但直接引入多尺度表示也有代价:不同粒度的特征拼接时,尺度边界处会出现插值误差,轨迹不平滑,进而引起机械振荡。两个模块分别对应这两个问题。
方法:时间 U-Net 加条件 SIREN 解码器
- 时间 U-Net:VLA 给出与动作时间步对齐的特征,形状为 H×d(H 为动作块长度)。编码阶段每级用一维卷积把时间分辨率减半(下采样率 r = 2),接 GeLU 和 LayerNorm;最底层经一个全连接层;解码阶段每级做 2 倍最近邻上采样,与对应的编码特征拼接,再经一个线性层融合,最后恢复到 H×d。
- 局部 SIREN 场:把动作块看作归一化时间 τ ∈ [−1, 1] 上连续轨迹的采样。以每个时间步的特征为条件输入,构成一个局部 SIREN 场(SIREN 是用正弦激活的小网络),并把原本固定的偏置换成 τ 的仿射函数,使每一层都显式感知时间。
- Matérn-5/2 加权融合:用长度尺度 ρ = 0.2 的归一化 Matérn-5/2 核,把这些局部场按与查询时刻的距离加权求和。附录给出推导:融合后的函数在 [−1, 1] 上二阶连续可导(C²)。
- 输出:对回归型策略(OpenVLA-OFT),输出直接是动作块,用 ℓ1 损失;对 flow matching 策略(π0.5),输出是速度场,损失与原策略相同,但把白噪声换成按 Matérn-5/2 协方差采样的时间相关噪声,让去噪目标也更平滑。
训练时预训练主干保持冻结,只微调动作专家和新增模块,并沿用原策略的训练目标。RoboTwin 2.0 上 π0.5 的微调用 2 张 RTX 4090、8K 步;LIBERO 上用 8 张 A800、40K 步。论文称代码与实现细节已在作者的 GitHub 仓库公开,本文没有核对仓库内容。
作者报告的结果
RoboTwin 2.0 从 50 个双臂任务中选了 12 个,每个任务用 50 条干净示范训练,在简单和困难设置(干扰物、背景、光照、桌面高度、语言变化)下各评测 100 次。LIBERO-Plus 在 LIBERO 上训练后直接评测,覆盖 7 类扰动。真机为 Realman Gen72 双臂平台,3 个任务,每个任务每种设置 50 次,困难设置随机加入干扰物。
| 评测(平均成功率) | 基线 | +ActionUNet | 变化(百分点) |
|---|---|---|---|
| π0.5,RoboTwin 2.0 简单(12 任务) | 59.6% | 68.4% | +8.8 |
| π0.5,RoboTwin 2.0 困难(12 任务) | 29.8% | 39.6% | +9.8 |
| π0.5,LIBERO(4 个套件) | 95.6% | 97.7% | +2.1 |
| π0.5,LIBERO-Plus(7 类扰动) | 65.8% | 71.9% | +6.1 |
| π0.5,真机简单(3 任务) | 76.0% | 88.7% | +12.7 |
| π0.5,真机困难(3 任务) | 57.3% | 68.7% | +11.4 |
| OpenVLA-OFT,LIBERO | 97.9% | 98.6% | +0.7 |
| OpenVLA-OFT,LIBERO-Plus | 60.9% | 64.6% | +3.7 |
LIBERO-Plus 上 π0.5 的 7 类扰动全部提高,幅度最大的是相机(48.2% → 56.9%)、机器人状态(45.9% → 54.4%)和传感器噪声(52.0% → 61.1%),光照(93.0% → 94.6%)和背景(87.4% → 89.8%)提升较小。RoboTwin 2.0 的 12 个任务中也有没提升的:Press Stapler 简单设置从 74% 变为 73%,Handover Mic 简单设置两者都是 100%。表中 RDT、π0、ACT 等其他方法的数字引自已有论文,作者自己复现的只有 π0.5 和 OpenVLA-OFT。
消融:两个模块单独用各有偏向
消融在 4 个 RoboTwin 2.0 任务上、以 π0.5 为基础做(因此完整方法的数字与 12 任务平均不同):
| 变体 | 简单 | 困难 |
|---|---|---|
| π0.5 | 69.0% | 34.5% |
| + 仅时间 U-Net | 67.5% | 37.3% |
| + 仅 SIREN 解码器 | 75.5% | 33.3% |
| ActionUNet,去掉 Matérn 核 | 75.0% | 45.3% |
| 完整 ActionUNet | 77.8% | 46.5% |
只加 U-Net 时困难设置变好、简单设置变差;只加 SIREN 时正好相反。作者的解读是:多尺度结构带来抗干扰能力,但破坏动作连续性;连续解码器抑制抖动,却提供不了多尺度表示。两者合用(先不加 Matérn 核)后困难设置提高 10.8 个百分点,Matérn 核再增加 1.2 个百分点。作者还用 Grad-CAM 显示 U-Net 的细、中、粗三层分别对相应尺度的真实动作响应最强,这说明表示与尺度相关,但本身不是因果证据。
额外开销
在单张 RTX 4090 上、动作块长度 50、10 步 flow matching、开启 torch.compile 的条件下,一次策略调用从 60.947 ± 0.251 ms 增加到 64.886 ± 0.376 ms,多 3.939 ms(+6.46%)。按成功回合的平均步数折算,RoboTwin 2.0 一个回合的累计策略计算时间在简单设置多 0.934 s;困难设置下平均步数从 276.43 降到 264.29,抵消了一部分,只多 0.301 s。作者提醒这些只是策略计算时间,不是端到端的机器人执行延迟。
和本站已有文章的关系
VLA 的概念见《物理AI实验室 0.2:为什么是现在,数据、模型、算力三条曲线》。同样以 π0.5 为基础,《Fast Plans, Faithful Actions》处理的是分层 VLA 中计划生成太慢、执行器不按计划执行的问题;ActionUNet 不涉及规划,改的是动作特征到动作块的解码。
《前沿雷达专题|仿真与评测》讨论过标准起点成功率会漏掉哪些信息。ActionUNet 的数字也说明标准条件和扰动条件要分开看,但不能简单归结为“扰动下增益更大”:LIBERO 基线已有 95.6%,最多只剩 4.4 个百分点的提升空间,所以 LIBERO-Plus 上的 +6.1 更有信息量;RoboTwin 2.0 困难设置的增益(+9.8)略大于简单设置(+8.8),真机上却是简单设置的增益(+12.7)大于困难设置(+11.4)。延迟方面,6.46% 的单次调用增量可以放进《前沿雷达专题|边缘与实时性》的延迟预算框架里看;不过那里关注的是边缘设备,本文数字是在 RTX 4090 上测的。
局限 / 注意
- 这是 arXiv 预印本,所有数字都是作者报告,本文依据的材料中没有独立复现。
- 真机每个条件 50 次,RoboTwin 2.0 每个条件 100 次;本文读到的正文和附录 A–C 中没有成功率的置信区间或显著性检验。更靠后的附录本文没有审阅,其中可能有统计比较(例如 §I.2 引用了一种序贯策略比较方法)。无论那些附录是否给出检验,在这样的样本量下,个别任务的小差异(如 74% 对 73%)都不宜单独解读;《Beyond Binary Success》一文介绍过试验次数有限时比较两个策略的统计方法,可作参考。
- C² 连续性的证明针对单个动作块内部。作者自己列出的局限包括:各动作块独立建模、时间尺度固定、尺度建模只在下游动作阶段引入,块与块之间的衔接不在该保证范围内。
- RoboTwin 2.0 只用了 50 个任务中的 12 个,由作者按时间尺度组成挑选;真机只有一个平台、3 个任务。
- RoboTwin 2.0 与 LIBERO 使用了不同的 GPU 和训练步数,OpenVLA-OFT+ActionUNet 在 LIBERO 上还调低了学习率,跨基准比较提升幅度时要考虑这些差异。
链接
- arXiv 2609.34982:ActionUNet: Improving Robustness of VLA Models with Efficient Multi-scale Fine-tuning(作者:Di Zhu、Ziheng Yan、Fang Wan)
- 论文 HTML 全文


