
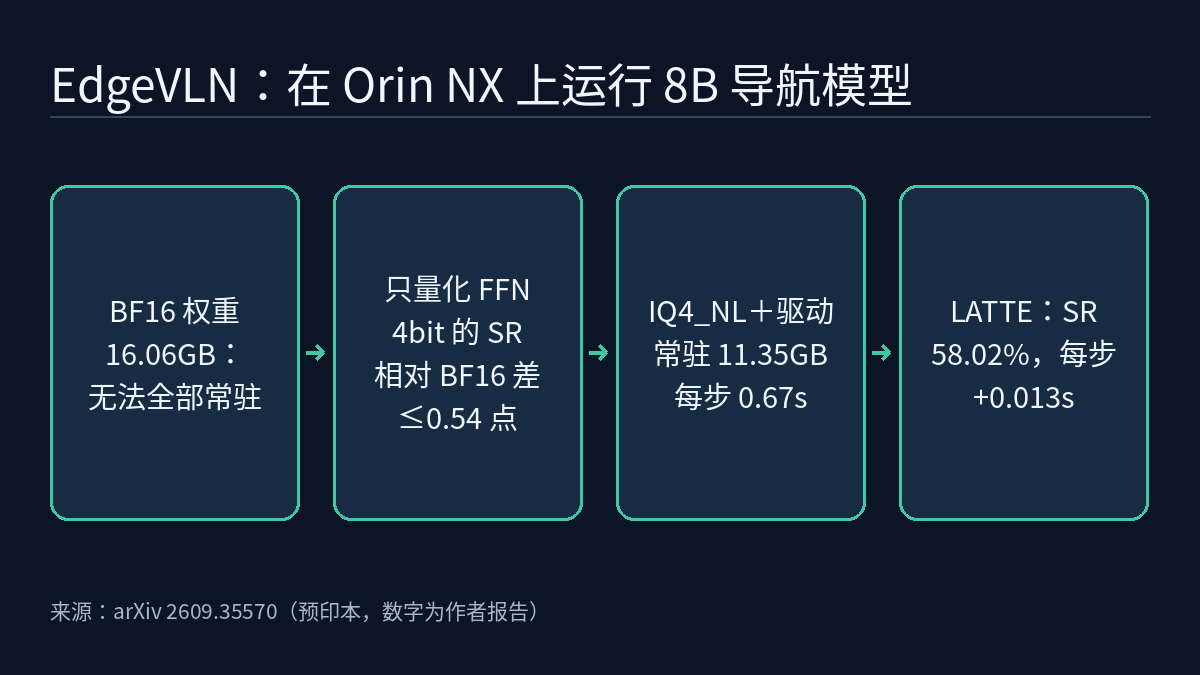
约翰斯·霍普金斯大学团队的预印本 EdgeVLN(arXiv 2609.35570,2026-09-28,证据等级 [R])尝试把一个 8.03B 参数的视觉-语言导航(VLN)模型完整放到 NVIDIA Jetson Orin NX 16 GB 上,并在板上测量延迟、能耗和常驻内存。论文报告,几种 4 bit 格式的导航成功率几乎相同,每步能耗却因执行路径(格式实现与运行时)不同而相差 36.8 倍。作者认为板上内存和速度主要由推理运行时而非位宽决定,并在量化腾出的预算里加入一个 8.2 MB 的停止判定头 LATTE。
问题:16 GB 统一内存放不下 16 GB 的权重
研究对象是 StreamVLN(arXiv 2507.05240):SigLIP-SO400M 视觉塔、两层 MLP 投影器和 28 层的 Qwen2 语言模型,共 8.03B 参数,BF16 权重 16.06 GB。Orin NX 的 16 GB LPDDR5 由 GPU、CPU、操作系统、相机管线、KV cache 和计算缓冲区共享,论文给出的统一内存池为 16.14 GB。论文列出了几条让“按位宽估算”失效的原因:
- 这块板上 PyTorch 没有 4 bit tensor core 路径,4 bit 权重主要省下的是存储和访存流量;PyTorch 框架本身要占约 3 GB。
- 名义权重大小不能预测峰值常驻内存,运行时开销、KV cache 和计算缓冲区才决定能不能装下。
- 作者只量化了语言模型的前馈(FFN)块,即 8.03B 中的 5.70B;视觉塔、投影器、注意力投影、嵌入层和 LM head 保持 16 bit。
- 导航是闭环任务,一个错误动作会改变后续观测,误差会沿轨迹累积,因此必须在闭环中评测量化后的模型。
同样是 4 bit,差别在执行路径
作者先用伪量化(权重取整到目标网格,但仍以 16 bit 存储)扫描各精度,只看格式本身对成功率的影响;再比较实际部署路径。成功率(SR)和 oracle 成功率(OSR)来自 Habitat 仿真中 R2R VLN-CE val-unseen 的全部 1,839 个闭环 episode,所有配置都在同一块 GPU 上评分;延迟、功率、能耗和内存则来自在 Orin NX 上单独进行的回放测量。论文表 I(a) 如下(能耗和延迟按每个导航步计):
| 格式 | 权重 (GB) | SR (%) | OSR (%) | 常驻内存 (GB) | 功率 (W) | 能耗 (J) | 每步延迟 (s) |
|---|---|---|---|---|---|---|---|
| BF16 | 16.06 | 57.69 | 65.04 | 14.99 | 10.85 | 151.68 | 13.98 |
| INT8(能加载,8 步后内存不足) | 10.36 | 57.04 | 64.82 | 15.98 | – | – | – |
| INT4 | 7.68 | 57.48 | 64.60 | 15.85 | 19.79 | 419.70 | 21.21 |
| NF4 | 7.68 | 57.15 | 64.76 | 14.70 | 18.18 | 19.31 | 1.06 |
| IQ4_NL(部署) | 7.94 | 57.31 | 64.11 | 11.35 | 16.97 | 11.41 | 0.67 |
| INT2 | 6.44 | 46.00 | 55.79 | 16.03 | 20.08 | 437.86 | 21.81 |
各 4 bit 格式的 SR 与 BF16 相差都不超过 0.54 个百分点,2 bit 则跌到 46.00%。INT4 和 NF4 的权重(7.68 GB)比 IQ4_NL(7.94 GB)还小,在 PyTorch 下也跑完了板上回放,但峰值常驻分别为 15.85 GB 和 14.70 GB,IQ4_NL 在作者的驱动下只有 11.35 GB。能耗上,IQ4_NL 每步 11.41 J,NF4 是它的 1.7 倍,INT4 是 36.8 倍;论文把 INT4 每步 21.21 s 归因于它的反量化路径。同在 PyTorch 下、权重大小相同,INT4 的每步能耗是 NF4 的 21.7 倍(419.70 J 对 19.31 J),延迟是 20 倍(21.21 s 对 1.06 s)。BF16 无法全部常驻,28 个 Transformer 块中只有 20 个加输出层常驻,其余每个 token 都从存储读取,延迟和能耗分别是 IQ4_NL 的 20.8 倍和 13.3 倍,SR 只高 0.38 个百分点;它的平均功率最低(10.85 W),原因是 GPU 在等存储。
部署点的每步 0.672 s 是摊销值:一次生成输出 4 个动作,89 个请求中只有 24 个触发生成,其余在 0.024 s 内返回已缓冲的动作;按每次四动作决策计为 2.49 s、42.3 J。
llama.cpp 驱动做了什么
llama.cpp 有原生低比特内核,但每轮只编码一张图,没有接口承载 StreamVLN 的滚动上下文。作者写的 VLN 驱动补上了这部分:
- 把视觉塔和投影器导出为运行时的多模态格式,重新实现 27×27→14×14 池化,每帧得到 196 个 token。
- 每 32 步清空上下文,把按步长采样的历史帧以原始嵌入批次重新注入。
- 实现 StreamVLN 论文描述但未随代码发布的体素空间 token 剪枝:每个 token 格取有效深度像素的中位数,反投影到体素,每个时间桶内每个体素只保留最新的 token;只在重新注入历史时执行。论文称,在全部运行的 3,252 个分块边界上,剪枝去掉了 41.7% 的重注入记忆 token,把摊销步长从 0.744 s 降到 0.672 s,SR 变化 +0.05 个百分点(1,839 个中的 1 个 episode)。
最终推理路径只有 GGUF 权重、驱动和运行时,不含深度学习框架。
LATTE:用骨干已有的隐状态判断何时停下
量化前后,SR 与 OSR 的差距几乎不变:BF16 为 7.35 个百分点,IQ4_NL 为 6.80 个百分点。OSR 统计轨迹是否在任一时刻进入过目标半径,这个差距说明约 7% 的 episode(6.80%–7.35%)轨迹进入过目标半径,却没有在其中停下。作者据此认为,停错是基础模型本身的问题,不是量化引入的。
LATTE 读取骨干第 24 层的隐状态,对每帧 196 个图像 token 做均值池化得到 3584 维特征,缓存最多 256 个决策步,经时间平均后投影到 256 维,再过两层因果掩码的 pre-norm Transformer 编码器(4 头,FFN 宽 512),输出 0 到 1 的“停止排名”。训练目标是 clip(1 − d/5.0 m, 0, 1),在最近接近点之后、以及目标未通过相机高度可见性检验时置零;用 R2R VLN-CE 训练集的 3,184 条成功轨迹特征单独训练,骨干冻结。触发器带迟滞:分数的运行最大值超过阈值、且当前值回落一定幅度时才发出 STOP,并设最少步数。头保持 FP32,在 CPU 上运行。
七个候选头的对比说明,头读的是什么特征决定了结果。基于池化视觉特征的 MLP 头把 BF16 的 SR 从 57.69% 降到 51.70%,加入指令拼接后降到 45.79%,FiLM 为 55.14%;读解码器隐状态的 MLP 头才有提升(第 20 层 58.24%,第 24 层 58.13%,各 15.7 MB)。LATTE 在 BF16 上为 58.35%,在 IQ4_NL 上为 58.02%,大小 8.2 MB。在 IQ4_NL 上,它纠正了 26 个 episode、弄坏了 13 个,SR 提高 0.71 个百分点,OSR 降低 0.65 个百分点,改变的是停止决策而不是路径。作者报告的每步额外开销为 0.013 s、0.13 J(约 +1.9% 和 +1.1%)。另有一项测量限制:作者说明,同一骨干上不同候选头之间的板上测量差异小于重复运行波动,不应互相比较;这不等于证明 LATTE 的新增开销小于该波动。
和本站已有内容的关系
《前沿雷达专题|边缘与实时性:VLA 与世界动作模型的延迟预算花在哪里》整理的 9 月材料中,实测量化省了内存、却更慢。在 EdgeVLN 里,执行路径需要逐项比较,不能把变慢视为量化本身的属性:同在 PyTorch 下,INT4 每步 21.21 s,NF4 只要 1.06 s,论文把 INT4 的耗时归因于它的反量化路径。INT2 同样较慢,每步 21.81 s、437.86 J,但其运行时未写明。作为对照的 BF16 本身也是受损的对照点:28 个 Transformer 块中有 8 个每个 token 都要从存储读取,它的 13.98 s 包含了这部分存储读取。因此,NF4 比 BF16 快约 13 倍、INT4 比 BF16 慢,都不能推广成“量化更快”或“量化更慢”。峰值常驻内存也是如此:INT4 为 15.85 GB,高于只部分常驻的 BF16(14.99 GB),NF4 为 14.70 GB,IQ4_NL 在作者驱动下为 11.35 GB。“量化会不会变快”要连同格式实现和运行时一起回答。《前沿雷达专题|仿真与评测:VLA 评测在初始状态成功率之外缺了什么》讨论过量化后的闭环验证;这篇论文按同样思路在 1,839 个闭环 episode 上评测,同时用 SR 与 OSR 的差距把停止错误单独拿出来看。课程规划中 L2 的“边缘部署中的量化、延迟与控制频率”一集(见课程介绍)和第 0.2 集中关于机载算力的讨论,都可以用这组数字作为例子:看峰值算力之外,还要看常驻内存、每步能耗和执行路径。
局限 / 注意
- 这是 arXiv 预印本,所有数字都是作者报告,本文依据的材料中没有独立复现,也没有代码仓库链接。
- SR 和 OSR 都来自仿真;板上测量是机器人静止时回放一段真实录制的 89 帧序列,不是真实闭环导航,论文没有报告真机导航成功率。功率在模组供电轨上测得,不含电机,也未扣除待机功耗。
- LATTE 触发器的阈值和回落幅度是在报告结果的同一批 val-unseen episode 上做 16 格网格搜索选出的。作者说明,由于没有留出集,这个增益应视为上界。“超过 BF16 基线”指 58.02% 对 57.69%,差 0.33 个百分点。
- 作者指出,同一骨干下不同头之间的板上测量差异小于重复运行的波动,不应互相比较;BF16 各行只跑了一次,其余配置取三次平均。
- 论文一处说体素剪枝在仅 RGB 的 VLN-CE 设置中不起作用(评测代理给编码器的是占位位姿和全零深度图),另一处又报告全部运行中剪掉了 41.7% 的重注入 token。两者如何对应,原文没有说清。
- 论文称“只有在我们的 VLN 驱动下的 IQ4_NL 能装进这块板”(only IQ4_NL under our VLN driver fits the board),但 NF4 和 INT4 也在板上跑完了回放,峰值常驻分别为 14.70 GB 和 15.85 GB,统一内存池为 16.14 GB。论文没有定义“装进”的标准,例如要给真实相机管线留多少余量、是否要求长时间持续运行,因此本文不把哪些格式“装得进”当作已定结论。
- 论文明确说明 INT4 和 NF4 在 PyTorch 下运行,IQ4_NL 在作者的 llama.cpp 驱动下运行;INT8 和 BF16 的运行时没有写清楚。因此表中各格式的差异同时包含格式和运行时两方面的因素。
链接
- arXiv 2609.35570:EdgeVLN: Runtime-Aware Deployment Ready Quantized Vision Language Navigation Model(作者:Rithvik Jonna、Man Namgung、Aakash Gurram、Tinoosh Mohsenin)
- 论文 HTML 全文


