
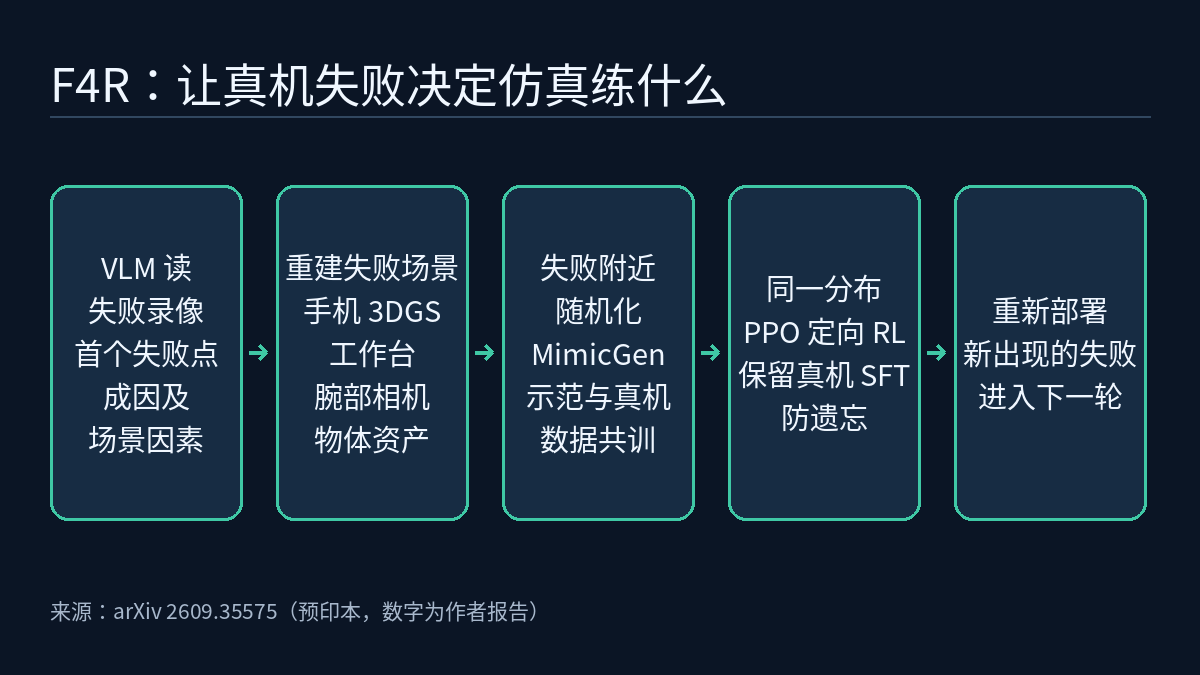
VLA 策略部署到真机后会在示范没覆盖到的条件下失败,常见的补救是针对这些失败再采一批真机纠正示范。南洋理工大学、西安交通大学与 Dexmal 的作者提出的 F4R(Failure for Rising,arXiv 2609.35575,2026-09-28,证据等级 [R])换了一种做法:让一个 VLM 智能体从失败录像里找出最早的失败点和相关场景因素,把这个失败重建成可交互的仿真场景,只在失败附近做随机化和训练,再把新策略部署回去,新出现的失败进入下一轮。这篇论文值得看的地方在于,它和两个基线都按一小时的数据准备时间对齐,并且单独测了“随机化该放在哪里”这件事本身的影响。
闭环的四步
- 识别与诊断:一个按任务定制的二元成功判定器先把失败的 rollout 挑出来。F4R 在腕部相机和固定外部相机两路视频上按画面变化提出少量候选时间窗,排成按时间排序的“证据板”,交给 VLM 诊断智能体。智能体输出结构化的失败记录:最早失败时刻、相关物体、失败的子任务与失败类型、与失败相关的场景因素(如位姿、摩擦、光照、背景、视角、杂物)、逐帧证据和置信度。这条记录决定重建什么、随机化哪些变量。
- 重建:工作台用手机拍一段 RGB 视频,以 3D Gaussian Splatting 重建后配准进 Isaac Sim,这是一次性工作,也是作者所说全流程中唯一需要人协助的环节。每个相关物体由机器人自己用腕部相机采多视角 RGB-D,经 TSDF 融合、ShapeR 补全几何、Hunyuan3D 生成 PBR 材质,得到既能做物理仿真、又能照片级渲染的资产;铰接物体再用 VLM 与 P3-SAM 恢复部件运动结构。
- 两阶段微调:先围绕重建场景做“失败感知”的域随机化,与失败相关的变量在恢复出的配置附近采样,其他变量固定。第一阶段用历史真机成功轨迹作种子,由 MimicGen 在这些随机化场景里生成纠正示范,与原始真机数据共训;第二阶段在同一分布上跑 PPO,只用原始任务奖励,不做针对失败的奖励塑形,并保留一项真机数据的 SFT 损失以防遗忘。
- 再部署:新策略在旧失败和新配置上重新测试,仍然失败或新出现的失败进入下一轮。
预算对齐的比较
平台是 UR5 加 Robotiq 2F-85 夹爪、两台 RealSense D435i,策略从 π0.5 初始化并微调 LoRA。作者定义的 ID 是原始采集分布覆盖的配置,OOD 是部署中出现、但原始分布里没有的失败条件;真机每个设置 20 次试验。三种方法都给一小时:Targeted BC 用这一小时在真实失败分布上采纠正示范;RLinf-Co 和 F4R 用 50 分钟做重建、10 分钟在 256 个并行环境里收集仿真经验。作者说明,场景重建实际花 25–30 分钟、物体准备 5–10 分钟,场景只在物理工作台变化时才需要重做。RLinf-Co 与 F4R 架构、训练设置和 rollout 预算相同,唯一区别是 RLinf-Co 用宽泛的域随机化,F4R 把随机化集中在诊断出的失败附近。
| 方法(四个任务平均,真机) | ID | OOD |
|---|---|---|
| Base | 62.5% | 26.25% |
| Targeted BC | 91.25% | 71.25% |
| RLinf-Co | 87.5% | 77.5% |
| F4R | 93.75% | 90.0% |
论文称,F4R 在 OOD 上比 Targeted BC 高 18.75 个百分点,比 RLinf-Co 高 12.5 个百分点。差距最明显的是多阶段的“把积木放进抽屉”:抽屉朝向和原始示范不同时,基础策略的关抽屉动作全部失败(OOD 0%),Targeted BC 为 60%,RLinf-Co 和 F4R 为 80% 和 85%。作者据此认为,监督微调得到的 VLA 学的是特定朝向的动作模式,而不是可迁移的抽屉运动学,仿真交互对这类接触敏感的动作更有用。作者还提到 RLinf-Co 的训练损失已经收敛,认为剩下的差距不是优化不足造成的;作者推测,宽泛随机化可能扩大 sim-to-real 差距,并稀释失败附近的训练。这是作者的推测,不是单独验证过的结论。
哪一部分贡献最大
| 变体(四个任务平均,真机) | ID | OOD |
|---|---|---|
| 去掉失败诊断(改用宽泛随机化) | 87.5% | 77.5% |
| 去掉真机数据监督 | 85% | 86.25% |
| 去掉第一阶段共训(RL + 真机 SFT 辅助项) | 76.25% | 32.5% |
| 去掉第二阶段 RL(只做共训) | 90% | 83.75% |
| 完整 F4R | 93.75% | 90% |
三点读法:一是跳过第一阶段、只用稀疏奖励 RL(仍保留真机 SFT 项)时 OOD 只从 26.25% 升到 32.5%,作者认为基础策略在严重失败区域里很难靠探索碰到成功,大部分收益来自第一阶段的纠正示范,RL 再补 3.75(ID)和 6.25(OOD)个百分点。二是去掉真机数据监督后 ID 降 8.75 个点、OOD 只降 3.75 个点,作者的解读是仿真数据负责修弱点,真机数据主要防遗忘。三是“去掉失败诊断”一行与上表 RLinf-Co 的数字相同,都是 87.5% / 77.5%。两者与完整 F4R 的区别都只在随机化放在哪里(宽泛随机化而不是集中在诊断出的失败附近),与完整 F4R 相比,ID 低 6.25 个百分点,OOD 低 12.5 个百分点。本文所读的正文没有说明这两行是否来自同一次运行。
诊断和仿真靠不靠得住
F4R 的闭环有两处不经人手,作者分别做了检查:
- 自动诊断:8 个任务各 10 条轨迹,共 80 条,人工标注失败阶段和原因,由配了作者 robot-video-failure-analyzer skill 的 GPT-5.5 预测,两项都对才算正确。第一次尝试对 69 条(86.25%),两次以内对 74 条(92.5%);剩下 6 条中 4 条是细微的相机视角偏移,2 条是光照变化。在公开的 ViFailback 数据集上,不做任务适配时表现最好的 GPT 模型准确率接近 70%。
- 仿真与真机的一致性:8 个任务各用 10、30、50 条真机示范训练,共 24 个 checkpoint,在仿真和真机上按相同配置评测。论文称两者成功率的 Pearson 相关系数 r = 0.7625(p = 1.49×10⁻⁵)。作者也写明,偏离对角线的部分来自外观、接触动力学和执行敏感度上的残余差距,仿真成功率不能当作真机成功率的精确估计,只能作为排序意义上的行为代理。
多轮闭环方面,作者在两个任务上连续做了三轮:“叠碗”从 30% 依次升到 80%、90%、95%;“拾取水果”第一轮就从 40% 升到 100%,后两轮保持。
和本站已有内容的关系
《前沿雷达专题|仿真与评测》包含对策略在任务中途出错后能否恢复的评测;F4R 关注的是失败发生之后,怎样把它变成下一轮训练数据。《前沿雷达专题|训练与自我改进》把“从部署经验中学习”列为 VLA 后训练的第三个阶段,F4R 是这一阶段的一个具体实现,而且让部署失败同时决定仿真生成什么、RL 在哪里探索。与《前沿雷达|VLaRL》相比,两者都在仿真中用 RL 训练 VLA 策略,但 VLaRL 冻结 VLA、只学残差,F4R 则直接更新 π0.5 的 LoRA 适配器。课程大纲中 L2 规划的 sim2real 域随机化一集,可以把这里“去掉失败诊断”的消融当作一个具体例子:随机化范围本身就是一个需要设计和检验的变量。
局限 / 注意
- 这是 arXiv 预印本,所有数字都是作者报告;本文依据的材料中没有独立复现。
- 这里的 OOD 指部署中已观察到、并被 F4R 拿去重建和训练的失败条件,相对原始示范分布而言是分布外,对 F4R 本身并不是未见过的条件;Targeted BC 同样在这个失败分布上采数据。
- 真机每个设置 20 次试验,正文没有给出置信区间或显著性检验;单个任务上 5 个百分点的差距只相当于 1 次成功。
- “不需要额外真机纠正示范”不等于不用真机数据:第一阶段以历史真机成功轨迹作 MimicGen 种子(不足时用 AnyGrasp 补抓取候选),训练中始终保留真机 SFT 项,工作台重建需要一次人工手机拍摄,失败判定依赖按任务编写的成功判定器。
- 诊断评测使用的是闭源模型 GPT-5.5;作者承认剩余错误集中在需要跨帧比较的细微视觉变化上。
- 实验限于单臂桌面操作,策略实验只覆盖四个任务,多轮闭环只在两个任务上做了三轮。


