
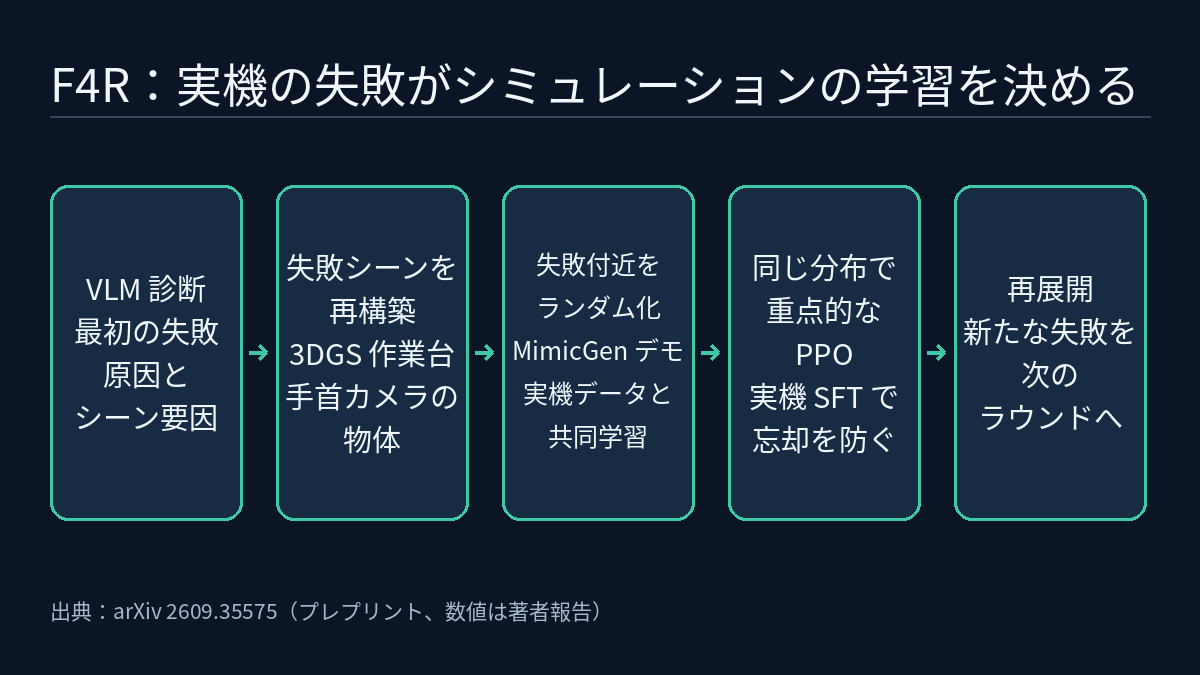
VLA 方策を実機に展開すると、デモが網羅していない条件で失敗します。よくある対処は、その失敗に合わせて実機の修正デモをもう一度集めることです。南洋理工大学、西安交通大学、Dexmal の著者らによる F4R(Failure for Rising、arXiv 2609.35575、2026-09-28、証拠レベル [R])は別の方法をとります。VLM エージェントが失敗動画から最初の失敗箇所と関連するシーン要因を特定し、その失敗をインタラクティブなシミュレーションシーンとして再構築し、失敗の周辺に絞ってランダム化と学習を行い、新しい方策を再展開します。新たに現れた失敗は次のラウンドに回されます。この論文の見どころは、2 つのベースラインとデータ準備時間 1 時間で条件を揃えたうえで、「ランダム化をどこに置くか」そのものの効果を別に測っている点です。
ループの 4 段階
- 認識と診断:タスクごとの二値の成功判定器が、まず失敗した rollout を選び出します。F4R は手首カメラと固定の外部カメラの 2 系統の動画から、画面の変化にもとづいて少数の候補時間窓を提案し、時系列順に並べた「証拠ボード」として VLM 診断エージェントに渡します。エージェントは構造化された失敗記録を出力します。内容は、最初の失敗時刻、関係する物体、失敗したサブタスクと失敗の種類、失敗に関係するシーン要因(姿勢、摩擦、照明、背景、視点、雑多な物など)、フレームに紐づいた証拠、信頼度です。この記録によって、何を再構築し、どの変数をランダム化するかが決まります。
- 再構築:作業台はスマートフォンで短い RGB 動画を 1 回撮影し、3D Gaussian Splatting で再構築して Isaac Sim に位置合わせします。この 1 回限りの作業が、著者によればパイプライン全体で唯一人の手を借りる段階です。関係する各物体は、ロボット自身が手首カメラで多視点 RGB-D を取得し、TSDF 融合、ShapeR による形状補完、Hunyuan3D による PBR マテリアル生成を経て、物理シミュレーションとフォトリアルなレンダリングの両方に使えるアセットになります。関節を持つ物体は、VLM と P3-SAM でパーツ単位の運動構造を復元します。
- 2 段階の方策改善:まず再構築シーンを「失敗を考慮した」ドメインランダム化で広げます。失敗に関係する変数は復元した設定の周辺でサンプリングし、それ以外は固定します。第 1 段階では、過去の実機での成功軌跡をシードとして MimicGen がランダム化シーンで修正デモを生成し、元の実機データと共同学習します。第 2 段階では同じ分布で PPO を実行し、報酬は元のタスク報酬だけで失敗専用の報酬整形は行いません。忘却を防ぐため、実機データの SFT 損失を残します。
- 再展開:新しい方策を以前の失敗と新しい設定で再評価し、残った失敗や新たに現れた失敗を次のラウンドに回します。
予算を揃えた比較
プラットフォームは UR5、Robotiq 2F-85 グリッパー、RealSense D435i 2 台で、方策は π0.5 から初期化して LoRA アダプターを微調整します。著者は、元のデータ収集分布が網羅する設定を ID、展開中に現れたが元の分布にはない失敗条件を OOD と定義しています。実機では各設定 20 回試行します。3 手法とも 1 時間が与えられ、Targeted BC はこれを実際の失敗分布での修正デモ収集に使い、RLinf-Co と F4R は 50 分を再構築に、10 分を 256 並列環境でのシミュレーション経験の収集に使います。著者によれば、シーン再構築は実際には 25~30 分、物体の準備は 5~10 分で、シーンの作り直しは物理的な作業台が変わったときだけ必要です。RLinf-Co と F4R はアーキテクチャ、学習設定、rollout 予算が同じで、違いは RLinf-Co が広いドメインランダム化を使い、F4R が診断した失敗の周辺にランダム化を集中させる点だけです。
| 手法(4 タスク平均、実機) | ID | OOD |
|---|---|---|
| Base | 62.5% | 26.25% |
| Targeted BC | 91.25% | 71.25% |
| RLinf-Co | 87.5% | 77.5% |
| F4R | 93.75% | 90.0% |
論文によれば、F4R は OOD で Targeted BC を 18.75 ポイント、RLinf-Co を 12.5 ポイント上回ります。差が最も大きいのは多段階の「ブロックを引き出しに入れる」タスクです。引き出しの向きが元のデモと異なると、ベース方策は閉める動作にすべて失敗し(OOD 0%)、Targeted BC は 60%、RLinf-Co と F4R はそれぞれ 80% と 85% でした。著者はこれを、教師あり微調整した VLA が転用できる引き出しの運動学ではなく向きに固有の動作パターンを学んでおり、こうした接触に敏感な動作にはシミュレーションでのインタラクションが特に役立つ、と解釈しています。また、RLinf-Co の学習損失は収束していることから、残る差は最適化不足によるものではないとし、広いランダム化が sim-to-real のギャップを広げ、関連する失敗周辺の学習を薄めた可能性があると推測しています。これは著者の推測であり、別途検証された結論ではありません。
どの部分の寄与が大きいか
| バリアント(4 タスク平均、実機) | ID | OOD |
|---|---|---|
| 失敗診断なし(代わりに広いランダム化) | 87.5% | 77.5% |
| 実機データによる教師信号なし | 85% | 86.25% |
| 第 1 段階の共同学習なし(RL+実機 SFT 補助項のみ) | 76.25% | 32.5% |
| 第 2 段階の RL なし(共同学習のみ) | 90% | 83.75% |
| F4R(全体) | 93.75% | 90% |
読み取れる点は 3 つです。第一に、第 1 段階を省きスパース報酬の RL だけを使う場合(実機 SFT 項は残したまま)、OOD は 26.25% から 32.5% にしか上がりません。著者は、深刻な失敗領域ではベース方策が探索だけで成功にたどり着くことはまれで、利得の大部分は第 1 段階の修正デモによるものであり、RL がさらに 3.75(ID)と 6.25(OOD)ポイントを上乗せするとしています。第二に、実機データの教師信号を外すと ID は 8.75 ポイント下がる一方、OOD は 3.75 ポイントしか下がりません。著者はこれを、シミュレーションのデータが弱点を修正し、実機データは主に忘却を防ぐと読んでいます。第三に、「失敗診断なし」の行は上の表の RLinf-Co と同じ 87.5% / 77.5% です。どちらも F4R(全体)との違いはランダム化をどこに置くか(診断した失敗の周辺に集中させず、広く取る)だけで、F4R(全体)より ID で 6.25 ポイント、OOD で 12.5 ポイント低くなっています。この 2 行が同じ実行によるものかどうかは、本記事で読んだ本文には書かれていません。
診断とシミュレーションはどこまで信頼できるか
F4R のループには人手を介さない部分が 2 つあり、著者はそれぞれを検証しています。
- 自動診断:8 タスクから各 10 本、計 80 本の軌跡に失敗段階と原因を人手でラベル付けし、著者の robot-video-failure-analyzer skill を備えた GPT-5.5 に両方を予測させました。両方が一致した場合のみ正解とします。1 回目の試行で 69 本(86.25%)、2 回以内で 74 本(92.5%)が正解でした。残る 6 本のうち 4 本はわずかなカメラ視点のずれ、2 本は照明の変化によるものです。公開データセット ViFailback では、タスク固有の調整なしで最も成績のよい GPT モデルの正解率が 70% 近くでした。
- シミュレーションと実機の一貫性:8 タスクそれぞれについて実機デモ 10、30、50 本で方策を学習し、計 24 個のチェックポイントをシミュレーションと実機で同じ設定のもとで評価しました。論文は両者の成功率の Pearson 相関係数を r = 0.7625(p = 1.49×10⁻⁵)と報告しています。著者は、対角線からのずれは外観、接触ダイナミクス、実行時の感度に残るギャップを反映したもので、シミュレーションの成功率は実機成功率の正確な推定値ではなく、順位づけの意味での行動の代理指標にとどまるとも明記しています。
複数ラウンドのループについては、2 つのタスクで 3 サイクル連続して実施しました。「ボウルを重ねる」は 30% から 80%、90%、95% と上がり、「果物を拾う」は 1 サイクル目で 40% から 100% になり、その後の 2 サイクルでも維持されました。
本サイトの既存記事との関係
「フロンティア・レーダー特集|シミュレーションと評価」には、作業の途中で問題が起きたときに方策が立て直せるかの評価が含まれます。F4R が扱うのは、失敗が起きたあとに、それを次のラウンドの学習データにどう変えるかです。「フロンティア・レーダー特集|学習と自己改善」は、デプロイ経験からの学習を VLA ポストトレーニングの第 3 段階に位置づけています。F4R はこの段階の具体的な実装の 1 つで、展開時の失敗がシミュレーションで何を生成するかと、RL がどこを探索するかの両方を決めます。「フロンティア・レーダー|VLaRL」と比べると、どちらも VLA 方策に対してシミュレーションで RL を用いますが、VLaRL は VLA を凍結して残差だけを学習するのに対し、F4R は π0.5 の LoRA アダプターを直接更新します。講座の全体計画で L2 に予定されている sim2real のドメインランダム化の回では、ここでの「失敗診断なし」のアブレーションが具体例になります。ランダム化の範囲そのものが、設計と検証を要する変数だということです。
制約と注意点
- arXiv のプレプリントであり、数値はすべて著者報告です。本記事が依拠した資料には独立した再現は含まれていません。
- ここでの OOD は、展開中に観察され、F4R が再構築と学習に使った失敗条件を指します。元のデモ分布に対しては分布外ですが、F4R 自身にとって未知の条件ではありません。Targeted BC も同じ失敗分布でデータを集めています。
- 実機は各設定 20 回の試行で、本文には信頼区間や有意性検定がありません。1 タスクでの 5 ポイントの差は成功 1 回分にすぎません。
- 「追加の実機修正デモが不要」は実機データを使わないという意味ではありません。第 1 段階では過去の実機成功軌跡を MimicGen のシードに使い(足りない場合は AnyGrasp の把持候補で補う)、学習中は常に実機データの SFT 項を残します。作業台の再構築にはスマートフォンでの手動撮影が 1 回必要で、失敗の判定はタスクごとに用意した成功判定器に依存します。
- 診断の評価にはクローズドなモデル GPT-5.5 を使っています。著者は、残る誤りがフレーム間の比較を要する微妙な視覚的変化に集中していることを認めています。
- 実験は単腕の卓上操作に限られ、方策の実験は 4 タスク、複数ラウンドのループは 2 タスクで 3 サイクルのみです。


