
NVIDIA 在 2026 年 5 月发布的 Cosmos 3,把此前分开的 Cosmos Predict、Cosmos Transfer 和 Cosmos Reason 三个模型合成一个:一次推理调用,同时给出场景推理、未来画面和机器人动作。AWS Physical AI 博客 2026-09-28 的文章(证据等级 [O],厂商一手)拆解了它的双塔结构,并给出从数据整理到端侧部署的 AWS 参考架构和实例选型。对工程团队来说,最有用的是实例选型附带的验证条件:完整的 Nano 和 Super 检查点目前在 BF16 下测试;H100 上的 8 卡 SFT 是 NVIDIA 测试过的配置;H200 多节点后训练应对照这套 H100 配方做基准;在 B200 上应先验证切分或复制布局,再给出性能结论。
从三个模型到一个模型
按文章的说法,早期 Cosmos 需要编排三个独立模型,每个都有自己的推理调用、模型加载开销和服务设施。传统的物理 AI 流水线则把多个专用模型串起来:视觉-语言模型先把场景写成文字,文字再去驱动视频生成模型,生成的画面最后交给策略网络输出电机指令。文章认为,每次交接都会丢失上下文、增加延迟。它举的例子是仓库拣选:VLM 把包裹描述成“传送带上一个变形的纸箱”,表面曲率和与邻近物体的距离就在这句话里丢掉了。Cosmos 3 被描述为在一次前向中完成感知、推理抓取稳定性、生成轨迹和输出指令,全程不经过文字这个中间瓶颈。NVIDIA 称它是第一个完全开放的物理 AI omni 模型。
文章列出的能力包括:视觉语言理解(文本、图像、视频、音频)、世界模型(以视频形式生成未来状态)、世界动作模型(输出关节角、夹爪位置等可执行轨迹)、前向动力学(给定动作预测未来观测)、逆向动力学(从示范中推断动作)和策略模型(由观测和任务提示预测动作序列)。三个规格如下:
| 规格 | 参数量 | 文章给出的典型用途 |
|---|---|---|
| Cosmos 3 Super | 64B(32B Reasoner + 32B Generator) | 最高保真度仿真、研究、离线生成 |
| Cosmos 3 Nano | 16B(8B Reasoner + 8B Generator) | 生产推理,成本与质量折中 |
| Cosmos 3 Edge | 4B | 机器人端侧推理、低延迟控制回路 |
双塔结构:推理塔与生成塔
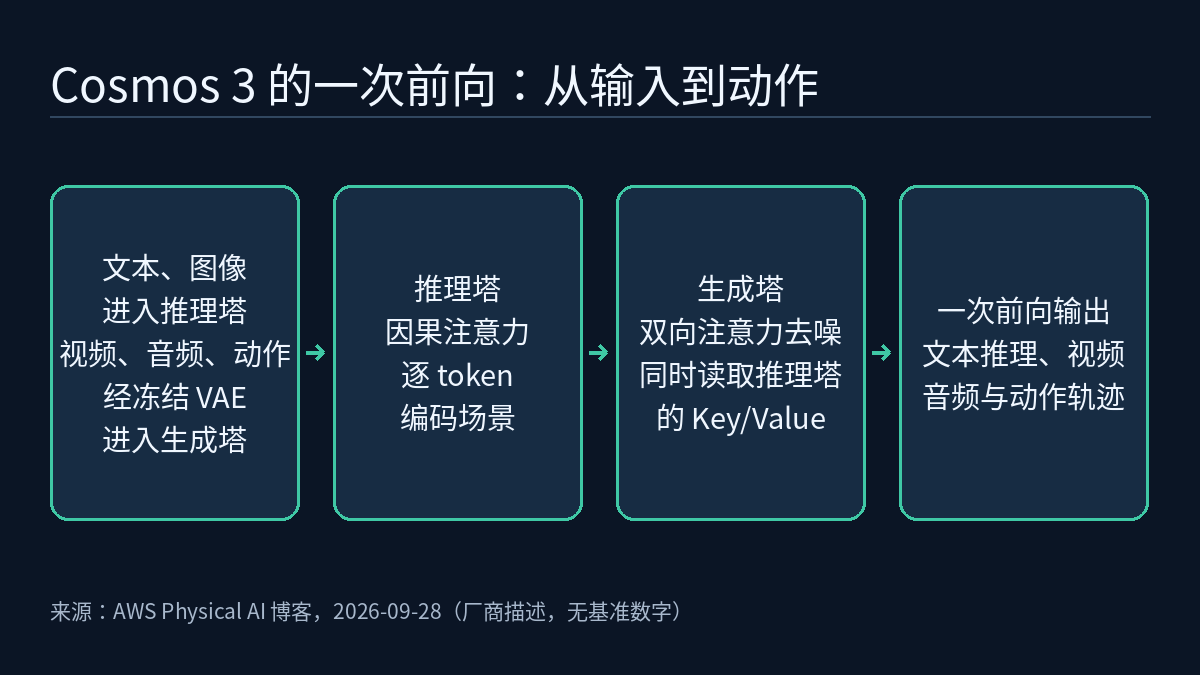
Cosmos 3 采用 Mixture-of-Transformers(MoT),把自回归推理和基于扩散的生成放进一个联合训练的模型。文章描述的数据流是:
- 输入分两路。文本和经 ViT 编码的图像 patch 组成自回归子序列,进入推理塔;视频、音频和动作经冻结的 VAE 编码器压成潜变量,进入扩散塔。3D 多模态 RoPE(MRoPE)把所有 token 对齐到同一条物理时间轴上,并按 FPS 调制以适应不同帧率。
- 推理塔用因果自注意力从左到右处理视觉与语言 token(ViT 带 DeepStack 多层聚合),输出编码场景推理的稠密表示。
- 生成塔用双向注意力在全局处理 token,通过迭代去噪把潜变量还原成视频、同步音频和动作轨迹。
- 双流联合注意力:扩散 token 的注意力同时覆盖两座塔拼接后的 Key/Value,因此每个生成的像素、音频采样和动作坐标都以推理结果为条件;自回归 token 仍保持因果、自成一体。
- 一次前向同时输出文本推理、视频、音频和动作轨迹(关节角、夹爪指令、6-DoF 路径)。
放在本站课程 0.1 讲的“看-想-动”闭环里看,这套设计是把“想”和“动”之间的模型交接省掉。需要注意,文章只描述了结构,没有给出与多模型流水线对比的延迟或成功率数字,“交接会丢信息”是作者的论证,不是测量结果。
在 AWS 上的四个阶段与两种部署方式
文章的参考架构覆盖完整生命周期:
- 数据整理:原始视频、LiDAR 和相机数据落到 Amazon S3;Cosmos Curator 在 AWS Batch 上做过滤、去重和质量打分;Cosmos Dataset Search 部署在 Amazon EKS 上,用 Milvus 向量库和 Cosmos-embed NIM 做语义检索。
- 后训练:在 Amazon SageMaker HyperPod 上做领域 SFT;动作后训练让动作头适配具体机器人的关节配置、夹爪映射和 6-DoF 末端路径。文章称可用模型自带的前向动力学在上真机前做闭环测试。
- 生产推理:Amazon EKS + Cosmos NIM,或 Amazon SageMaker JumpStart。
- 端侧:Cosmos 3 Edge(4B)经 AWS IoT Greengrass 部署到 NVIDIA Jetson,OTA 推送模型更新,端侧传感器数据回流 S3 用于再训练。
两种推理方式的取舍很清楚。EKS + NIM 面向控制回路、实时场景理解等低延迟负载:Karpenter 按需拉起 GPU 节点,多可用区放置,新版 NIM 镜像通过健康检查后才接流量,GPU 利用率、队列深度和单请求延迟进入 CloudWatch 与 Prometheus 驱动横向扩缩,适合已经在运维 Kubernetes、需要自己控制批处理和 GPU 装箱的团队。JumpStart 是托管路径:据文章,截至 2026 年 8 月 Edge、Nano、Super 三个规格都已上架;实时端点处理交互请求,异步端点处理耗时较长的世界生成任务,避免客户端超时;HyperPod 产出、登记到 SageMaker Model Registry 的检查点可以部署到同一类端点。
安全方面,文章写明的做法包括:S3 全部用 SSE-KMS 加密;为 S3/ECR 配 VPC 端点,不走公网;HyperPod 集群和 EKS 节点组放在私有子网;IAM 角色按整理、训练、推理、端侧四个阶段分别授权;端侧设备用设备证书认证并定期轮换,OTA 只接受签名的模型制品;对客户数据或安全关键数据使用 PrivateLink,并对模型制品的每次晋级开启 CloudTrail 记录。
实例选型:文章自己留的保留条件
文章特别说明,完整的 Nano 和 Super 检查点目前在 BF16 下测试;Cosmos3 Generator NIM 另有 FP8 配置,内存和并行需求不同。
| 负载 | 推荐实例 | 文章的说明 |
|---|---|---|
| Nano 单卡推理 | g7e.2xlarge 或 p5.4xlarge | 一张 RTX PRO 6000 96 GB 或 H100 80 GB;完整检查点用 BF16,FP8 可用于受支持的 NIM 配置 |
| Nano 吞吐或后训练 | p5.48xlarge | 8 张 H100,与 NVIDIA 测试过的 8 卡 SFT 配置一致 |
| Super 完整推理 | p5e.48xlarge 或 p5.48xlarge | 按运行时推荐的 HSDP、CFG、Ulysses 布局,不要默认 TP8;H200 内存余量更大 |
| 多节点后训练 | p5en.48xlarge | 8 张 H200 + EFAv3,适合 NCCL 集合通信,但要对照 NVIDIA 测试过的 H100 配方做基准 |
| Blackwell 推理或训练 | p6-b200.48xlarge | 8 张 B200,合计 1,432 GiB 显存;先验证运行时的切分或复制布局,再谈性能 |
表中的条件措辞各不相同。文章明确称为 NVIDIA 测试过的,是 H100 上的 8 卡 SFT 配置;H200 多节点后训练应对照这套 H100 配方做基准;B200 上应先验证运行时的切分或复制布局,再给出性能结论。FP8 可用于受支持的 NIM 配置,文章未说明其测试范围。文章也没有说明 BF16 测试由谁完成,或其他配置是否测试过。端侧部分,本站《前沿雷达专题|边缘与实时性》整理了 NVIDIA 关于 Cosmos 3 Edge 端侧机器人控制后训练的教程及其他延迟数据;HyperPod 上做 VLA 后训练的经验,见《前沿雷达专题|训练与自我改进》。
局限 / 注意
- 这是 AWS 的厂商博客([O]),关于模型能力的说法来自 NVIDIA 的描述;全文没有任何质量、延迟或成功率的基准数字,本文依据的材料里也没有独立评测。“第一个完全开放的 omni 模型”是 NVIDIA 的自述。
- 文章的结构小节标题有误:第 1 项讲输入分流,却与第 2 项同样标为“Autoregressive Tower (Reasoning)”。本文按内容把第 1 项理解为输入处理。
- Edge 规格只给了 4B 总参数,没有像 Nano、Super 那样拆分推理器和生成器。
- “部署前用前向动力学闭环验证策略”是在模型自己的预测里验证,能否代替真机评测,文章没有讨论。
- 文末的 GitHub 仓库和示例代码链接不在本文依据的材料里,本文未引用;文章中的 GPU 降价幅度、Spot 节省比例等成本说法也未收录,价格请以 AWS 官方定价为准。
链接
- AWS Physical AI Blog:NVIDIA Cosmos 3 on AWS: Omnimodal World Models for Physical AI(2026-09-28)
- 物理AI实验室 0.1:什么是物理 AI,从会聊天到会动手(“看-想-动”闭环)
- 物理AI实验室课程大纲(L3 规划有“用 Cosmos 做世界模型数据生成”一集)
- 前沿雷达专题|边缘与实时性:VLA 与世界动作模型的延迟预算花在哪里
- 前沿雷达专题|训练与自我改进:VLA 后训练的三个阶段与在线 RL 的 task collapse


