用大模型做机器人 agent,可以让它看画面、拆子任务、在失败后想办法,但每一步都问它,token 和等待时间会一直累积。预印本 RoC(Reasoning on Call,arXiv 2611.26341,2026-11-19,武汉大学、中关村学院、三星等机构)让一个学出来的任务状态监控器判断什么时候值得请推理 agent 复核,其余时间由低层策略照常执行。以下数字均为作者报告 [R],本站没有复现。
本站 物理AI实验室 3.4 讲过长程任务里单步成功率和整条链成功率的区别,以及编排器怎样用进度表记住做到了哪一步。RoC 把“进度”做成一个在线估计的量,再用它决定高层什么时候介入。此前的雷达文章讨论过让 GPT-6 Astra 直接控制机械臂(GPT-GEAR),以及把部分家务任务整体交给 agent(One Policy for 100 Household Tasks);RoC 处理的是同一个回合里 agent 应该在哪些时刻出现。
三个组件和一个循环
RoC 由低层策略、在线任务状态监控器和推理 agent 组成。实验中低层策略用预训练的 FastWAM 初始化,每次用 50 步扩散去噪预测 32 步动作块,输入是当前子任务指令、机器人状态和三帧图像(初始帧、当前子任务中的一帧近期画面、当前帧)。监控器从通用机器人奖励模型 Robometer 初始化。agent 是 GPT-6.1 Sol(xhigh)。
回合开始时,监控器根据任务指令和初始画面提出第一个子任务,agent 确认后策略才开始执行。之后每一步,策略提出一个动作块,RoC 先检查是否触发复核:没有触发,就执行动作块开头的一段(论文称执行前缀)再取新观测;触发了,就扣下相关动作交给 agent。两次 agent 调用之间,监控器照常查询,策略照常执行。
监控器输出什么
- 进度
p_t:当前子任务的完成程度。进度头在 [0, 1] 内十个离散值上给出分布,取期望作为标量。 - 切换请求概率
s_t:由同一个隐状态上的另一个头直接预测。 - 候选后继子任务或任务结束:由自回归语言生成分支给出,只在
s_t超过阈值时才生成。
监控器的输入是任务指令、当前子任务、按执行顺序记录的交互记忆和选出的历史画面。画面按阶段采样:从回合开始到当前子任务开始稀疏均匀采样,作为场景参照;当前子任务内密集采样,捕捉局部变化。交互记忆的每条记录包含子任务指令、已执行动作、结果描述和对应观测的时间戳,只有经过 agent 核实的记录才写入。子任务切换在时间上很稀疏,训练时作者把标注边界附近的采样间隔减半,让监控器多见切换前后的状态。监控器在 RMBench 全部九个任务上训练一个 epoch。作者测得监控器不生成子任务时为 7.10 Hz,生成子任务时为 0.53 Hz,整体吞吐 2.77 Hz。
三类触发,五种处理
触发 agent 复核的事件有三类:
- 切换事件:
s_t超过请求阈值。候选后继只是提议,本身不会完成切换。 - 进度事件:同一子任务内
p_t明显下降、反复振荡或停滞。实现上先用中值滤波平滑,在 64 步回看窗口内判断:下降阈值为 0.2;进度范围超过 0.25 且有效变化方向反转超过三次算振荡;范围保持在 0.1 以内算停滞。 - 关键接触事件:动作块里出现夹爪闭合或放置释放之前,检查物体身份、相对几何关系和交互前提。
agent 读同一份任务与执行上下文,判断要修执行、改计划,还是两者都做。修执行有三种方式:缩短执行前缀(agent 可批准 1–32 步)、局部修正末端位姿或夹爪指令(1–5 步)、直接接管子任务直到结果得到核实。改计划有两种:拒绝切换,保留未完成的子任务;替换不合适的候选后继。都不需要时,agent 批准策略继续。子任务是否完成由 agent 核实并写出结果描述,后继获批后才写入交互记忆、提交切换。接管期间策略指令暂停,结束后 RoC 丢弃过期动作,用新观测重新生成动作块。
RMBench:成功率和 token
RMBench 是依赖记忆的操作基准,九个任务分两类:M(1) 要记住某个关键的过去观测(例如物体初始位置),M(n) 要跟踪多次过去的交互(例如之前的尝试或已完成的操作)。与 agent 方法比较时每个任务做 30 次独立试验;对照的 Direct Control 和 GPT-as-Policy 混合模式保留原配置,使用 GPT-6 Astra(xhigh)。论文表 1 的九任务平均值如下:
| 方法 | 平均成功率(%) | 每回合平均 token(× 10⁴) |
|---|---|---|
| Direct Control | 71.9 | 1845.1 |
| GPT-as-Policy | 75.6 | 830.3 |
| RoC | 99.6 | 288.3 |
据此,RoC 比 GPT-as-Policy 高 24.0 个百分点、token 少 65.3%,比 Direct Control 高 27.7 个百分点、token 少 84.4%。token 的节省在任务之间差别很大:Cover Blocks 上 RoC 为 131.1,GPT-as-Policy 为 2123.9;Observe and Pick Up 上两者分别为 391.0 和 409.0,几乎没有节省。图 4 的一个示例回合里,RoC 调用 agent 46 次,GPT-as-Policy 84 次,Direct Control 209 次。
按每个任务 30 次推算(本站计算),每种方法共 270 次试验,75.6% 和 99.6% 约为 204 次和 269 次成功,本站按正态近似估算两者差值的 95% 区间半宽约 5.2 个百分点,24.0 个百分点的差在这个范围之外。但这组比较同时换了 agent 模型(GPT-6 Astra 对 GPT-6.1 Sol),论文正文没有给出两边使用同一模型的对照,因此本站无法把差距全部归于触发机制。
与策略方法比较时每个任务做 100 次试验(表 2)。RoC 平均 98.1%,最强的策略基线 MemoryWAM 为 83.0%,差 15.1 个百分点;只用 FastWAM 为 5.9%,π0.5 为 10.4%。Blocks Ranking Try 一项 MemoryWAM 为 100.0%,RoC 为 98.0%。表 2 没有 token 列,策略基线本身不调用 agent,这组比较不是在相同计算开销下做的。同一个 RoC 在表 1 和表 2 的平均值不同(99.6% 和 98.1%),两表的试验次数也不同(30 次和 100 次)。
消融和真机
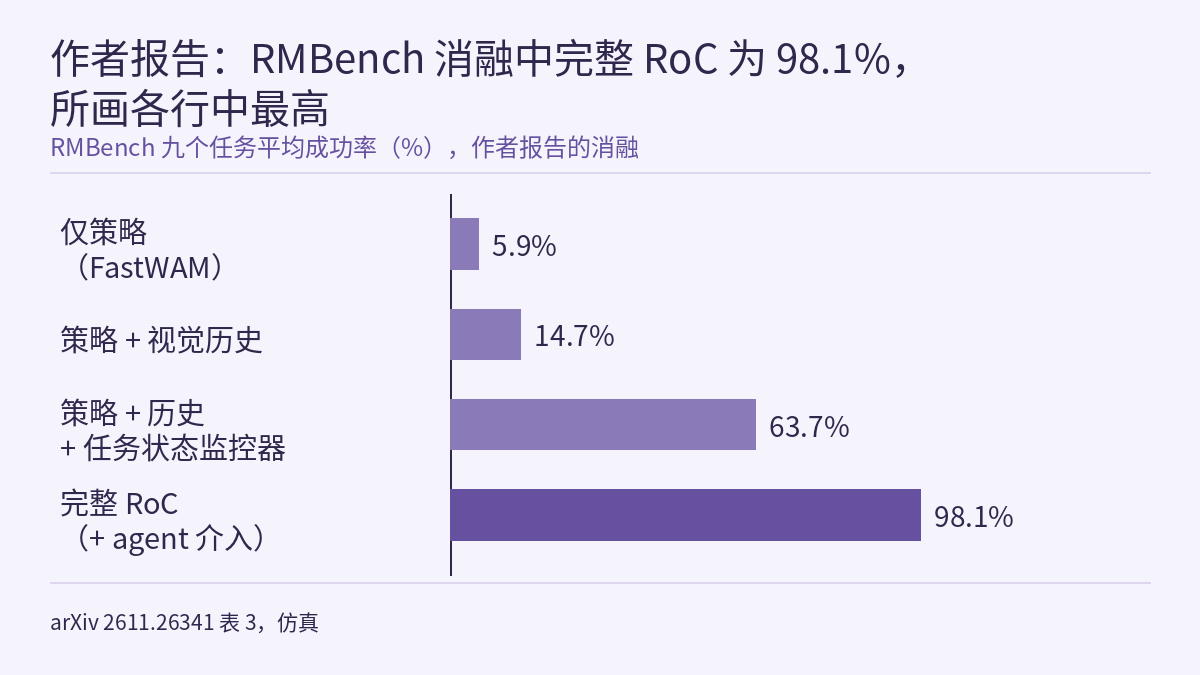
论文表 3 逐层加入组件:只用 FastWAM 为 5.9%;加视觉历史为 14.7%;再加监控器、按预测的子任务指令执行为 63.7%;再加事件触发的 agent 介入,即完整 RoC,为 98.1%。只有监控器时 M(n) 任务平均 51.0%,加入 agent 后为 97.3%。作者的解读是:监控器给出任务状态估计和切换提议,agent 负责核实执行结果,并在需要时同时修执行和改计划。这组消融每次只加一层,读法与 3.4 里“只换一层、看整条链成功率怎样变”的对照相同;正文没有写出这组消融的试验次数,也没有给出区间。
真机实验用 5 自由度的 SO-ARM101,配一个固定的外部 RGB 相机和一个腕部 RGB 相机,三个任务各做 10 次:Drawer Sorting(先看颜色与抽屉层的对应关系,关上抽屉后把随机给出的方块放进对应层)、Cover and Reveal(记住三个色块的随机位置,从左到右用杯子盖住,再按红、蓝、黄的顺序揭开)、Tabletop Cleanup(把电源适配器、两卷胶带和手持风扇放进橙色盒子)。成功要求按规定顺序完成全部子任务并达到目标终态。RoC 三项分别为 70%、80%、70%,合计 73.3%;策略加历史加监控器为 56.7%,只用策略为 30.0%。agent 介入在三个任务上分别多出 10、20、20 个百分点。
每种设置共 30 次试验,73.3% 和 56.7% 即 22 次和 17 次成功(本站换算)。本站用 Wilson 法估算的 95% 区间约为 56%–86% 和 39%–73%,两者重叠,只凭这 30 次试验不足以确认 5 次成功之差;区间的算法见 物理AI实验室 2.8。作者把剩余的失败主要归于难抓的情形:agent 介入后仍没能把视觉证据转成有效的抓取修正,作者认为 agent 能力是剩下的瓶颈。与 agent 方法的真机效率对比放在附录,本站没有读到。
局限 / 注意
- 这是 arXiv 预印本,全部数字为作者报告 [R],本站没有复现。本站读到的正文没有报告训练种子数或置信区间,也没有提到代码或权重是否发布。
- 与 agent 方法的比较中,基线用 GPT-6 Astra(xhigh),RoC 用 GPT-6.1 Sol(xhigh)。成功率和 token 的差距里有多少来自模型本身,正文没有分开。
- 监控器在 RMBench 的同一组九个任务上训练,需要子任务边界标注;正文没有报告它在未训练过的任务上的表现。本站读到的正文也没有说明真机实验中监控器和策略用什么数据训练。
- 论文的动机包括等待 agent 的延迟,但主表只报告 token,没有给出每回合的耗时;监控器生成子任务时只有 0.53 Hz。
- 子任务接管时 agent 直接控制机器人,本站读到的正文没有描述接管时的安全约束。仿真结果和 30 次真机试验都不是硬件安全验证。
- 本文依据 arXiv HTML 正文,没有读附录。
链接
- Reasoning on Call: Efficient Agentic Robot Control for Long-Horizon Robot Manipulation(arXiv 2611.26341)
- 论文 HTML 全文
- 物理AI实验室 3.4:长程任务,手算单步与整条链的成功率,看进度记忆改变了哪一项,再审一次只换高层的路由消融
- 物理AI实验室 2.8:可复现评测,手算 Wald 与 Wilson 区间,从 1/√n 定评测次数,再给零失败算出失败率上界
- 前沿雷达|GPT-GEAR:不训练动作策略,让 GPT-6 Astra 用五个工具直接控机械臂,深度、触觉和示范怎样给比给不给更关键
- 前沿雷达|One Policy for 100 Household Tasks:一个 π0.5 检查点做 100 项家务任务,14 项交给先练习过的 GPT-6 Astra,作者自报 Q 0.639 对 0.108
- 物理AI实验室:一套每个数字都能核对的物理 AI 课程(课程大纲)