不训练任何动作策略,只给一个通用多模态模型几个工具,它能不能直接控制机械臂完成操作?来自南京大学、南洋理工大学、北京大学、中国科学院自动化研究所等机构的作者在预印本 Large Multimodal Models for Direct Robot Control: GPT-6 as a Beginning(arXiv 2610.28259,2026-10-20)里,用自建的工具框架 GPT-GEAR 让 GPT-6 Astra 做闭环操作,在仿真与真实环境中共跑了 2,000 多次试验。作者报告:模型在 RoboTwin 2.0 上成功率 76.0%,在 RoboDojo 上 26.92%,但在新提出的几何约束基准 LIBERO-GeoMotion 上只有 11.1%,真机零样本总成功率 40%。对工程读者更有用的是三组消融:深度、触觉和示范这些具身信息,以什么形式交给模型,结果差别很大。以下数字均为作者报告 [R],本站未复现。
GPT-GEAR:五个工具,一个只有相对位姿的动作接口
论文把操作写成部分可观测的决策问题:每轮模型读取 RGB 图像、本体状态,以及按实验条件额外提供的相机参数、深度图或触觉信号,然后选一个工具并给出参数。五个工具是:
- Observe:读取当前或某一条历史观测记录。读历史是只读的,不重新拍照、不推进仿真、不消耗控制步。
- Reference:在第一次动作之前,提供一份事先验证过的示范包,可以是视频关键帧、文字步骤、动作轨迹或它们的组合。
- Act:唯一会改变物理状态的工具。每只手臂给一个相对平移 Δp(米)、一个单位四元数表示的旋转增量 Δq、夹爪目标 g ∈ [0, 1] 和求解步数上限。
- Status:查询环境的任务完成判据。
- Finish:结束交互。
实现细节写得很具体:GPT-6 Astra 是唯一的规划组件,不用任何其他机器人专用模型;全部实验通过 Codex 运行,推理强度设为 high。每一步的平移和旋转增量分别限制在 0.01 m 和 0.05 rad,一次 Act 请求的位移不超过 0.20 m、旋转不超过 π/2 rad,默认每次 Act 最多执行 10 个原生控制步。假设 0.01 m 的上限针对每一步平移向量的长度(论文只对 0.20 m 的请求上限写明是范数,每步上限也可能按各轴分别计算),按这些数字推算(本站计算),默认设置下一次 Act 最多走 0.10 m。论文写明,运动完成情况和剩余位姿误差会作为反馈返回给模型,由它决定下一次怎么修正。控制器会检查运动学和关节约束,两只手臂中任一指令无效就整步拒绝;论文写明,这些检查不保证无碰撞,也不保证抓取成功,任务相关的运动规划仍由模型负责。
评测上有一点要看清:仿真里的成功由环境官方判据在结束时决定,与模型自己是否声称完成无关;而 Status 查询的也是这个判据。模型认为完成时调用 Status,未通过就继续执行,直到执行预算用完。所读正文没有给出预算的具体数值,也没有说明真机实验中由什么来判断完成。
三组消融:信息怎么给,比给不给更关键
三组消融各自在少量任务上做,样本量不同,下表只列关键行。总 token 是每回合输入加输出 token 的平均值。
| 消融(任务 × 每任务次数) | 条件 | 成功率 | 平均动作轮数 | 平均总 token |
|---|---|---|---|---|
| 深度(LIBERO-Plus,4 × 10) | 仅 RGB | 47.5% | 34.61 | 1,046,755 |
| RGB + 相机参数 | 60.0% | 26.32 | 986,066 | |
| RGB + 真值渲染的稠密深度图 | 67.5% | 24.23 | 1,101,271 | |
| RGB + 反投影点查询工具 | 60.0% | 27.00 | 1,377,672 | |
| 示范(LIBERO-Plus,5 × 10) | 无示范 | 64.0% | 23.00 | 1,187,814 |
| 只给首尾帧 | 46.0% | 21.18 | 1,448,025 | |
| 视频序列帧 | 64.0% | 20.72 | 1,442,084 | |
| 文字步骤 | 78.0% | 21.30 | 1,052,921 | |
| 动作轨迹 + 视频序列帧 | 82.0% | 19.92 | 1,222,021 | |
| 动作轨迹 + 文字步骤 | 82.0% | 21.00 | 1,191,807 | |
| 动作轨迹 + 视频帧 + 文字步骤 | 86.0% | 20.58 | 1,372,547 | |
| 触觉(UniVTAC,5 × 20) | 仅 RGB | 14.0% | 10.57 | 423.90k |
| RGB + 触觉图像 | 30.0% | 10.53 | 646.06k | |
| RGB + 文字形式的三轴力值 | 50.0% | 9.44 | 451.19k | |
| RGB + 触觉图像 + 文字力值 | 48.0% | 9.75 | 553.36k |
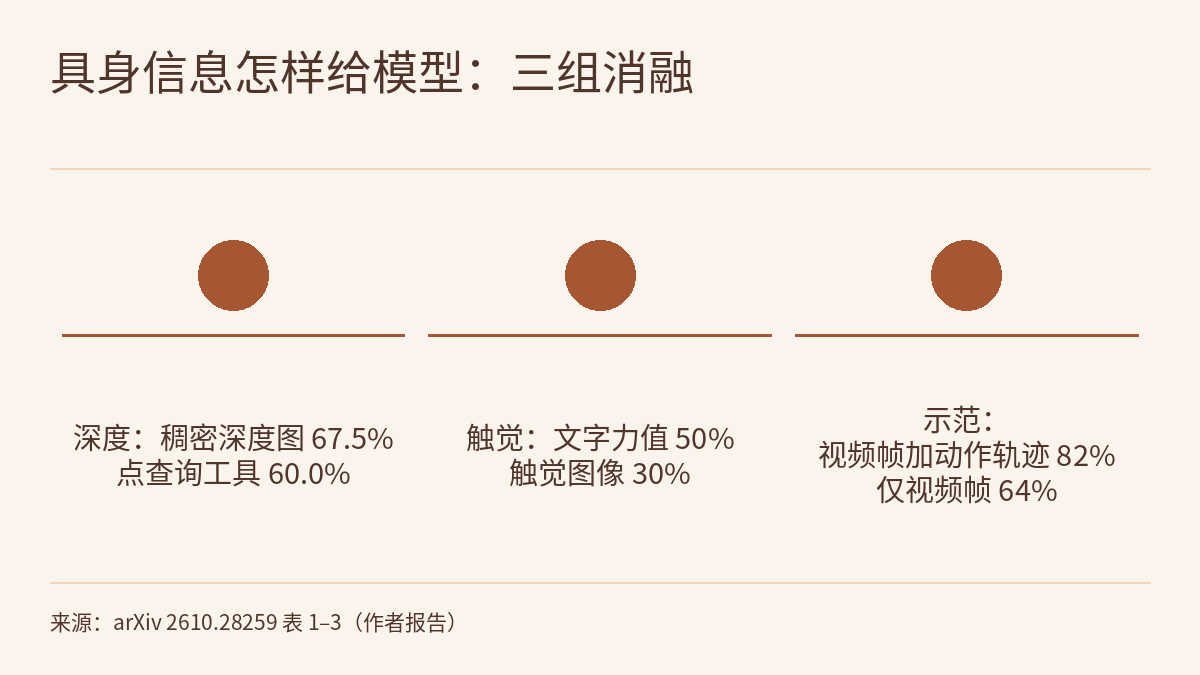
深度。只加相机内外参,成功率就从 47.5% 升到 60.0%,作者认为相机参数帮助模型把图像位置换算到机器人工作空间。要求模型在动作前先估计目标物体中心的深度,成功率为 62.5%;三个示例中估计值与真值的平均绝对误差为 1.91、3.81 和 3.40 cm。准确的点坐标反而不如稠密深度图:反投影工具每次只返回一个查询点的三维坐标,模型还得自己挑点、把坐标和物体与空间联系起来,token 比仅 RGB 多 31.6%,比深度图多 25.1%。作者也指出,即使给了真值深度,有些任务仍然失败,深度不是唯一的瓶颈。
示范。只给首尾帧时成功率降到 46.0%,低于不给示范;作者认为稀疏画面在示范场景与当前场景不同时会带来歧义。文字步骤主要帮助任务理解,动作轨迹则带来动作层面的信息:在任一种视觉或文字上下文上加轨迹,成功率都上升。作者强调示范动作不是被原样回放,而是按当前场景调整;全模态组合的 86.0% 比轨迹加文字的 82.0% 多用约 18 万 token。这组示范都来自同一任务、不同场景扰动下的专家轨迹。
触觉。同一传感器的读数,给成文字力值(x、y、z 三轴分量)比给成触觉图像好:成功率 50.0% 对 30.0%,token 也更少。作者的解释是,触觉图像编码的是触点响应而不是场景外观,模型更难读懂;两种同时给(48.0%)没有带来额外收益。最好的条件下仍有一半回合失败。
读这些差距时要把样本量换算回次数:深度每个条件 40 次,一次相当于 2.5 个百分点,60.0% 与 62.5% 只差一次;示范每个条件 50 次,一次相当于 2 个百分点;触觉每个条件 100 次。所读正文没有给出置信区间或显著性检验。物理AI实验室 1.8:评测练过怎样在次数有限时判断差距是否站得住;深度相机和触觉传感器本身给出什么数据,见物理AI实验室 1.3:传感器。
五个基准:几处领先,一处明显落后
主实验把能力组合起来:只给 RGB 和相机参数,并要求先估计目标深度;示范包含采样视频帧、文字步骤和动作轨迹;UniVTAC 上另外提供触觉反馈和真值深度图。五个基准共 164 个任务,因闭环评测成本高,作者没有跑完整的官方协议:RoboCasa GR1 和 UniVTAC 每任务 20 次,其他三个每任务 10 次。对比方法中一部分由作者按这套协议重新评测,其余用官方报告值。
- LIBERO-Plus:83.50%,接近 π0.5 官方报告的 83.90%;作者重测的 starVLA-OFT 和 starVLA-π 为 84.75% 和 85.50%。
- RoboTwin 2.0:76.00%,比作者重测的第二名 OpenWAM-α 高 9.20 个百分点。
- UniVTAC:72.50%,高于报告的 FTP-1(62.90%)和 starVLA(56.10%);注意这里模型额外拿到了触觉和真值深度。
- RoboDojo:成功率 26.92%、过程分 35.17,均为对比中最高,高于报告的 DM0.5(19.34%、24.90);作者也说两个绝对值都还很低。
- RoboCasa GR1:18.96%,高于报告的 π0(13.60%),低于报告的 π0.5(37.00%),也远低于重测的 starVLA-OFT(57.29%)和报告的 OpenWAM-α(60.50%)。这是唯一使用灵巧手的基准,作者推测更高的自由度和多接触关系是原因之一,同时说明汇总结果不能确立因果。
论文称这些是零样本结果,指的是不做基准专门的策略训练、不更新参数;模型仍然在上下文中拿到了示范。对比方法则都在各自的机器人数据上训练过。几处领先说明通用模型已经能在部分基准上与训练过的策略相当,不说明它在同等条件下更强。
按能力拆开:理解得了,做不精
作者按任务要求(不是按执行结果)给 164 个任务打上六类能力标签,一个任务可以有多个标签。汇总成功率:任务理解 73.45%(426/580)、泛化 59.20%(817/1380)、记忆 56.67%(34/60);长程执行 33.03%(218/660)、高阶操作(转向、旋转、倾倒、绕铰链运动)34.62%(135/390)、精度 36.19%(380/1050)。记忆只有 6 个任务、全部来自 RoboDojo。作者自己说明,这种比较反映的是任务要求和难度的差别,不是孤立的模型能力;他们的结论是“知道要做什么”和“在物理上做成”之间反复出现差距。
为了专门测这一差距,作者提出 LIBERO-GeoMotion:基于 LIBERO 资产,尽量降低语义复杂度,要求精确的位姿对齐、平移与旋转协调,以及预判动作的物理后果。GPT-6 Astra 的零样本成功率为 11.1%。真机上,作者报告模型能可靠完成基本的抓放,但零样本总成功率只有 40%,部分约束性任务完全失败;持续出现的失败涉及不安全的抓取构型、运动可行性和精确对齐,推理延迟也明显妨碍实际部署。
与本站此前介绍的 VLA 研究相比,这篇的出发点不同:它不训练策略,而是测一个通用模型靠推理和反馈能做到哪一步。Is Success All You Need?在同一个 LIBERO-Plus 扰动套件上提醒过,成功率相近的策略执行质量可能相差很大;本篇的动作轮数和 token 数是另一种“成功率之外”的记录。示范怎样影响策略,物理AI实验室 1.6:模仿学习从训练的角度讲过;这里的示范只放进上下文,不改参数。
局限 / 注意
- 这是 arXiv 预印本,全部数字为作者报告 [R],本站没有复现。本站读到的正文止于第 5.2.3 节(记忆),未读到 LIBERO-GeoMotion 的任务设计、真机实验和延迟数据的正文;这些部分只依据摘要和引言的表述,因此本文没有给出 LIBERO-GeoMotion 的任务数、真机任务数或延迟数值。
- 基准评测用的是缩减的试验次数,不是完整官方协议;对比图混合了作者重测值和官方报告值,各方法的输入条件也不同(例如 UniVTAC 上本模型额外有触觉和真值深度)。
- “零样本”指不训练、不更新参数,主实验仍提供示范上下文;消融中的示范来自同一任务的专家轨迹。仿真中 Status 查询的是环境官方判据,模型可以在预算内继续尝试。
- 上表各条件的每回合平均 token 数在约 42 万到 145 万之间,这是 API 用量记录,不是延迟或费用测量。
- 论文列出了项目页和代码仓库地址,本站没有打开,也不确认代码是否可用。
- 控制器的约束检查不保证无碰撞;仿真成功率和小规模真机结果都不是硬件安全验证,作者本身就把物理安全列为未解决的问题。
链接
- Large Multimodal Models for Direct Robot Control: GPT-6 as a Beginning(arXiv 2610.28259)
- 论文 HTML 全文
- 前沿雷达|Is Success All You Need?:成功率相近的两个 VLA,成功轨迹可能差得很远
- 物理AI实验室 1.3:传感器,用一只杯子手算像素、深度量程与夹紧力
- 物理AI实验室 1.6:模仿学习,手算误差怎样滚出示范覆盖范围,再把 ACT、扩散策略与数据规模律的数字放回各自条件
- 物理AI实验室 1.8:评测,把“净增 2”拆成配对表,再给失败标签和随机种子算一笔账
- 物理AI实验室:一套每个数字都能核对的物理 AI 课程(课程大纲)