移动机械臂和人形机器人只能把 VLA 跑在机载嵌入式板卡上,而语言骨干的预填充(prefill)在这类硬件上受算力限制,耗时随每个控制步输入的几百个视觉 token 增长。现有的免训练加速方法每步只重算一部分视觉 token,其余的要么全部剪掉,要么全部复用上一次的 KV 缓存。首尔大学与卡内基梅隆大学的作者在预印本 TRIAGE(arXiv 2610.34519,2026-10-25)中提出:不重算的 token 该复用还是该剪,取决于它的缓存“漂移”了多少,应当逐个决定。作者报告,在 LIBERO 和 SimplerEnv 仿真上,平均成功率与全量重算相差 3 个百分点以内,Jetson AGX Orin 上预填充延迟最多降低 48%。本文重点读三件事:那组决定“复用还是剪枝”的诊断实验怎么做;TRIAGE 每一步如何把 token 分成三组;以及主结果表里预填充、端到端和 p99 三种延迟各自说明了什么。以下数字均为作者报告 [R],本站未复现。
问题:没被重算的视觉 token 怎么处理
论文给出的背景数字:OpenVLA 每步输入 256 个视觉 token,OpenVLA-OFT 用两路相机共 512 个;视觉 token 约占输入序列的 90%。对一次前向就解码全部动作的 OpenVLA-OFT,预填充约占每个控制步的三分之二(表 I)。作者也说明了不把推理卸载到远程服务器的理由:端到端延迟取决于网络,移动机器人的无线链路有波动和中断,一次迟到或丢失的响应就会让控制回路停顿。
两类现有做法各有缺陷。剪枝在浅层估计每个 token 的重要性,永久丢弃不重要的;丢弃不可逆,剪得太狠就会丢掉与任务相关的 token。复用找出与上一帧基本没变的 token,沿用它们的 KV 缓存;但这些缓存是在上一帧的上下文里算出来的,场景一变就会过时,反复复用会累积误差。作者的判断是:对重算集合之外的所有 token 统一用一种操作,要么浪费算力,要么牺牲精度。一个重要但没变的 token,剪枝方法只能重算它或丢掉它;一个不重要的 token,复用方法仍会留着它,缓存过时了也照样用。据作者调研,此前没有 VLA 加速方法逐个 token 在两者之间选择。
诊断实验:drift 决定复用还是剪枝
作者用的信号是 drift:token 在浅层(论文取第 2 层)的注意力 value 自上次重算以来的相对变化,对各注意力头取平均。因为这些浅层每一步都对全部 token 运行,计算 drift 不增加额外开销。
诊断是一个受控对照:在 LIBERO-Spatial 上跑全量重算(每个骨干 20 个回合),以它的动作为参照;每次“探针”取 16 个 token,在第 3 至 31 层分别用复用和剪枝处理,其余 token 全部重算,再比较两种处理下的动作离参照有多远,差值记为 Δ,Δ 为负表示复用更接近全量重算。缓存年龄取 1、2、5、10、20、40 次查询(OFT 最多到 20);被探测的 token 按 drift 和重要性各分三档,从九种组合中抽取。OpenVLA 共 14,442 次探针,OFT 共 9,925 次。结论如下:
- drift 低于 0.3:两个骨干上合并后的 Δ 都为负,95% 置信区间整体低于零,单独看任一缓存年龄也都不高于零,即复用不比剪枝差。
- drift 高于 0.5:趋势反转,复用过时 KV 的动作误差是剪枝的 1.6 倍(OpenVLA)和 4.4 倍(OFT),缓存越旧越明显。
- 0.3 到 0.5 之间:OpenVLA 上复用仍无害,OFT 上已略差于剪枝。所以阈值依骨干而定,作者建议对新骨干重跑这个只需要全量重算回放、不需要训练的诊断来标定。
- 与重要性无关:作者称这一结论不随 token 重要性改变。缓存年龄影响的是复用带来多少好处:OpenVLA 上缓存隔了 20、40 次查询仍是复用更好,OFT 上从第 10 次起这一优势消失,但复用没有变成有害。
为简单起见,两个骨干都取 δ = 0.3,这是测试过的取值中两者都从未出现复用有害的最大值;附录中把 δ 改为 0.2 或 0.4,端到端成功率在统计上没有变化。
TRIAGE 每一步怎样分三组
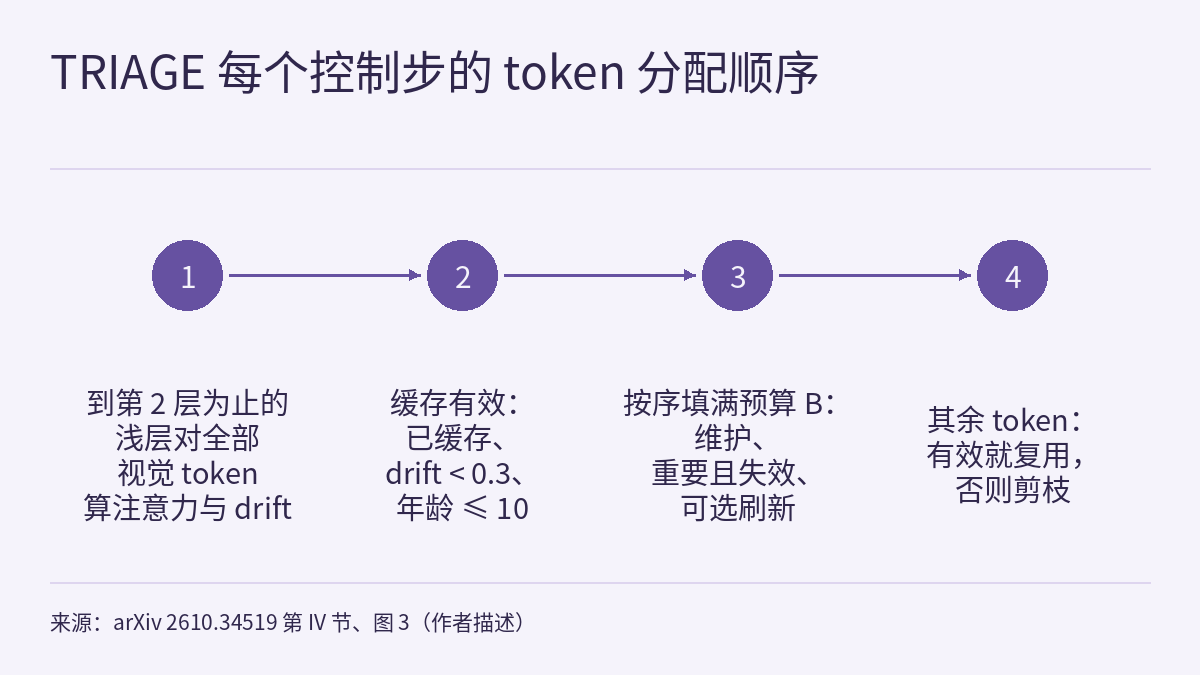
由此分出两个信号的分工:缓存是否有效决定不重算的 token 是复用还是剪枝;重要性决定有限的重算预算花在哪里,也就是那些重要、缓存却已失效、复用和剪枝都不合适的 token。
- 重要性:浅层动作解码 token 给该 token 的注意力,加上沿用 SAFE-Pruner 的深层显著性预测记忆。记忆只在第一次查询时记录,之后按投影特征的余弦相似度做图块对应,映射到当前帧,从不刷新。SAFE-Pruner 会在关键帧上用全部 token 重新记录,作者指出这会抬高尾延迟,所以 TRIAGE 任何一步都不跑全 token 查询。按重要性取前 B + κ 个作为重要集合(κ = 70),有意比预算大,好让其中缓存仍有效的 token 被复用而不必重算。
- 有效性:缓存有效当且仅当该 token 已有缓存、drift < 0.3、且距上次重算不超过 T = 10 次查询。drift 的参照值固定在上次重算时而不是上一次查询,缓慢的变化也会累积到被发现。年龄上限是保守的补充,作者报告去掉它成功率没有显著变化。
- 填满预算 B:按优先级依次放入(1)维护:重要集合之外最旧的 round(μB) 个已缓存 token,μ = 0.06,用来让背景 token 的复用维持下去;(2)必须重算:缓存失效的重要 token,以及刚进入重要集合、缓存是在被判为不重要时算出的 token;(3)可选刷新:剩余名额给缓存有效但变化最快的重要 token。
- 其余 token:只看有效性,与重要性无关,有效就复用,无效就剪掉。
只剪不复用和只复用不剪,分别是这个划分中复用集合为空和剪枝集合为空的两个极端。由于每一步重算的 token 数恒等于 B,预填充延迟由 B 决定,部署时取满足控制回路延迟目标的最大 B。实验中 B 按 SAFE-Pruner 的 FLOPs 对齐:OpenVLA 为 88 个(共 256 个),OFT 为 163 个(OFT-Goal 为 91 个,共 512 个);超参数在主要来自 LIBERO-Spatial 的开发回合上调好后冻结。
预算扫描:两个极端为什么都不够
图 4 在 LIBERO-Object、OpenVLA 上把 B 从 88 降到 18(视觉 token 的 34% 到 7%),每个预算 500 回合,报告 Wilson 95% 区间。对照的 drop-all 和 keep-all 与 TRIAGE 用同一个重要性排序、重算同样的 B 个 token,只是其余 token 全剪或全复用。
- drop-all 随预算缩小稳步下降,B = 18 时为 22.4%;同样剪掉所有未保留 token 的 SAFE-Pruner 为 19.4%。
- keep-all 在大预算下有竞争力,B 低于 46 后崩溃,B = 18 时为 0.0%;把重算集合限制为 B 的 VLA-Cache 降到 0.4%。两者孰优随预算而变:B = 46 和 64 时 keep-all 领先,B = 28 时 drop-all 领先。
- TRIAGE 在 B = 64 时与全量重算持平,B 降到 28(约 11%)仍在 3 个百分点以内,B = 18 时为 75.8%,其余方法都不高于 51.4%。与最强基线 VLA-Pruner 相比(按回合配对 bootstrap),B ≥ 46 时统计上无法区分,B = 28 时领先 13.2 个百分点,B = 18 时领先 24.4 个百分点。
摘要里“只重算 7% 视觉 token、领先最强基线 24.4 个百分点”说的就是这一个套件、这一个骨干、B = 18 的点。
主结果表:先分清是哪一种延迟
下表摘自论文表 I(LIBERO 四个套件,每套件 500 回合;延迟为 Jetson AGX Orin、bf16,单位 ms)。延迟是在同一段录制的观测流上回放测得的,每个套件回放 250 次查询,不是机器人闭环运行时的计时。
| 骨干 / 方法 | 平均成功率 | FLOPs | 预填充 | 端到端 | p99 |
|---|---|---|---|---|---|
| OpenVLA 全量重算 | 76.5 | 1.00× | 229.5 | 1261.3 | 1307.1 |
| OpenVLA VLA-Cache | 75.2 | 0.78× | 211.3 | 1365.7 | 1415.3 |
| OpenVLA VLA-Pruner | 73.3 | 0.39× | 204.5 | 1368.7 | 1428.5 |
| OpenVLA SAFE-Pruner(作者移植) | 70.1 | 0.45× | 158.4 | 1166.6 | 1255.9 |
| OpenVLA SpecPrune-VLA(作者复现) | 70.2 | 0.40× | 171.4 | 1177.0 | 1248.1 |
| OpenVLA TRIAGE | 73.7 | 0.45× | 167.7 | 1173.4 | 1228.2 |
| OFT 全量重算 | 97.1 | 1.00× | 433.9 | 653.0 | 674.8 |
| OFT VLA-Cache | 96.2 | 0.77× | 421.5 | 702.3 | 774.2 |
| OFT VLA-Pruner | 95.8 | 0.53× | 328.3 | 555.2 | 765.8 |
| OFT SpecPrune-VLA(作者复现) | 96.8 | 0.46× | 240.6 | 460.7 | 672.4 |
| OFT SAFE-Pruner | 95.5 | 0.44× | 238.3 | 466.5 | 768.0 |
| OFT TRIAGE | 95.8 | 0.44× | 224.0 | 443.1 | 461.1 |
- “最多 48%”是 OFT 的预填充。224.0 对 433.9 ms,即 0.52×。OpenVLA 上预填充为 0.73×,端到端只有 0.93×,作者的解释是全量重算时一步里 82% 的时间不在预填充。OFT 的端到端为 0.68×。
- FLOPs 少不等于在 Jetson 上快。OpenVLA 上 VLA-Pruner 的 FLOPs 只有 0.39×,端到端却比 TRIAGE 长 17%,VLA-Cache 长 16%,两者都慢于全量重算。
- TRIAGE 不是每一列都最快。OpenVLA 上 SAFE-Pruner 的预填充(158.4 ms)和端到端(1166.6 ms)都低于 TRIAGE,但平均成功率低 3.6 个百分点。作者的说法是 TRIAGE 在成功率与预填充延迟上处于 Pareto 前沿,没有基线同时更准又更快。
- 尾延迟。Jetson 上 TRIAGE 在每个设置中 p99 都最低。OFT 上它的 p99 只比均值高 4%,SAFE-Pruner 的 p99 达到均值的 1.6 倍,作者将其归因于后者关键帧要跑全 token 推理。固定预算的价值主要体现在这一列(本站解读)。
- “3 个百分点以内”是平均值。按表 I 逐套件看(本站核算),OpenVLA 上 TRIAGE 在 Long 套件为 49.2% 对全量 56.0%,差 6.8 个百分点;OFT 的 Long 为 88.6% 对 93.6%,差 5.0 个百分点。
SimplerEnv(Google Robot,基础版 OpenVLA,不重新调参)上,TRIAGE 平均 54.5%,全量重算 54.8%,SpecPrune-VLA 和 VLA-Pruner 分别低 4.2 和 6.1 个百分点;Jetson 预填充为全量重算的 0.74×。Move Near 每个设置 240 回合,Pick Coke Can 297 回合。
和本站其他内容的关系
前沿雷达专题|边缘与实时性 汇总过 VLA 与世界动作模型的延迟预算花在哪里;TRIAGE 只针对其中预填充一段,而且像 OpenVLA 这样在 Jetson 上预填充只占全量重算一步约 18% 的模型,端到端收益有限。前沿雷达|Fast-VLA 也用 KV,但思路相反:它让 VLM 每个回合只想一次,把结果存成任务记忆;TRIAGE 每个控制步照常调用骨干,只减少重算的视觉 token。作者把异步执行、量化、跳层列为可以与 TRIAGE 叠加的正交手段,异步动作队列的时间账可以对照 物理AI实验室 2.3。读这类延迟数字时,物理AI实验室 0.3 的规则同样适用:一个毫秒数只属于测出它的模型、硬件和测量方式;“3 个百分点以内”和 Wilson 区间,可以用 物理AI实验室 1.8:评测 的方法去拆。
局限 / 注意
- 这是 arXiv 预印本,全部数字为作者报告 [R],本站没有复现。所读文本没有提到代码是否公开。
- 成功率全部来自 LIBERO 和 SimplerEnv 仿真,论文没有真机实验;延迟是在录制观测流上回放测得,不是机载闭环运行。仿真结果也不是硬件安全验证。
- 诊断实验和超参数调优主要都用 LIBERO-Spatial,这一套件不是留出评测。敏感性分析换用未参与调参的 LIBERO-Goal(OpenVLA,B = 28,默认 70.6%),单项改动的变化都不超过 4 个百分点、95% 区间都包含零;去掉年龄上限为 68.6%(配对差 −2.0 个百分点,95% CI [−6.2, +2.2])。区间宽约 8 个百分点,更小的影响这组实验分辨不出来(本站推断)。
- OpenVLA 上的 SAFE-Pruner 是作者自己的移植(无官方代码),SpecPrune-VLA 只复现了静态阶段(无公开代码);主结果表正文没有给出置信区间;成功率结果中,只有预算扫描(Wilson 区间)和敏感性分析报告了区间。
- 作者自己列出:δ、T、κ、λ、μ 都是经验设定;已观测到 drift 阈值随骨干而不同,作者认为它还可能随任务和场景速度进一步变化,因此需要在部署时自适应调整的方法;drift 只能在变化发生之后察觉。
链接
- TRIAGE: Efficient Vision-Language-Action Inference Needs Both Reuse and Pruning(arXiv 2610.34519)
- 论文 HTML 全文
- 前沿雷达专题|边缘与实时性:VLA 与世界动作模型的延迟预算花在哪里
- 前沿雷达|Fast-VLA:每个回合只让 4B VLM 想一次,执行器每块动作都去查固定的 KV 任务记忆
- 物理AI实验室 0.3:看-想-动,把三个频率放回各自的系统
- 物理AI实验室 1.8:评测,把“净增 2”拆成配对表,再给失败标签和随机种子算一笔账
- 物理AI实验室 2.3:微调 SmolVLA,为一句指令配好示范数据,核对每个数字的口径,再给异步动作队列算时间账
- 物理AI实验室:一套每个数字都能核对的物理 AI 课程(课程大纲)