VLA 要靠规模变强,卡在两件事上:带动作标签的机器人示范很贵,不同机器人的原生控制量在维数、坐标系和含义上又互不兼容。人类视频和网络视频数量大得多,却没有对应的机器人指令。来自香港具身智能实验室、香港中文大学、阿里巴巴达摩院和湖畔实验室等机构的作者,在预印本 RynnVLA-Latent(arXiv 2610.34356,2026-10-25)中先训练一个潜动作模型 RynnLAM,把 25 个来源、约 30.1K 小时的人类、机器人和仿真视频统一标成 7.4552 亿个“潜动作”描述子,再让 VLA 先学预测这些描述子,最后才用目标机器人的示范接上真实动作。作者报告 4B 策略在 LIBERO 上 98.8%、LIBERO-Plus 上 84.7%、RoboTwin 2.0(Native 协议)上平均 88.6%。本文重点读三件事:RynnLAM 用什么约束让潜动作贴近“控制相关的运动”而不只是画面变化;各项基准领先的幅度与口径;以及论文里最有信息量的一组对照——在同一个约 1,000 小时子集上,潜动作预训练与两种显式动作对齐各自强在哪里。以下数字均为作者报告 [R],本站未复现。
RynnLAM:一个 608 维描述子,把动作、局部运动和相机分开
潜动作的思路是:不要原生控制标签,只把相邻两帧之间的变化编码成一个代理动作。作者指出,画面变化里还混着相机运动、静态外观和与智能体控制无关的效应,所以重建图像好的表示,不一定适合预测底层操作动作。RynnLAM 以 Depth-Anything-3 为骨干,输入一对 RGB 帧,输出三部分拼成的连续描述子:
- 8 个局部运动 token(8×64 = 512 维):作为解码器唯一的跨帧输入,去预测目标帧特征相对源帧的残差变化,而不是重建目标帧本身;误差按变化幅度归一化。
- 全局动作潜变量(64 维):用来预测源相机坐标系下的动态 3D 场景流。伪标签由估计的深度、相机位姿和现成光流算出,补偿相机运动后,静止区域的动态流应接近零。另有一项对比损失,要求按流变形后的源特征更接近目标特征、而不是未变形的源特征。
- 相机潜变量(32 维):解码两帧之间的相对 6 自由度相机位姿;同时用梯度反转,让同一个位姿解码器无法从动作潜变量里读出相机位姿。
五项损失的权重为重建、流、位姿各 5,特征对比 3,梯度反转 2。训练分两段:编码器冻结 36K 步,解冻后再训 20K 步。作者写得很克制:这些目标“鼓励”相机解耦,不保证视角不变性或物理可辨识性;相机解耦只作用在全局动作潜变量上,完整描述子保留了相机潜变量,因此并不假定它与相机无关。
探针结果。在 LARY 基准的底层控制回归上,用冻结表示加一个轻量 MLP 去回归末端轨迹。作者另设了“相对”口径,预测相对首帧的末端位移,因为短步长下绝对目标可以部分由画面里可见的当前位姿猜出。完整描述子的相对平均 MSE 为 0.38,低于 DreamDojo 0.55、Moto 0.77、LAPA 0.93;但在相对 CALVIN 上 DreamDojo 仍更好(0.35 对 0.40)。去掉单个组件后,相对平均 MSE 分别升到:冻结编码器 0.52,去掉 3D 流 0.50,去掉相机分支 0.47,去掉梯度反转 0.49,去掉运动 token 残差预测 0.57。作者也说明,这个探针不直接测量恢复出的 3D 运动是否准确。
语料与两阶段训练:预训练不碰原生动作和本体状态
语料来自 25 个数据集,共约 30,117.68 小时、1,663 万段、30.57 亿帧。按时长,真实机器人约 12,038.97 小时、仿真约 6,139.18 小时、人类交互视频约 11,939.53 小时,即约四成、两成、四成。其中 HowTo100M 一项的段数就超过全部真实机器人来源之和。每段视频先经 Qwen3-VL 生成描述、DPFlow 估计光流、Depth Anything 3 估计深度;RynnLAM 作为离线标注器,每隔 4 帧取一对,例如 (0, 4)、(4, 8),共产生 7.4552 亿个描述子。策略训练每 6 个描述子组成一个预测块,训练索引有 1.2106 亿个样本,批量 128 时每个 epoch 约 94.6 万步。各来源按配置权重的 0.7 次方采样,用来平衡网络视频和机器人数据。
策略是 Mixture-of-Transformers 结构:视觉语言骨干 RynnBrain 编码多视角图像和指令,一个与骨干同层数、隐藏宽度只有 768 的动作专家在每层与之联合注意力。注意“2B”“4B”指骨干规模,含动作专家的总参数分别是 2.51B 和 5.04B。
- 预训练:用 flow matching 从高斯噪声生成含 6 个潜动作的块,以多视角观测和语言为条件;不用原生动作,也不用本体状态。相机配置映射到 6 个规范的相机槽,缺失的视角在注意力和损失中都被屏蔽。
- 后训练:同一个 flow matching 目标改成目标机器人的动作空间,用该本体的示范全量微调,并在这一步才加入本体状态。不另加潜动作到动作的解码器,只把预训练的读出主干接上一层新初始化的薄投影;不同机器人共用一个统一动作布局,用掩码屏蔽不用的维度。
- 推理:用 Euler 步从噪声积分出一个动作块,整块执行完再重新规划。作者写明,真机评测衡量的是闭环任务成功率,推理速度不是评测指标。
基准数字怎样读
| 基准 | RynnVLA-Latent-4B | 表中最强的对照 | 读法 |
|---|---|---|---|
| LIBERO 平均 | 98.8% | Xiaomi-Robotics-0 98.7% | 作者自己说 0.1 个百分点只是报告分数之差,不是统计显著的证据;Long 套件上 2B(97.8%)高于 4B(97.0%) |
| LIBERO-Plus 总分 | 84.7% | π0.5 84.4% | 用 LIBERO 微调后的检查点直接评测,不做针对性适配;相机扰动 72.9% 对 π0.5 78.4%,机器人初始状态扰动 64.0% 对 73.6%,背景扰动 StarVLA 更高 |
| VLABench 五轨平均成功率 | 51.9% | π0.5 48.1% | 4B 每轨成功率都是表中最高;常识轨的进度分和意图分 π0.5 领先;2B 平均成功率低于 π0.5,意图分却更高 |
| RoboTwin 2.0 Native 平均 | 88.6%(干净 88.7%、随机化 88.4%) | LingBot-VLA 87.7% | Native 协议训练时就含随机化场景的示范,作者明说这不是对随机化场景的零样本迁移;基线数字取自各自的报告 |
| 真机 6 项任务 | 每项都是表中最高 | π0、π0.5、GR00T-N1.7 | 两台双臂平台、每项任务每个设置 35 次;2B 的比较有输有赢 |
同一个数,论文里有两个写法。RoboTwin 2.0 的平均成功率,摘要和表 6 写 88.6%,引言和结论写 88.3%。表 6 注明本行的平均是干净与随机化两项的算术平均,(88.7 + 88.4) ÷ 2 = 88.55,与 88.6% 一致(本站核算);88.3% 从何而来,所读文本没有说明。
把真机百分比换回次数。每项 35 次,一次成功约等于 2.86 个百分点。按此换算(本站推算),Table-Cleaning 从 π0.5 的 25.71% 到 4B 的 40.00%,是 9 次对 14 次;Steak-Serving 从 40.00% 到 57.14%,是 14 次对 20 次;Plate-Placement 上 4B 85.71% 对 π0.5 82.86%,只差 1 次。所读文本没有给出置信区间或重复实验,各任务的示范段数在附录表 11,本文未读到。真机平台是固定的 Marvin-WUJI(双 7 自由度臂加双 20 自由度灵巧手,共 54 自由度)和轮式移动的 Astribot-S1(双 7 自由度臂加平行夹爪),结果对应的是在目标机器人上后训练之后的表现,不是对未见本体的零样本部署。
同一个约 1,000 小时子集:潜动作与显式动作对齐各有所长
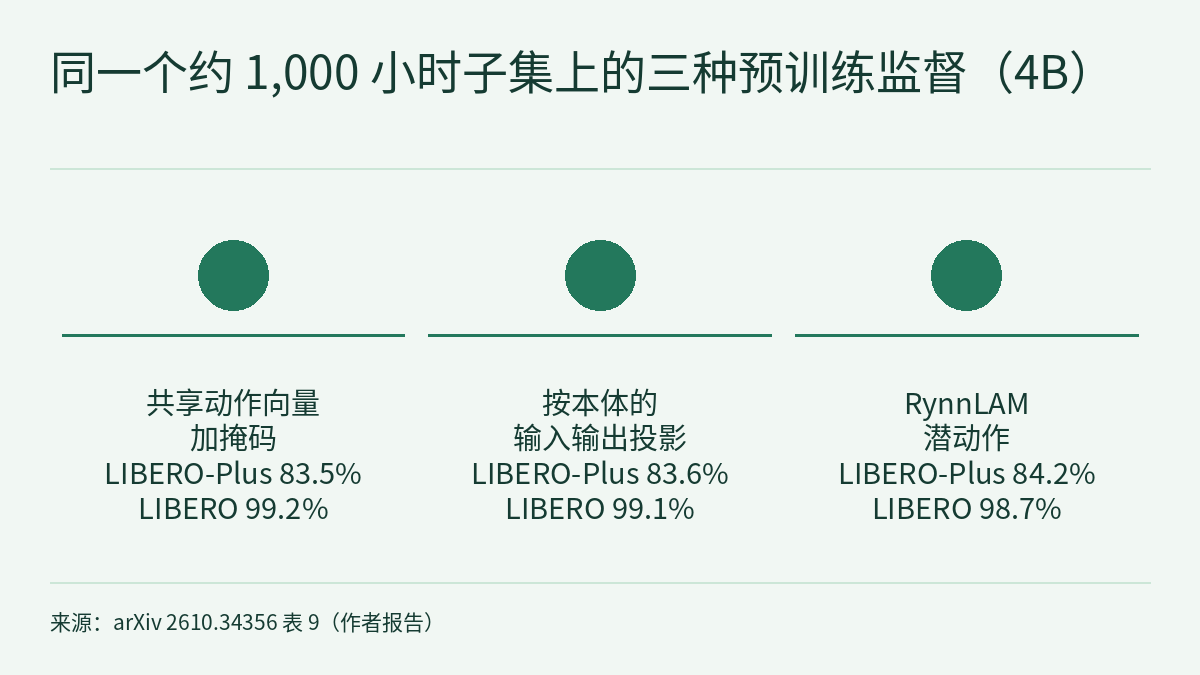
全量结果混合了骨干、数据量和监督方式的影响。为了拆开,作者在一个约 1,000 小时的子集(RoboCOIN、EgoDex、EPIC-KITCHENS、Something-Something)上训练了一组变体,表 9 里所有行都用这个子集,与全量语料的结果不可直接比较。其中两种显式对齐基线遇到没有原生动作的人类视频时,用动作捕捉得到的手腕位姿和指尖位置作为伪动作。
| 预训练监督 | 2B LIBERO | 2B LIBERO-Plus | 4B LIBERO | 4B LIBERO-Plus |
|---|---|---|---|---|
| 共享规范动作向量加掩码 | 98.7 | 80.5 | 99.2 | 83.5 |
| 按本体的输入、输出投影 | 99.0 | 82.1 | 99.1 | 83.6 |
| LAPA 潜动作目标 | 98.2 | 80.2 | 98.0 | 81.3 |
| RynnLAM 潜动作目标 | 98.1 | 82.3 | 98.7 | 84.2 |
- 方向是一致的,幅度很小。两种规模下,RynnLAM 在 LIBERO-Plus 上都最高,在 LIBERO 上都不如两种显式对齐。作者的解读是:潜动作监督可能更有利于分布偏移下的鲁棒性,显式原生动作对齐在分布内执行上仍有竞争力。但 RynnLAM 比按本体投影只高 0.2(2B)和 0.6(4B)个百分点,所读文本没有给出重复次数或区间。
- 其他变量。同一子集上,RynnBrain 骨干比 Qwen-VL 骨干在 LIBERO-Plus 上高 3.5(2B)和 4.5(4B)个百分点;去掉相机槽低 0.4 和 1.3 个百分点;把 RynnLAM 描述子换成 LAPA 目标低 2.1 和 2.9 个百分点。在 LIBERO-Plus 上,这组对照里骨干带来的差距比监督方式之间的差距更大(本站比较)。
- 数据规模。作者用 10%、30%、50%、70%、100% 的语料预训练,只在 LIBERO-Plus 上评测:两种规模都在 100% 时最高,2B 逐档上升,4B 从 10% 到 30% 略有下降后才回升。具体数值只在图 8 中,正文没有列出。顺带一提,4B 在千小时子集上 LIBERO-Plus 为 84.2%,全量为 84.7%;两者数据构成不同,这 0.5 个百分点不能当作规模效应的测量(本站比较)。
和本站其他内容的关系
本站近期写过两篇从视频学潜动作的预印本。前沿雷达|EgoJEPA 只用第一视角人类视频,以手部动作差分为条件学潜动作,换机器人时加一对适配器;前沿雷达|SkeLAM 用骨架把潜动作拆开,供世界模型做动作条件。RynnVLA-Latent 的新信息在于:把人类、机器人、仿真三类视频放进同一个潜动作目标做策略预训练,并在同一子集上直接与显式动作对齐比较。三篇的数据、评测和对照都不同,数字不能互比。论文开头说的“原生控制量维数、坐标系、含义各不相同”,可以对照 物理AI实验室 1.5:数据从哪来 里讲的动作空间;“一次生成一块动作、整块执行完再重规划”与 物理AI实验室 1.6:模仿学习 讲的动作分块相关;0.1 到 0.6 个百分点的差距和每项 35 次的真机结果,可以用 物理AI实验室 1.8:评测 的方法去读。
局限 / 注意
- 这是 arXiv 预印本,全部数字为作者报告 [R],本站没有复现。所读文本没有给出置信区间或多随机种子结果;仿真基准的基线数字取自各自的报告,评测条件未必完全一致。
- RoboTwin 2.0 平均成功率在论文中有 88.6% 与 88.3% 两种写法,本文按表 6 与摘要取 88.6%。
- 3D 流的伪标签来自现成模型估计的深度、位姿和光流;LARY 探针衡量的是控制可预测性,不是 3D 运动的度量精度。用流解码器可视化策略预测的潜动作,作者也说只是定性解释。
- 相机解耦只作用于全局动作潜变量,完整描述子保留相机信息;LIBERO-Plus 上相机和机器人初始状态扰动仍明显弱于 π0.5。
- 后训练仍需目标机器人的示范;真机结果是后训练后的闭环成功率,每项 35 次,没有评估推理速度,也不是硬件安全验证。
- 本文所读的是论文 HTML 正文,止于结论部分,不含附录(数据采集、伪动作实现、表 11 等);所读文本没有给出训练所用的算力与时长。论文列出了项目页、GitHub、Hugging Face 和 ModelScope 链接,本站没有核实其中的代码或权重是否已发布。
链接
- RynnVLA-Latent: Scaling Robotic Manipulation Foundation Models with 3D-Grounded Latent Actions(arXiv 2610.34356)
- 论文 HTML 全文
- 前沿雷达|EgoJEPA:不做人到机器人的重定向,从第一视角人类视频学潜动作,换机器人只加一对适配器再微调
- 前沿雷达|SkeLAM:用机器人骨架把潜动作拆成“手臂怎么动”和“场景怎么变”,机器人动作只接前一半
- 物理AI实验室 1.5:数据从哪来,从 SO-101 元数据算出示范时长,再分清三条来路的单位与动作空间
- 物理AI实验室 1.6:模仿学习,手算误差怎样滚出示范覆盖范围,再把 ACT、扩散策略与数据规模律的数字放回各自条件
- 物理AI实验室 1.8:评测,把“净增 2”拆成配对表,再给失败标签和随机种子算一笔账
- 物理AI实验室:一套每个数字都能核对的物理 AI 课程(课程大纲)