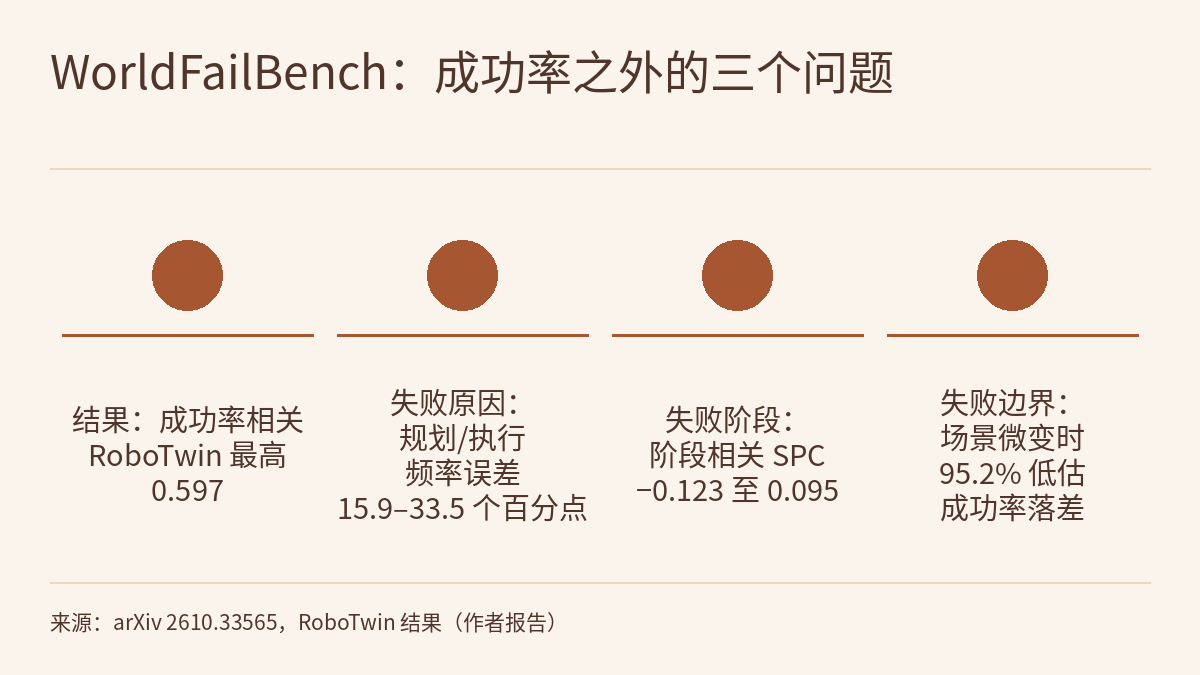
用世界模型代替真机或仿真器来评测机器人策略,常见的检验是看策略在世界模型里的成功率与参考环境是否相关。预印本 WorldFailBench(arXiv 2610.33565,2026-10-24)追问的是成功率之外的三件事:世界模型能否复现策略失败的原因、失败发生在哪个阶段,以及场景稍作改变时成功率从哪里开始下滑。作者在 LIBERO、RoboTwin 两个仿真环境和 G1 人形机器人的真机任务上评测了七个世界模型,主结果来自 RoboTwin:失败类型频率的平均误差为 15.9–33.5 个百分点,阶段相关最高只有 0.095,在 60 个场景变化对上,95.2% 的预测低估了参考成功率的变化幅度。以下数字均为作者报告 [R],本站未复现。
为什么只比成功率不够
常见的做法是基于结果的评测:同一组策略分别在世界模型和参考环境(常规仿真器或真机)里跑,比较各策略成功率的跨策略相关。本站介绍过的 Token-World 和 PhysCanvas 都用这类相关系数衡量世界模型能否当评测器。WorldFailBench 认为,这类一致性并不能说明世界模型如实模拟了策略怎样失败。论文图 1 用收衣服任务举了三种偏差:
- 失败原因:参考执行抓起衣服又掉落,是动作执行失败;生成的推演里策略去抓篮子,选错了目标,成了任务规划失败。两边都算失败,但诊断会把改进方向引向错误的模块。
- 失败阶段:参考执行在放置时失败,模型预测在搬运时失败;最终结果一致,失败位置不同。
- 失败边界:篮子挪位后参考成功率骤降,模型却仍预测高成功率,会高估策略可靠工作的条件范围。
物理AI实验室 1.8:评测讲过一个“失败”标签会盖住失败的方式;这篇论文把同样的问题放到了世界模型评测器身上:评测器本身是否把失败类型和位置搞对了。
三项任务与六个指标
评测是闭环的:每一步策略根据观测历史、机器人状态和任务指令选动作,世界模型预测下一帧观测并返回给策略;参考执行以同样方式在仿真器或真机上进行。两边固定任务指令、策略和对应的初始条件。
| 任务 | 问的问题 | 指标 |
|---|---|---|
| 失败原因 | 任务规划失败与动作执行失败各占多少,是否随策略同样变化 | TFE:两类失败频率的平均绝对差(越低越好);TPC:各类失败频率的跨策略 Pearson 相关(越高越好) |
| 失败阶段 | 最早的决定性失败落在哪个子目标阶段 | SFE:各阶段失败频率的绝对差之和,取值 0–2(越低越好);SPC:各阶段频率的跨策略 Pearson 相关 |
| 失败边界 | 相邻场景条件之间成功率下降的方向和幅度 | OA:变化方向一致的比例,平局记 0(越高越好);GE:成功率变化之差的平均绝对值(越低越好) |
频率都以全部评测回合为分母,成功回合也计入;无法归类的失败标为 Indeterminate,阶段未知的失败只留在分母里。作为参照,作者在 RoboTwin 和 LIBERO 上把同一组策略从相同初始场景在参考环境里重跑一遍,用同样的指标比较两次参考执行,得到 Ref–Ref 基线,用来判断模型的偏差是否超出参考执行自身的随机波动。
数据怎样来
失败原因与失败阶段的参考数据:每个“任务-策略”组合采 50 条随机场景的参考执行,再做对应的世界模型执行。
- LIBERO(仿真、单臂):10 个任务 × 3 个策略(π0.5,以及只用 50% 和 20% 微调数据的 π0.5-data-50、π0.5-data-20),共 1,500 条。
- RoboTwin(仿真、双臂):20 个任务 × 5 个策略(另加 LingBot-VLA-v2 和 FastWAM),共 5,000 条。
- G1(真机、人形):扫垃圾、收衣服 2 个任务 × 4 个任务专用策略版本(V1–V4),共 400 条。
失败边界只在仿真里构造:沿物体位置、朝向或尺寸之一扫描,其他条件不变,每个条件跑 10 次参考执行,挑出成功率相差至少 30 个百分点的相邻条件对;每个平台冻结 60 对及其端点顺序,再用新随机种子独立重估参考成功率,之后不重选、不调序。每个世界模型在每个端点上把同一策略跑 10 次。论文正文里“2 cm 一档、成功率从 90% 降到 40%”的例子,作者明确说是说明选择标准的假设数字,不是实测对。
标注分两步。结果标注由 Doubao-Seed-2-1-Pro 和 ChatGPT 6 两个模型看视频判定,两者一致率 90.1%,分歧全部由一位专家裁定;在一致样本中随机抽取占全数据 10% 的部分人工核查,与人工判断的一致率为 97%。仿真参考执行的最终结果以仿真器自带的判定为准。失败类型和阶段由两位专家逐条标注,裁定前一致率 92%,分歧由第三人裁定。
被评测的七个世界模型是 Ctrl-World、Cosmos-Predict-2.5、BWM、DreamDojo、GE-Sim 2.0、A2World 和 DW05;BWM 因缺少兼容的权重和适配代码,没有参加 LIBERO 和 G1 的评测。
成功率相关最高的模型,失败诊断并不跟着最好
以下均为 RoboTwin 上的结果,每个相关系数基于五个策略。
- 失败类型:DW05 的成功率相关最高(0.597),但规划失败和执行失败的相关只有 0.456 和 0.348。不同类型甚至方向相反:A2World 与参考的规划失败正相关(0.353)、与执行失败负相关(−0.086),BWM 正好反过来(−0.121 对 0.143)。最高的综合 TPC 为 0.402。七个模型的 TFE 均值为 0.159(DW05)到 0.335(Cosmos),即两类失败频率平均差 15.9–33.5 个百分点;Ref–Ref 为 0.061。
- 失败阶段:七个模型的 SPC 在 −0.123 到 0.095 之间。DW05 从成功率相关 0.597 降到 SPC 0.052,GE-Sim 从 0.260 降到 −0.004;Ref–Ref 两项为 0.942 和 0.903。SFE 均值为 0.633 到 0.817,Ref–Ref 为 0.094。
论文图 5 给了一个具体例子:FastWAM 在 blocks_ranking_size 任务上,参考执行的失败集中在“抓小方块”阶段(66%),“放置”阶段占 16%;DreamDojo 生成的推演里这两个数是 6% 和 46%。作者称这种从抓取到放置的转移在五个策略上都出现。照这样诊断,改进的重点会放到放置环节,而参考环境里的主要问题在抓取。
顺带说明:Ctrl-World 在 Token-World 那篇里也作为对照出现过,那是另一篇论文在自己的评测设置下报告的数字,与这里 RoboTwin 上的数字不能直接比较。
场景微变:方向判错,幅度被压扁
在 60 个 RoboTwin 边界对上,各因素的最高 OA 分别是位置 0.685(A2World、BWM 并列)、朝向 0.590(GE-Sim)、尺寸 0.758(Ctrl-World);Ref–Ref 的 OA 为 0.95–1.00,GE 为 0.005–0.020。按 OA 的定义,低于 0.5 意味着按设置平均后,判对变化方向的比例不到一半;七个模型中有六个在朝向上低于 0.5,只有 GE-Sim 例外。
幅度上,七个模型 × 60 对共 420 次比较中,有 400 次(95.2%)低估了参考成功率差的绝对值,策略因而显得比实际更不怕场景变化。图 6 的例子是 LingBot-VLA-v2 做 adjust_bottle:瓶子偏航角从 −60° 变到 −80° 时,参考成功率从 100% 降到 0%;四个模型预测成功率上升,一个预测不变,只有 A2World 和 GE-Sim 判对了下降方向,但都只预测降 20 个百分点。
弱点还因因素而异:五个模型的最低 OA 出现在朝向上,DW05 和 GE-Sim 则出现在尺寸上。Ctrl-World 的 OA 从尺寸的 0.758 跌到朝向的 0.359,朝向上的 GE(0.719)也是七个模型中最高;GE-Sim 朝向 0.590、尺寸只有 0.424。只测一种扰动,会漏掉另一种。作者的建议是,用失败边界评测找出世界模型预测在哪些条件下必须先回到参考环境核实,再据此安排后续测试。
局限 / 注意
- 这是 arXiv 预印本,数字均为作者报告 [R],本站未复现。主结果只来自 RoboTwin;LIBERO 和 G1 的结果在附录 D.4–D.7。本站读到的正文止于附录 A.1.3,没有读到 Ref–Ref 基线的细节(附录 A.4)、边界对的重估方法(附录 C)、表 15 以及图 10、图 11 的完整数据。
- 每个相关系数只基于五个策略再在任务间平均。按本站判断,这样的相关对个别策略的变化较敏感;论文没有给出置信区间或显著性检验(就所读部分而言)。
- 作者自己写明的局限:策略、任务和边界条件有限,结论的普适性受限;结果描述的是包括适配器和推演调度在内的整个世界模型系统,不区分具体架构组件;失败标签描述可观察的行为,不代表策略内部的原因。
- 结果标注部分依赖两个视觉语言模型,再由人工裁定和抽检;失败类型只分规划与执行两类。表 1 的基准对比是作者自己的归纳。
- G1 上的四个策略版本引用自 Kairos(arXiv 2606.16533),其作者名单包含本文的两位作者。论文页首列出了 GitHub 代码仓库和 Hugging Face 数据集地址,本站没有打开核实其内容。
- 世界模型里的推演结果、仿真里的边界对都不是硬件安全验证。
链接
- WorldFailBench: Do World Models Understand Policy Failures?(arXiv 2610.33565)
- 论文 HTML 全文
- 前沿雷达|Token-World:在 VLM token 空间里推演世界模型,不经 RGB 重建来模拟 VLA 策略
- 前沿雷达|PhysCanvas:把视觉、触觉和任务状态画进同一张画布,再用三个冻结的奖励模型让世界模型里的成败贴近真机
- 前沿雷达专题|仿真与评测:VLA 评测在初始状态成功率之外缺了什么
- 物理AI实验室 1.8:评测,把“净增 2”拆成配对表,再给失败标签和随机种子算一笔账
- 物理AI实验室:一套每个数字都能核对的物理 AI 课程(课程大纲)