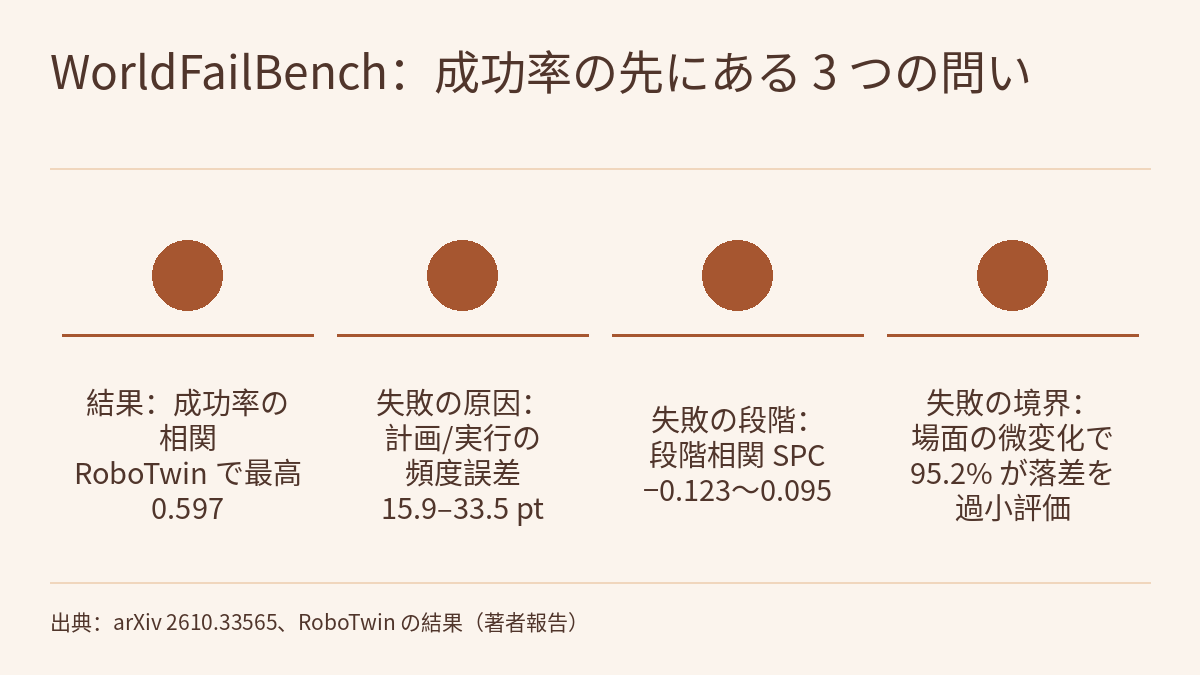
世界モデルを実機やシミュレータの代わりに使ってロボットの方策を評価するとき、よく行われる検証は、世界モデル内の方策の成功率が参照環境の成功率と相関するかどうかです。プレプリント WorldFailBench(arXiv 2610.33565、2026-10-24)は、成功率には現れない 3 つの点を問います。世界モデルは方策が失敗する原因を再現できるか、失敗がどの段階で起きるか、そして場面を少し変えたとき成功率がどこから崩れ始めるか、です。著者らは LIBERO と RoboTwin の 2 つのシミュレーション環境、および G1 ヒューマノイドロボットによる実機タスクで 7 つの世界モデルを評価しました。主な結果は RoboTwin のもので、失敗タイプの頻度の平均誤差は 15.9〜33.5 ポイント、段階相関は最高でも 0.095、60 組の場面変化ペアでは予測の 95.2% が参照成功率の変化幅を過小評価しています。以下の数値はすべて著者報告 [R] で、本サイトでは再現していません。
成功率を比べるだけでは足りない理由
一般的なのは結果ベースの評価です。同じ方策群を世界モデルと参照環境(通常のシミュレータまたは実機)でそれぞれ動かし、方策間の成功率の相関を比べます。本サイトで紹介した Token-World と PhysCanvas も、この種の相関係数で世界モデルが評価器として使えるかを測っています。WorldFailBench は、こうした一致があっても、世界モデルが方策の失敗の仕方を忠実にシミュレートしているとは言えないと主張します。論文の図 1 は、衣類の回収タスクで 3 種類のずれを示しています。
- 失敗の原因:参照実行では方策が衣類をつかんで落とし、これは動作実行の失敗です。生成されたロールアウトでは方策がかごをつかみに行き、対象を誤ったタスク計画の失敗になっています。どちらも失敗ですが、診断によって改善の方向が誤ったモジュールに向かいます。
- 失敗の段階:参照実行は配置の段階で失敗し、モデルは搬送の段階での失敗を予測します。最終結果は一致しても、失敗の位置は異なります。
- 失敗の境界:かごを動かすと参照成功率は急落するのに、モデルは高い成功率を予測し続け、方策が確実に動作する条件の範囲を過大に見積もります。
フィジカルAIラボ 1.8:評価では、1 つの「失敗」ラベルが失敗の仕方を覆い隠すことを扱いました。この論文は同じ問いを世界モデルの評価器そのものに向けます。評価器は失敗のタイプと位置を正しく捉えているのか、という問いです。
3 つのタスクと 6 つの指標
評価は閉ループで行います。各ステップで方策は観測履歴、ロボットの状態、タスク指示から動作を選び、世界モデルは次の観測を予測して方策に返します。参照実行も同じ手順でシミュレータまたは実機上で進みます。両者でタスク指示、方策、対応する初期条件を固定します。
| タスク | 問い | 指標 |
|---|---|---|
| 失敗の原因 | タスク計画の失敗と動作実行の失敗がそれぞれどれだけ起き、方策間で同じように変わるか | TFE:2 種類の失敗頻度の平均絶対差(低いほど良い)。TPC:各タイプの頻度の方策間 Pearson 相関(高いほど良い) |
| 失敗の段階 | 最初の決定的な失敗がどのサブゴール段階で起きるか | SFE:段階ごとの失敗頻度の絶対差の合計、範囲 0〜2(低いほど良い)。SPC:段階頻度の方策間 Pearson 相関 |
| 失敗の境界 | 近い場面条件の間で成功率が下がる方向と大きさ | OA:変化の方向が一致したペアの割合、同値は 0 点(高いほど良い)。GE:成功率の変化量の差の平均絶対値(低いほど良い) |
頻度はすべて全評価エピソードを分母とし、成功したエピソードも含みます。分類できない失敗は Indeterminate とし、段階が不明な失敗は分母にだけ残ります。比較の基準として、著者らは RoboTwin と LIBERO で同じ方策を同じ初期場面から参照環境で再実行し、2 回の参照実行を同じ指標で比べています。この Ref–Ref ベースラインにより、モデルのずれが参照実行そのもののランダムなばらつきを超えているかを判断します。
データの集め方
失敗の原因と段階の参照データとして、タスクと方策の組み合わせごとにランダム化した場面から 50 本の参照実行を集め、それぞれに対応する世界モデルでの実行を行います。
- LIBERO(シミュレーション、単腕):10 タスク × 3 方策(π0.5 と、微調整データの 50% と 20% だけを使う π0.5-data-50、π0.5-data-20)、計 1,500 本。
- RoboTwin(シミュレーション、双腕):20 タスク × 5 方策(LingBot-VLA-v2 と FastWAM を追加)、計 5,000 本。
- G1(実機、ヒューマノイド):ごみの掃き集めと衣類の回収の 2 タスク × タスク専用の方策バージョン 4 つ(V1〜V4)、計 400 本。
失敗の境界はシミュレーションでのみ構築します。物体の位置、向き、サイズのいずれか 1 つの要因を走査し、ほかの条件は固定します。条件ごとに 10 回の参照実行を行い、成功率の差が 30 ポイント以上ある隣り合った条件のペアを選びます。各プラットフォームで 60 組とその端点の順序を固定し、新しい乱数シードで参照成功率を独立に推定し直します。その後ペアの選び直しや順序の入れ替えは行いません。各世界モデルは各端点で同じ方策を 10 回実行します。論文本文にある「2 cm 刻みで成功率が 90% から 40% に下がる」という例は、著者らが明記しているとおり選定基準を説明するための仮の数値で、実測のペアではありません。
アノテーションは 2 段階です。結果の判定では、Doubao-Seed-2-1-Pro と ChatGPT 6 の 2 つのモデルが動画を判定して一致率は 90.1%、不一致はすべて 1 人の専門家が裁定します。一致したサンプルから全データの 10% にあたる分を無作為に抽出して確認したところ、人間の判断との一致率は 97% でした。シミュレーションの参照実行の最終結果は、シミュレータ固有の判定に従います。失敗のタイプと段階は 2 人の専門家がすべての失敗に付け、裁定前の一致率は 92%、不一致は 3 人目が解決します。
評価対象の 7 つの世界モデルは Ctrl-World、Cosmos-Predict-2.5、BWM、DreamDojo、GE-Sim 2.0、A2World、DW05 です。BWM は互換性のあるチェックポイントと適応用コードがなかったため、LIBERO と G1 では評価していません。
成功率の相関が最も高いモデルでも、失敗の診断は最良とは限らない
以下はすべて RoboTwin での結果で、各相関係数は 5 つの方策にもとづきます。
- 失敗のタイプ:DW05 は成功率の相関が最も高い(0.597)一方、計画の失敗と実行の失敗の相関は 0.456 と 0.348 にとどまります。タイプによって符号が逆になることもあり、A2World は参照の計画失敗と正の相関(0.353)、実行失敗と負の相関(−0.086)を示し、BWM はその逆です(−0.121 と 0.143)。総合 TPC の最高値は 0.402 です。7 モデルの TFE の平均は 0.159(DW05)から 0.335(Cosmos)で、2 種類の失敗頻度が平均 15.9〜33.5 ポイントずれていることになります。Ref–Ref は 0.061 です。
- 失敗の段階:7 モデルの SPC は −0.123 から 0.095 の範囲です。DW05 は成功率の相関 0.597 から SPC 0.052 に、GE-Sim は 0.260 から −0.004 に下がります。Ref–Ref はそれぞれ 0.942 と 0.903 です。SFE の平均は 0.633 から 0.817 で、Ref–Ref は 0.094 です。
論文の図 5 に具体例があります。FastWAM の blocks_ranking_size タスクでは、参照実行の失敗は「小さいブロックの把持」段階に集中し(66%)、「配置」段階は 16% です。DreamDojo が生成したロールアウトではこの 2 つが 6% と 46% になります。著者らによると、この把持から配置への移動は 5 つの方策すべてで見られます。これにもとづいて診断すると改善の重点は配置に置かれますが、参照環境での主な問題は把持にあります。
補足として、Ctrl-World は Token-World の記事でも比較対象として登場しました。そちらは別の論文が独自の評価設定で報告した数値で、ここでの RoboTwin の数値とは直接比較できません。
場面の小さな変化:方向を誤り、幅は圧縮される
RoboTwin の 60 組の境界ペアで、要因ごとの最高 OA は位置 0.685(A2World と BWM が同率)、向き 0.590(GE-Sim)、サイズ 0.758(Ctrl-World)です。Ref–Ref の OA は 0.95〜1.00、GE は 0.005〜0.020 です。OA の定義から、0.5 未満は、設定ごとに平均した上で、変化の方向を正しく判断できた割合が半分に満たないことを意味します。7 モデルのうち 6 つが向きで 0.5 を下回り、例外は GE-Sim だけです。
変化の大きさについては、7 モデル × 60 組の計 420 回の比較のうち 400 回(95.2%)が参照成功率の差の絶対値を過小評価しており、方策が実際より場面の変化に強いように見えます。図 6 は adjust_bottle での LingBot-VLA-v2 の例です。ボトルのヨー角が −60° から −80° に変わると、参照成功率は 100% から 0% に下がります。4 つのモデルは成功率の上昇を予測し、1 つは変化なしと予測しました。低下の方向を当てたのは A2World と GE-Sim だけで、どちらも予測した低下幅は 20 ポイントにすぎません。
弱点は要因によっても異なります。5 つのモデルは向きで OA が最も低く、DW05 と GE-Sim はサイズで最も低くなります。Ctrl-World の OA はサイズの 0.758 から向きの 0.359 に下がり、向きでの GE(0.719)も 7 モデル中で最も高い値です。GE-Sim は向きで 0.590 に達する一方、サイズでは 0.424 にとどまります。1 種類の摂動だけを試すと、もう一方を見落とします。著者らは、失敗の境界の評価を使って、世界モデルの予測をどの条件でまず参照環境で確かめる必要があるかを特定し、そのうえで以降のテストを計画することを提案しています。
制約と注意点
- これは arXiv のプレプリントで、数値はすべて著者報告 [R] です。本サイトでは再現していません。主な結果は RoboTwin のものだけで、LIBERO と G1 の結果は付録 D.4〜D.7 にあります。本サイトが読んだ本文は付録 A.1.3 で途切れており、Ref–Ref ベースラインの詳細(付録 A.4)、境界ペアの再推定の方法(付録 C)、表 15、図 10・図 11 の詳細なデータは読んでいません。
- 各相関係数は 5 つの方策だけで計算し、タスク間で平均しています。本サイトの判断では、こうした相関は個々の方策の変化に左右されやすいものです。読んだ範囲では、論文は信頼区間や有意性検定を示していません。
- 著者ら自身が挙げる制約:方策、タスク、境界条件の数は限られており、結論の一般性には限界があります。結果はアダプタやロールアウトの手順を含む世界モデルのシステム全体を評価したもので、個々のアーキテクチャ要素を切り分けてはいません。失敗ラベルは観察できる挙動を記述するもので、方策内部の原因を示すものではありません。
- 結果のアノテーションの一部は 2 つの視覚言語モデルに依存し、そのあと人による裁定と抜き取り確認を行っています。失敗のタイプは計画と実行の 2 種類だけです。表 1 のベンチマーク比較は著者ら自身による整理です。
- G1 の 4 つの方策バージョンは Kairos(arXiv 2606.16533)から引用されており、その著者リストには本論文の著者 2 人が含まれます。論文の冒頭には GitHub のコードリポジトリと Hugging Face のデータセットが記載されていますが、本サイトでは開いて内容を確認していません。
- 世界モデル内のロールアウトも、シミュレーションでの境界ペアも、ハードウェアの安全性の検証ではありません。
リンク
- WorldFailBench: Do World Models Understand Policy Failures?(arXiv 2610.33565)
- 論文 HTML 全文
- フロンティア・レーダー|Token-World:VLM の token 空間で世界モデルを展開し、RGB 再構成なしで VLA 方策をシミュレーションする
- フロンティア・レーダー|PhysCanvas:視覚・触覚・タスク状態を 1 枚のキャンバスに描き、凍結した 3 つの報酬モデルで世界モデル内の成否を実機に近づける
- フロンティア・レーダー特集|シミュレーションと評価:VLA の評価に初期状態成功率以外で欠けているもの
- フィジカルAIラボ 1.8:評価――「差し引き +2」を対応表に分解し、失敗ラベルと乱数シードを計算で確かめる
- フィジカルAIラボ:すべての数字を確認できるフィジカルAI講座(講座の概要)