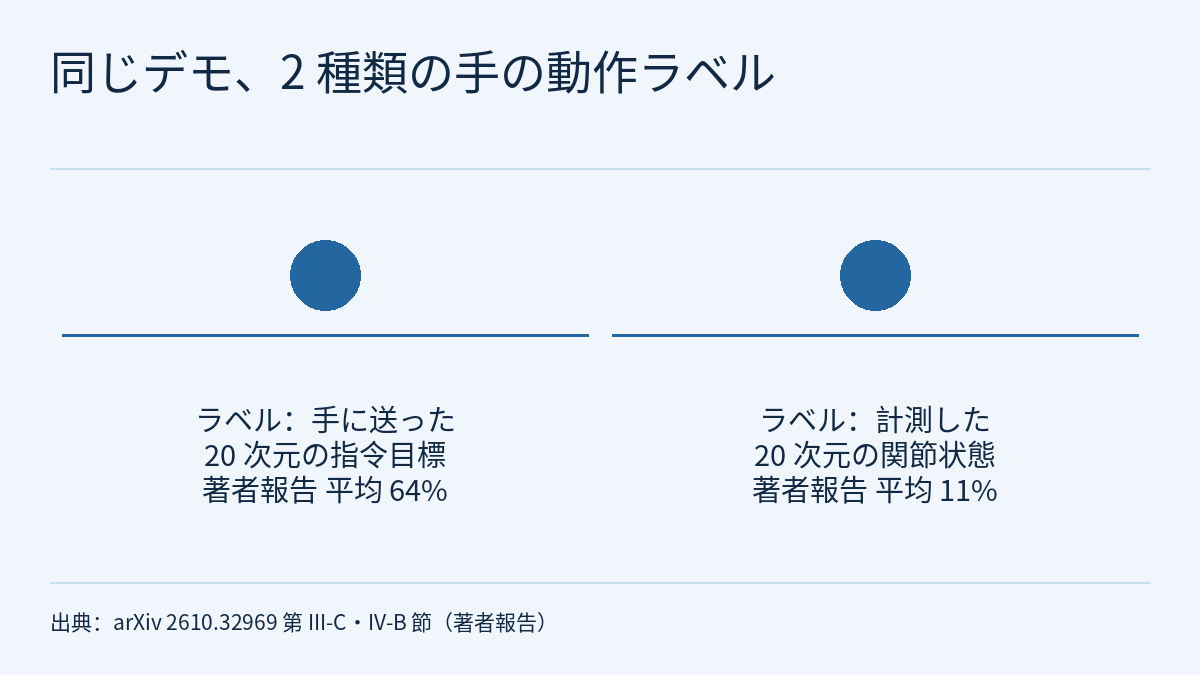
多指の器用なハンドのデモを集める代表的な 2 つの方法には、それぞれ弱点があります。遠隔操作はロボットが実行できる動作を記録できますが、ロボット一式が必要で、操作者は多数の指関節を協調させなければなりません。人の手によるデモは集めやすい一方、動きを推定してロボットハンドへリターゲットする必要があり、データにはロボットの動作が含まれません。プレプリント DexPort(arXiv 2610.32969、2026-10-23)は 3 つ目の道をとります。配備時に使うのと同じ 20 自由度の多指ハンドと魚眼カメラを着脱できる 1 つのモジュールにまとめ、収集時は手持ちのハンドルに、配備時はロボットの手首に取り付けます。操作者は少数のスキルで指を操作し、データには手に送った 20 次元の指令目標と計測した関節状態の両方が記録されます。著者らの報告では、同じデータで計測した関節状態ではなく指令目標を動作ラベルに使うと、成功率で採点する 3 タスクの最終成功率の平均が 11% から 64% に上がり、野外で集めた 1,000 本のデモを併用して学習すると、ピック・アンド・プレースの 3 つの評価条件の平均成功率が 36% から 78% に上がりました。本記事では「指令ラベルと状態ラベル」の比較から何が言えて何が言えないか、そして野外データと収集速度の 2 組の数字をどう読むかを中心に扱います。以下の数値はすべて著者の報告 [R] で、本サイトでは再現していません。
課題:多指ハンドのデモはなぜ集めにくいのか
平行グリッパーについては、UMI が手持ちのグリッパーでさまざまな環境のデモを自然に、規模を伴って集めています。著者らは、この方法を多指ハンドに広げるのは簡単ではないと述べます。DexUMI や DEXOP などは装着型の手の外骨格で接触の多い動作を集めますが、自由度が増えるほど機構は複雑になり、操作者の負担も重くなります。しかもこれらが記録するのは外骨格の構成であり、配備に使うロボットハンドが受け取る指令や、その結果の状態ではありません。RealDexUMI は実物のロボットハンドで実行可能な指令を記録しますが、示したハンドの能動自由度は 6 つだけです。
ここから著者らは、携帯型の収集インターフェースに 3 つの要件を掲げます。収集と配備に同じエンドエフェクタを使うこと(Same Emb.)で、手の動きをリターゲットせずに済むようにする。手に送った指令を記録すること(Action Data)で、後の計測状態から動作を逆算するだけにしない。接触中は指令目標と計測した関節状態が異なりうるためです。そして十分な数の制御可能な自由度(DoF)を備えること。そうでなければ、より単純なグリッパーで足ります。論文の表 I はこの 3 項目と重量で既存のシステムを比べています。以下はその抜粋です(著者らの整理)。
| システム | 制御可能な自由度 | 重量 | 同じ身体 | 指令の記録 |
|---|---|---|---|---|
| UMI | 1 | 780 g | ✓ | ✗ |
| DexUMI | 12/6 | 850 g | ✓ | ✗ |
| DEX-Mouse | 6 | > 1000 g | ✓ | ✓ |
| RealDexUMI | 6 | 680 g | ✓ | ✓ |
| DexPort | 20 | 955 g | ✓ | ✓ |
ハードウェア:1 つのハンド・カメラモジュールを 2 通りに取り付ける
モジュールは、5 指・20 自由度の Wuji ロボットハンドと広角の魚眼カメラ(付録によれば 200° の魚眼レンズ付き USB ボードカメラ)を、3D プリントした剛性のフランジで一体にしたものです。収集時は Meta Quest 2 コントローラーを改造した収集用ハンドルに取り付け、配備時は同じ物理モジュールをロボットの手首に取り付けます。そのため、手の身体とカメラから手への外部パラメータは両方の場面で変わりません。著者らは Wuji 1 と Wuji 2 の 2 種類のハンドそれぞれにフランジを設計しています。
- 何を記録するか。Quest 2 コントローラーが手首の 6 自由度の軌跡を、魚眼カメラが手と物体の相互作用と周囲の場面を捉え、ハンドのコントローラーが 20 次元の指令関節目標とその結果の関節状態の両方を記録します。記録ループは 1 つで 30 Hz で動き、カメラ、ハンド、コントローラーはそれぞれバックグラウンドのスレッドで読み取られます。収集と配備で同じ 30 Hz のループを使うので遅延はおおむね一致すると著者らは考え、UMI のように各ストリームの遅延を測ったり後処理で時間をそろえたりはしていません。
- 重量。手持ちの組立品全体は 0.955 kg で、そのうちハンド以外の部品が 0.220 kg です。手の甲にかけるストラップが荷重の一部を受けます。当初の設計ではコントローラーをハンドの後ろに置いたため、握る位置が組立品の重心からずれてモーメントアームが長くなりました。最終設計ではコントローラーをハンドの上に移し、握る位置を重心の近くにして、操作者の手首が受け止めるトルクを減らしています。
- 配備時のキャリブレーション。収集したエンドエフェクタの動作は Quest コントローラーの座標系で表されており、配備時にはロボットのエンドエフェクタ座標系に直す必要があります。著者らはモジュールをロボットのフランジにボルトで固定し、フランジの軸を 30° 以上傾ける約 30 の姿勢にアームを動かし、各姿勢で 1.5 秒止めてからフランジとコントローラーの姿勢の組を記録します。閉形式のハンド・アイ解で初期化し、非線形最小二乗で詰めて、コントローラーからフランジへの固定変換を求めます。左右のアームでそれぞれ 1 回行います。20 次元の手の目標は変換が要りません。
- 配備先。方策は 7 自由度のアームを 2 本持つ双腕ロボット Tianji Marvin に配備されます。ピック・アンド・プレースとねじ回しには Wuji 1 を、引き出しへの収納と両手でのバーコード読み取りには Wuji 2 を使います。Wuji 1 では、手の目標が 5 Hz のローパスフィルタを通ったあとハンドのファームウェアで 1 kHz に補間され、関節ごとのトルク上限は 0.5 N·m です。
スキルは操作者を助けるだけで、方策は生の指令を学ぶ
Quest 2 コントローラーにはボタン 2 つ、連続値のトリガー 2 つ、2 軸のジョイスティック 1 つしかありません。これで 20 個の関節を動かすため、著者らは指の動きをいくつかのパラメータ付きスキルにまとめています。
- 親指の操作:ジョイスティックの 2 軸で親指の屈曲・伸展と内転・外転をそれぞれ操作します。HATO のやり方に倣っています。
- パワーグラスプ:ジョイスティックの 1 軸で親指以外の 4 指をまとめて閉じます。倒すと少しずつ締めたり緩めたりでき、離すと現在の目標を保つので、押し続ける必要はありません。
- ピンチグラスプ:同じ増分の指令で人差し指だけを動かし、別に位置を決めた親指に向けて閉じます。小さな物体や、指先の正確な接触が必要なつかみ方に使います。
- 2 指グラスプ:人差し指と中指をそろえて開閉し、ほかの指は目標を保ちます。複数の物体をつかむ、2 指でつかんで引くといった多段階の動作に使います。
- 手の中での回転:ボタンを押すと学習済みの閉ループ方策が呼び出され、手に持った道具を回すのに必要な指の持ち替えを繰り返します。操作者は手全体の動きを引き続き操作します。
手の中での回転スキルは Isaac Lab で PPO により学習しています。ドライバーは回転関節で回る 12 角柱としてモデル化し、シミュレーションでは手の土台を固定します。方策は 12 個の関節を操作し、薬指と小指は固定です。物体の質量、重心、摩擦、反発係数、指の PD ゲイン、初期の握り、ランダムな外乱力をランダム化し、4096 個の並列環境で合計 1.18 × 10⁸ 環境ステップ学習します。収集時には、この 3 層 MLP がハンドの関節エンコーダーの値を使って 20 Hz で動きます。
スキルは操作者を助けるためだけのものです。学習する方策は拡散方策(1D 畳み込み U-Net のデノイザーと、ファインチューニングした DINOv2 ViT-S/14 の視覚エンコーダー)です。直近 2 つの時間ステップを観測し、各ステップは 224 × 224 の RGB 画像、現在の動作チャンクの始点に対するエンドエフェクタの位置、計測した 20 自由度の手の状態からなります。出力は 16 ステップの動作チャンクで、各ステップは 29 次元です。手首が 9 次元(並進 3 と 6D 回転)、手が 20 次元(関節の絶対目標)です。方策はスキルの種類、スキルのパラメータ、タスクの段階のラベルを受け取らず、記録された指令関節目標を直接予測します。配備時は 30 Hz で非同期に推論し、新しいチャンクごとに最初の 8 ステップを残し、時刻を過ぎたステップは捨て、各制御時刻ではその時刻を含むすべてのチャンクを平均します。手首の動作はキャリブレーションで求めた変換を通し、PyRoki の Levenberg–Marquardt 逆運動学で 7 自由度アームの関節角に解きます。
著者らは、動作ラベルを指令目標から計測した関節状態に切り替えることが「状態を動作とする」ベースラインを定める唯一の変更であり、学習手順のほかの部分はすべて共通だと明記しています。
中心となる比較:同じデモで、動作ラベルだけを替える
4 つの評価タスクは、それぞれ異なる器用さを試します。野菜のピック・アンド・プレース(2 つの野菜を順に皿へ置く。形や大きさに応じてピンチとパワーグラスプを選ぶ必要がある)、ねじ回し(安定した握りを保ちながらドライバーを手の中で回す)、引き出しへの収納(持った物体を離さずに同じ手で引き出しを開け、物体を入れて閉める。つかんだ物体が視野の大半をふさぐため第三者視点のカメラを追加)、両手でのバーコード読み取り(片手で物体をつかんで差し出し、もう片方の手でスキャナーの位置を合わせて操作する)です。各方策は、タスクまたは評価条件ごとに 15 回評価されます。引き出しへの収納と両手での読み取りは段階ごとに採点し、ある段階はそれより前の段階がすべて成功したときだけ成功と数えます。ねじ回しは平均の保持時間(秒)と毎分の回転数を報告します。
著者らの報告は次のとおりです。
- 成功率で採点する 3 タスクでは、指令ラベルの方策の最終成功率の平均が 64%、状態ラベルのベースラインが 11% で、差は 53 ポイントです(本サイトの計算)。評価手順からすると、この 3 つはピック・アンド・プレース、引き出しへの収納、両手での読み取りのはずです。読んだ本文にはタスクごとの最終成功率は載っておらず(図 4 にあります)、ピック・アンド・プレースでどの評価条件を使ったかも書かれていません。
- 両手での読み取りでは、ベースラインは 80% の回で 1 つ目の物体をつかみ、両方を保持できたのは 13% で、読み取りを完了したことは一度もありません。著者らは、後の段階が前の段階の成功を前提とするため、差が一定のずれとして現れるのではなく段階ごとに積み重なると指摘しています。
- ねじ回しでは、ベースラインは指令ラベルの方策の 2 倍以上長く道具を保持しました(31.7 秒対 15.6 秒)が、回転の速さは 3 分の 1 でした。
- 著者らが述べる失敗の様子:ベースラインは握りが弱く、スキャナーに差し出すときに荷物を落とし、引き出しを引き始めると洗濯物が手から滑り落ちます(図 6)。
この比較を読むときの注意点は次のとおりです。
- これは同じ DexPort データでのラベルのアブレーションであり、収集インターフェース同士の比較ではありません。2 つの方策は観測、ネットワーク、学習手順が共通で、動作ラベルだけが異なります。著者らはここから、動作データを持たない外骨格型のインターフェースには大きな制約があると推論しますが、これは外挿であり、論文は外骨格で集めたデータでの実験を行っていません。
- なぜ差が接触の場面で出るのか。論文が挙げる理由は、接触中は指令目標と計測状態が異なりうること、そして指令を使えば物体をしっかり保持するのに必要な力を出せることです。本サイトの解釈では、指が物体に阻まれると計測される関節位置は物体の表面で止まりますが、指令目標はさらに奥へ進められます。計測状態を目標として再現すると、この差が失われます。読んだ本文には力の測定はなく、指令と状態の差がどれだけかも報告されていません。
- 「長く保持した」は「うまくできた」と同じではありません。ねじ回しでは、ベースラインは保持時間で上回り、回転の速さで下回りました。1 つの指標だけを見ると逆の結論になりうるため、著者らは両方を報告しています。
- 標本の大きさ。各タスク 15 回なので、80% は約 12 回、13% は約 2 回に当たります(本サイトの換算)。読んだ本文には信頼区間、反復回数、乱数シードは報告されていません。
- どの段階の指令を記録しているか。Wuji 1 では手の目標が 5 Hz のローパスフィルタを通ってからファームウェアで補間されますが、記録した指令目標がフィルタの前か後かは、読んだ本文には書かれていません。
野外データと収集の速さ
実験室では合計 1,605 本のデモを集めています。野菜のピック・アンド・プレース 700 本、ドライバー 200 本、引き出しへの収納 380 本、両手での読み取り 325 本です。これとは別に、アパートやオフィスなど構造化されていない環境でピック・アンド・プレースのデモを 1,000 本集め、合計は 2,605 本です(本サイトの合算)。野外データは実験室と同じ学習用の物体を使っており、違うのは物体そのものではなく、場面、背景、照明です。収集にはロボットアームも外部のトラッキング設備も要りません。併用学習では各バッチの 50% を野外データから取り、各方策はそれぞれの実験室デモに対して同じエポック数(約 250)だけ学習します。
論文の表 III は、実験室データ量 2 通りでのピック・アンド・プレースの完全成功率(2 つとも皿に置けた割合、%)を示しています。各条件 15 回です。
| 実験室のデモ | 野外のデモ | 既知の物体 | 未知の物体 | 妨害物あり |
|---|---|---|---|---|
| 500 | 0 | 0 | 20 | 0 |
| 500 | 500 | 33 | 13 | 53 |
| 500 | 1,000 | 47 | 7 | 40 |
| 700 | 0 | 47 | 20 | 40 |
| 700 | 500 | 53 | 53 | 53 |
| 700 | 1,000 | 73 | 73 | 87 |
- 36% から 78% は、実験室デモ 700 本の場合の 3 つの欄の平均です。(47 + 20 + 40) ÷ 3 ≈ 36、(73 + 73 + 87) ÷ 3 ≈ 78 です(本サイトの確認)。各欄 15 回で換算すると、妨害物ありの列は約 6 回から約 13 回に、未知の物体は約 3 回から約 11 回に増えています。
- 「野外データが増えるほどすべての条件で上がる」は 700 本の組でしか成り立ちません。500 本の組では、未知の物体が 20% から 13%、さらに 7% へと下がり、妨害物ありは 0% から 53% に上がったあと 40% に戻っています。著者らは、野外データが増やしたのは場面の多様性で物体の形状ではないと説明し、この頑健さを新しい物体に移すには十分に大きな実験室データが要るのではないかと推測しています。これは著者らの仮説で、論文は別途検証していません。
- ネットワークの大きさが同じではありません。付録の表 VI では、「ピック・アンド・プレース野外」の設定の U-Net チャネルが (512, 1024, 2048)、「ピック・アンド・プレースのベースライン」が (256, 512, 1024) です。「ピック・アンド・プレースのベースライン」がどの方策を指すのかは、読んだ本文には明記されていません。実験室データだけで学習したピック・アンド・プレースの方策が小さいネットワークを使っていたのなら、併用学習による向上にはモデル容量の違いも混ざります。
収集の速さは、片手のピック・アンド・プレースで 30 分間連続して操作したときに集まった軌跡の本数で数えています(表 II)。どの方法でも操作者は熟練者です。
| 方法 | 軌跡数 / 30 分 | 携帯できる | 同じ手の身体 | 動作データ |
|---|---|---|---|---|
| DexPort | 122 | ✓ | ✓ | ✓ |
| スキル遠隔操作(同じスキルでハンドを操作し、VR トラッキングでエンドエフェクタを操作) | 68 | ✗ | ✓ | ✓ |
| グローブ遠隔操作(Wuji Glove で手を追跡し、VR コントローラーでエンドエフェクタを操作) | 86 | ✗ | ✓ | ✓ |
| 人の手 | 275 | ✓ | ✗ | ✗ |
ここから得られる約 1.4 倍(グローブ遠隔操作に対して)、約 1.8 倍(スキル遠隔操作に対して)、人の手が約 2.3 倍速いという値は、いずれもこの 1 回の 30 分間の本数の比です。著者らは遠隔操作が遅い理由を、操作者が場面の外にいて直接の視覚・触覚の手がかりを失うためだとしていますが、これは著者らの説明で、論文は別途検証していません。著者らは人の手のデモを、配備するハンドの身体も指令動作も持たないため、競合するデータ源ではなく速さの上限とみなしています。読んだ本文には、各方法を何人の操作者が担当したか、何回数えたかは書かれておらず、各方法で集めた軌跡の成功率や質の比較もありません。
本サイトのほかの記事との関係
フィジカルAIラボ 1.5:データはどこから来る? は、遠隔操作、人の動画、合成という 3 つの入手ルートを扱い、次元数が同じ動作空間でも意味が異なりうることを強調しました。DexPort は遠隔操作と人の手のデモのあいだに位置します。操作者がロボットハンドそのものを持って環境に入るので、動作空間は配備するハンドの動作空間です。そしてラベルのアブレーションは、同じハンド、同じ 20 次元の動作でも「送った指令」と「計測した状態」は別のラベルであることを示しています。方策そのものは フィジカルAIラボ 1.6:模倣学習 で扱った拡散方策で、野外データの併用学習の結果は、同じ回の「量を積むより多様性が大事」という議論とも関係します。ただしここで増えたのは場面の多様性だけです。15 回の評価、段階をつないだ成功率、保持時間と回転の速さが逆を指すことは、フィジカルAIラボ 1.8:評価 の方法で読めます。手の中での回転スキルはシミュレーションでダイナミクスのランダム化を使って学習しています。考え方は フィジカルAIラボ 2.5:sim2real のドメインランダム化とシステム同定 を参照してください。読んだ本文には、このスキル単体の成功率は報告されていません。
以前の フロンティア・レーダー|DexStitch は別の道をとり、人の動画から多指ハンドのスキルを切り出してロボットのデータに変換します。DexPort は人からロボットへの変換を避けますが、その代わり操作者は実物のロボットハンドを持ち歩く必要があり、手持ちの組立品は 1 kg 近くあります。2 本の論文はタスク、ハードウェア、指標が異なるため、数値を比べることはできません。
制約と注意点
- arXiv のプレプリントであり、数値はすべて著者の報告 [R] です。本サイトでは再現していません。各タスクまたは条件の評価は 15 回で、読んだ本文には信頼区間、反復回数、乱数シードがありません。
- 本記事は論文の HTML 本文と表の文字にもとづいており、図 4 などの図から数値を読み取ってはいません。4 タスクそれぞれの最終成功率やねじ回しの具体的な回転数は図にあり、ここでは引用していません。
- 64% 対 11% は同じデータでの動作ラベルのアブレーションです。論文には外骨格やほかのインターフェースで集めたデータとの比較はなく、「外骨格型インターフェースの大きな制約」は著者らの推論です。
- 野外データはピック・アンド・プレースだけに使われ、物体は実験室と同じです。引き出しへの収納では第三者視点のカメラも使っています。記録した画像には操作者が映ることがあり、著者らは取り除く処理をしていません。
- 著者らが挙げる制約:人間工学的な設計にもかかわらず、装置の重さが連続使用と回転の多い動作を制限すること、スキルが器用な動作の一部しかカバーしないこと。
- 実験は実機ロボットで行われていますが、読んだ本文には安全性の評価はなく、これらの結果はハードウェアの安全性を検証したものではありません。
- 論文は動画ページ amberxie88.github.io/dexport/ を挙げています。読んだ本文には、コード、ハードウェアの設計、データセットが公開されているかは書かれていません。本サイトは執筆時にこのページを開いて内容を確認していません。
- 「差は 53 ポイント」「合計 2,605 本」「約 12 回」「約 2 回」などの回数、各倍率と平均の確認は、論文の数値から本サイトが行った換算です。
リンク
- DexPort: A Hand-Held Skill Interface for Dexterous Hand Data Collection(arXiv 2610.32969)
- 論文の HTML 全文
- フィジカルAIラボ 1.5:データはどこから来る?――SO-101 のメタデータからお手本の長さを求め、三つの入手ルートの単位と動作空間を見分ける
- フィジカルAIラボ 1.6:模倣学習――誤差がお手本のカバー範囲からはみ出すまでを手で計算し、ACT・拡散方策・データのスケーリング則の数字をそれぞれの条件に照らして読む
- フィジカルAIラボ 1.8:評価――「差し引き +2」を対応表に分解し、失敗ラベルと乱数シードを計算で確かめる
- フィジカルAIラボ 2.5:sim2real のドメインランダム化とシステム同定――二本の論文の数字を元の設定に戻し、コップを押した一本の軌跡から摩擦を手で求める
- フロンティア・レーダー|DexStitch:「遷移」もスキルとしてラベル付けし、人間の動画から多指ハンドのスキルを切り出し、変換し、つなぎ合わせる
- フィジカルAIラボ:すべての数字を確認できるフィジカルAI講座(講座の概要)