この回の動画
ナレーションは AI 合成音声です。 動画の章・文字起こし・出典
文字起こし
文字起こし
知行の問い
パソコンの中ではちゃんと練習できてたのに、現実に持っていくと、どうしてうまくいかないの?今回のテーマは、シムツーリアル。なぜギャップが生まれるのか?埋める方法は二つ。ドメインランダム化と、システム同定です。
現実とのギャップ
二点一の回と同じ、机とコップの場面です。今回は、コップを水平に押してみます。まずはシミュレーションで一押し。コップは滑っていき、摩擦で、だんだん止まります。どこで止まるかは、三つで決まります。コップの重さ、机の滑りやすさ、そして動作の遅れ。同じ一押しでも、摩擦を変えると、止まる場所が変わります。ここが、やっかいなところです。シミュレーションなら、この三つの数は自分で決められます。でも実機では、はっきり分かりません。シミュレーションとじっきが合わない。これを、現実とのギャップと呼びます。摩擦も、質量も、遅延も、みんなずれるかもしれません。さらに、センサーのノイズや、モデルに入っていない摩擦。実機での想定外は、数えきれません。実機の例を一つ。同じコマンドでも、モーターが熱くなると、出てくる力が変わります。ギアの隙間や、ケーブルの引っぱりもあります。こうした細かい点は、シミュレーションには初めから入っていません。シミュレーションでは、摩擦はきれいな一つの数です。実機では、場所ごとにばらばらです。定番の方法は、ドメインランダム化の論文から来ています。論文によると、学習に使ったのは、シミュレーションのランダムな模様だけ。それでも現実の世界で、位置の精度は一点五センチに達しました。発想がみごとです。シミュレーションを本物そっくりにするのではなく、十分に多様にするのです。変化が十分に多ければ、現実の世界も、見てきたバリエーションの一つのように見えるかもしれません。論文の設定では、学習に使ったのはシミュレーションの画像だけです。シミュレーションをもっとリアルにするんじゃなくて、もっとごちゃまぜにするんだ!
ドメインランダム化
ドメインランダム化のやり方は?学習の一回ごとに、シミュレーションのパラメータを、ランダムに入れかえます。注意してほしいのは、ノイズを少し足すのではないこと。一回ごとに、世界をまるごと入れかえるのです。ドメインランダム化は、直訳すれば、ドメインをランダムにすること。ドメインとは、パラメータがとりうる値の範囲のことです。まず摩擦。ムジョコの標準では、すべり摩擦係数は一です。現実の表面はさまざまなので、ランダムにします。次は遅延。この講座では、遅延をステップ幅の整数倍で再現します。ステップは標準で二ミリ秒。遅延とは、何ステップかためてから実行すること。遅延のランダム化とは、一回ごとに、ためるステップ数を変えること。少し速いときも、少し遅いときもあります。しつりょうもあります。軽いコップは、一押しで飛んでいく。重いコップは、押すのが大変。これもランダムにします。ムジョコなら、これを変えるのは簡単。モデルの摩擦と質量を直接書きかえて、リセットするだけです。遅延も簡単です。制御の信号を、少し待たせてから送れば、遅れて届く様子を再現できます。やってみましょう。ノートブックで何回も走らせ、毎回パラメータを変えます。結果がどこに散らばるかを見ます。毎回の止まった場所を、分布の図にします。同じ動作なのに、結果は一面に広がります。この一面の広がりこそが大事です。方策がその全体でうまくいって、はじめて実機に移せます。評価も同じです。一つの環境だけでなく、広がり全体で試しましょう。遅延だけでも手ごわい。実機のフィードバックは、シミュレーションより少し遅れることが多いのです。範囲の決め方は、職人芸です。狭すぎれば意味がなく、広すぎれば方策がにぶくなります。もう一本の論文は、動力学をランダム化しました。シミュレーションで学習した方策を、そのまま実機に移します。論文によると、実機での学習なしで、論文で試した、物を押す課題をこなせました。これが、ドメインランダム化の自信の源です。よく分からないものを、練習問題にしちゃうなんて、すごく頭がいい!
システム同定
発想を変えてみましょう。範囲を広げるより、本当のパラメータを、直接測ってしまうのです。実際のデータから、モデルのパラメータを逆算する。これを、システムどうていと呼びます。目的は一つ、シミュレーションを実機に近づけること。やり方は単純です。実機に動作を一つさせて、その軌跡を記録します。位置、速度、時刻をすべて残します。なぜ何回か測って平均しないのか?ほしいのはパラメータで、平均の止まる場所ではないからです。次に、シミュレーションでパラメータを調整します。シミュレーションの軌跡が、実機の軌跡と重なるまで。摩擦の同定を実演します。まず、ある摩擦の値を本物とみなして、それで軌跡を一本作ります。次に、損失を決めます。候補の摩擦で出した軌跡が、本物の軌跡とどれだけずれるか。それが損失です。候補の値を一通り試します。損失がいちばん低いものが、特定された摩擦です。損失の曲線は、U字の形です。U字の底の点が、正しい摩擦にあたります。結果はきれいです。当てはめた摩擦は、最初に決めた本当の値と、ほとんど同じ。軌跡が重なったのは、シミュレーションの動力学が、実機に近づいたということ。この一歩が、同定のいちばん大事なところです。同定した摩擦は、シミュレーションに戻せます。次の学習は、もっと確かになります。一つずつ試すのは効率が悪い?最適化ツールに任せて、損失の最低点を自動で探させましょう。ただし、この同定には前提があります。モデルの構造が正しいこと、データが十分なこと、そしてパラメータが特定できること。同定しやすいパラメータもあります。たとえば摩擦。難しいものもあります。たとえば、ノイズに埋もれた小さな量。実際には、二つの方法をよく組み合わせます。まず同定で範囲をしぼり、残ったずれはランダム化で受け止めます。動かしながら同定することもできます。実機でデータを集めながら、シミュレーションを更新するのです。こうしたオンラインのやり方は、てきおうシミュレーションとも呼ばれます。シミュレーションが実機を追いかけて、少しずつ校正されていきます。つまり、目的は一言で言えます。シミュレーションで学んだことが、実機でも役に立つこと。広げるほうと、しぼるほう。この二つ、いいコンビだったんだ!ふりかえりです。ポイントは三つ。一つ、シミュレーションと実機にはギャップがある。二つ、ドメインランダム化は、不確かさを練習問題にする。三つ、システム同定は、本当のパラメータを測る。シミュレーションと現実の隙間って、こうやって埋めるんだ!パラメータが合って、モデルをロボットに載せたら、今度は遅延と計算力がどう効いてくる?また次回!
根拠と出典
2ミリ秒 · MuJoCo の標準のシミュレーション時間ステップ(0.002 秒) [O] · MuJoCo ドキュメント · XML Reference(v3.14.0)
練習とセルフチェック
小テストは公開で、回答するとすぐ解説が出ます。読み物の練習問題の答えはログイン会員向けです。
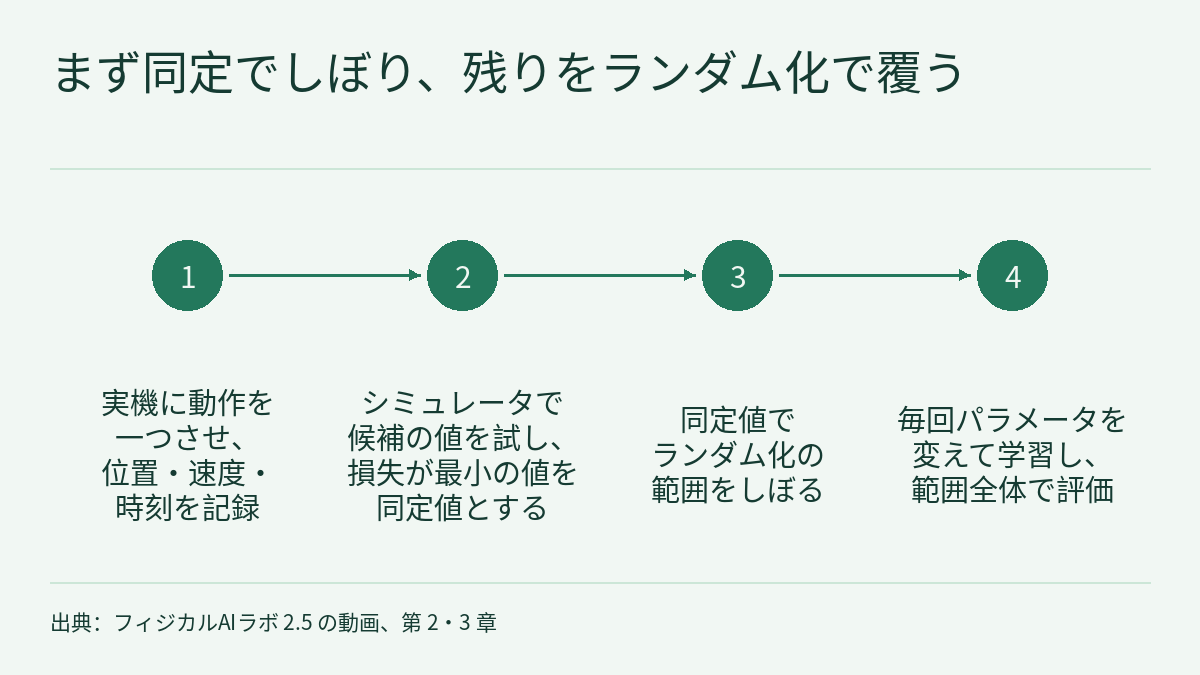
第 2.5 回の動画は、シミュレーションから実機への移行(sim2real)を扱います。ポイントは三つです。シミュレーションと実機の間には「現実とのギャップ」があり、摩擦、質量、遅延、センサーのノイズがどれも合わない可能性があること。ドメインランダム化は、学習の一回ごとにシミュレーションのパラメータをランダムに入れかえ、本物そっくりではなく多様さを求めることで、方策が幅広い状況で成り立つようにすること。システム同定は逆に、実機のデータからパラメータを逆算すること。動画では一本の軌跡から摩擦を当てはめる様子を実演し、実際にはまず同定で範囲をしぼり、残ったずれをランダム化で受け止める、という組み合わせがよく使われると述べています。動画の四枚の数字カードは、三つの公開資料に基づいています(MuJoCo XML Reference の二か所の属性説明がそれぞれ一枚に対応します)。Tobin らのドメインランダム化の論文(arXiv 1703.06907)によると、ランダムな模様のシミュレーションデータだけで学習し、現実の世界での物体の位置推定精度は 1.5 cm に達しました。MuJoCo の XML Reference(v3.14.0)には、標準の滑り摩擦係数が 1、標準のステップ幅が 0.002 秒と書かれています。Peng らの動力学ランダム化の論文(arXiv 1710.06537)によると、方策を実機で学習させなくても、論文で試したロボットアームで物を押す課題をこなせました。このページはこの回の解説と練習です。文字起こしを繰り返すのではなく、動画が軽く触れただけの三つのことを扱います。二本の論文の数字をそれぞれの課題と設定に戻し、一方はレンダリングを、もう一方は動力学をランダム化していることを確かめる。二つの MuJoCo ドキュメントの一節を読み、コップの場面で「摩擦、質量、遅延をランダム化する」とき、それぞれモデルのどの量を、どの単位で変えるのかをはっきりさせる。そして架空のコップで損失の曲線を手で計算し、止まった位置だけでは摩擦と質量を切り分けられないのに、時刻付きの速度なら切り分けられる理由を見る、です。全体を通すルールは、ランダム化の範囲や同定値には、モデルのどの量を変えるのか、単位は何か、どのデータから来たのかを書くこと、そして論文の数字はその論文の課題だけのものだ、ということです。
この回の動画、文字起こし、出典はこのページの上部にあります。シーズン全体の構成は講座の概要をご覧ください。前回のフィジカルAIラボ 2.4:Isaac Lab で並列に歩く練習――ベンチマーク表の 3 つの FPS 列を読み、学習コマンドから総ステップ数を計算するは、シミュレーションでは安定して歩けても、実機で転んだらどうするのか、という問いで終わりました。この回はそこから始めます。机とコップの場面はフィジカルAIラボ 2.1:MuJoCo でつかむ場面をつくる――XML に書かれていない質量・単位・ステップ幅・衝突ルールを計算で確かめるのものを使います。MJCF に書かれていない標準の質量、密度、ステップ幅はその回で計算しました。評価をどう対応づけ、失敗ラベルと乱数シードをどう記録するかはフィジカルAIラボ 1.8:評価――「差し引き +2」を対応表に分解し、失敗ラベルと乱数シードを計算で確かめるで練習しました。この回ではそれらを繰り返しません。実機での遅延、量子化、制御周波数は次回(2.6)の内容で、この回では遅延をシミュレーションの中の一つのパラメータとしてだけ扱います。
公開小テストの 5 問には詳しい解説が付いています。ログインすると、三つの練習に取り組めます。架空のコップのドメインランダム化の仕様を書き、各パラメータを MuJoCo モデルの具体的な量に対応させ、遅延をミリ秒からステップ数に換算し、ステップ幅を変えた後に範囲が何を意味するかを確かめる。架空のコップを押した軌跡から損失のスキャンを手で計算し、摩擦、質量、遅延がそのデータから同定できるかを一つずつ判定する。二本の論文を引用した架空の sim2real 計画を審査し、各文を原文の条件に戻してから、「まず同定し、次にランダム化する」形に範囲と評価の計画を書き直す。いずれにも段階的な解答例、よくある誤り、20 点満点の採点基準が付いています。
1. 二本の論文は、それぞれ何をランダム化し、何を報告したか
どちらも arXiv のプレプリントで、この講座の区分では R レベルです。以下の数字はすべて著者の報告で、本サイトは再現していません。この回が読んだのは、二本の論文の HTML 版の要旨と最初のいくつかの節です。Tobin らは手法の節のモデル構造の冒頭まで、Peng らは状態と行動の定義までです。
Tobin ら:ランダム化するのはレンダリング。動画の「1.5 センチ」の数字カードは、要旨の次の一文に対応します。
We find that it is possible to train a real-world object detector that is accurate to 1.5 cm and robust to distractors and partial occlusions using only data from a simulator with non-realistic random textures.
この文が述べているのは物体検出器です。入力は一台の単眼カメラの一枚の画像で、出力は対象の物体それぞれのデカルト座標です。論文は物体の位置推定を一般的な操作スキルへの一歩と位置づけ、検出器を使って散らかった環境での把持を実演しています。カメラは未校正で、一枚の画像しか使わないため、論文はシミュレーションの机の高さを固定しており、実質的には二次元の位置推定になっています。手法の節には、学習サンプルごとにランダム化する七つの項目が挙げられています。
- 机の上の妨害物体の数と形(一つの場面に 0〜10 個)
- 机の上のすべての物体の位置と模様
- 机、床、スカイボックス、ロボットの模様
- カメラの位置、向き、視野
- 場面の照明の数
- 照明の位置、向き、鏡面反射の特性
- 画像に加えるランダムなノイズの種類と量
模様は三種類からランダムに選びます。ランダムな RGB 値一つ、二つのランダムな RGB 値の間のグラデーション、二つのランダムな RGB 値のチェッカー模様です。カメラは、手で置いた初期位置のまわりの 10 × 5 × 10 cm の箱の中にランダムに置かれ、視線は机の上の固定点に向けたうえで各方向に最大 0.1 ラジアンずらし、視野は最大 5% 拡大・縮小します。画像は MuJoCo に組み込まれたレンダラーで作り、論文はこのレンダラーが写真のようなリアルさを目指したものではないと述べています。つまり動画の「ランダムな模様だけで学習」は要旨の言い方で、手法では模様よりずっと多くのものをランダム化しています。論文の序論は、システム同定を十分に行っても、現実の世界には今のシミュレータが捉えていない効果があると述べ、例として非剛性、ギアのバックラッシュ、摩耗、流体力学を挙げています。この論文が扱うのは、そのうち低忠実度のカメラ画像という部分だけです。手法の節に挙げられたランダム化の項目に摩擦、質量、遅延は含まれておらず、1.5 cm は論文のいくつかの幾何学的な物体、その机、そのカメラで測った位置推定の精度です。
Peng ら:ランダム化するのは物理。動画の「実機での学習なし」の数字カードは、要旨の次の二文に対応します。
This adaptivity enables the policies to generalize to the dynamics of the real world without any training on the physical system. Our approach is demonstrated on an object pushing task using a robotic arm.
論文の課題は、7 自由度の Fetch Robotics のロボットアームで、机の上の円盤形の物体(puck)を、回ごとにランダムに決まる目標位置まで押すことです。物体が目標から決められた距離の内側にあれば報酬は 0、そうでなければ −1 で、このまばらな報酬には Hindsight Experience Replay を使います。方策はリカレントニューラルネットワークで、シミュレーションのモデルには MuJoCo を使っています。学習の目的は、一つの動力学モデルのもとで収益を最大化することから、動力学パラメータ μ の分布全体での期待収益を最大化することに変わります。要旨は、シミュレーションだけで学習したにもかかわらず、方策は実機に載せても同程度の性能を保ち、大きな校正誤差にも頑健だったと述べています。本文はさらに、記憶を持つ方策は記憶を持たない順伝播型の方策より学習中の変動にうまく対応でき、現実の世界の動力学にもよく汎化すると述べています。これらは著者の主張です。注意したいのは、「実機で学習しない」は「実機で試さない」という意味ではないことです。論文の結論は、まさに実機に載せたうえで得られています。この回が読んだ本文は、手法の節で状態と行動を定義するところで終わっており、ランダム化したパラメータの一覧、それぞれの範囲、成功率、試行回数は含まれていません。そのため、この回は論文に代わってそれらを挙げません。
| 論文 | ランダム化したもの | 学習させたもの | 報告された結果(R、著者の報告) | ここから言えないこと |
|---|---|---|---|---|
| Tobin ら、arXiv 1703.06907 | レンダリング:模様、カメラ、照明、妨害物体、画像のノイズ | 一枚の画像から物体の位置を推定する検出器 | 現実の世界での位置推定精度は約 1.5 cm、妨害物体と部分的な遮蔽に頑健 | 摩擦、質量、遅延についての結論。押したコップの止まる位置の誤差 |
| Peng ら、arXiv 1710.06537 | シミュレーションの動力学(この回が読んだ本文にはパラメータの一覧がない) | 物体を押すリカレントニューラルネットワークの方策 | 実機で学習させずに、実機に載せても押す課題をこなせた | 実機に載せる前に実機の試験をしなくてよいこと。この回が読んだ本文の外にあるパラメータ、範囲、成功率 |
ログインすると、このレッスンの続きと確認問題、解答を読めます。
制約と注意点
- Tobin らと Peng らはどちらも arXiv のプレプリントで、R レベルです。このページの数字はすべて著者の報告で、本サイトは再現していません。この回が読んだのは二本の論文の HTML 版の要旨と最初のいくつかの節(Tobin らは手法の節のモデル構造の冒頭まで、Peng らは状態と行動の定義まで)で、Peng らのランダム化したパラメータの一覧、範囲、成功率、試行回数も、Tobin らのアブレーションの結果も読んでいません。
- MuJoCo のドキュメントは v3.14.0 に固定しています。接触ペアの摩擦を solmix と priority で合成する規則は Contact parameters の節にあり、この回はその節を読んでおらず、標準の合成方法も述べていません。ほかのバージョンでは標準値や属性が異なる可能性があります。
- 次はこの回のモデル化の選択や推論で、原文にこう書かれているわけではありません。遅延をステップ幅の整数倍で再現すること(動画でもこの講座のやり方だと注記しています)。第 3 節と練習の単純化したモデル(瞬間的な力積、一定の滑り摩擦、g = 10 m/s²)と Δv の損失。「この軌跡で同定できるのは J ÷ m だけ」「遅延の情報はデータに含まれていない」は、いずれもこのモデルのもとでの推論です。ランダム化の範囲の余裕と、評価の段階の決め方。
- 第 3 節と練習のコップ B、コップ C、チーム Q、そしてすべての摩擦、質量、力積、速度、距離、遅延、ステップ幅の選択、回数、成功率は架空です。0.41、0.30、0.246 kg などは、これらの仮定のもとでしか成り立ちません。
- 動画の画面に表示された遅延の範囲 0〜40 ステップは、Notebook と同じだと注記されています。この回は Notebook を実行しておらず、そのステップ幅も確かめていないので、0〜80 ms への換算は標準のステップ幅のときにしか成り立ちません。動画は実機のフィードバックが少し遅れることが「多い」と述べていますが、この回が読んだ資料に対応する数字はありません。
- 紙の上の計算とシミュレーションの結果は、ハードウェアの安全性の検証ではありません。実機で試すときは、別に安全のための準備が必要です。
リンク
- フィジカルAIラボ:すべての数字を確認できるフィジカルAI講座(講座の概要)
- フィジカルAIラボ 2.4:Isaac Lab で並列に歩く練習――ベンチマーク表の 3 つの FPS 列を読み、学習コマンドから総ステップ数を計算する
- フィジカルAIラボ 2.1:MuJoCo でつかむ場面をつくる――XML に書かれていない質量・単位・ステップ幅・衝突ルールを計算で確かめる
- フィジカルAIラボ 1.8:評価――「差し引き +2」を対応表に分解し、失敗ラベルと乱数シードを計算で確かめる
- Tobin ら:Domain Randomization for Transferring Deep Neural Networks from Simulation to the Real World(arXiv 1703.06907)
- Peng ら:Sim-to-Real Transfer of Robotic Control with Dynamics Randomization(arXiv 1710.06537)
- MuJoCo ドキュメント XML Reference(v3.14.0):geom の friction
- MuJoCo ドキュメント XML Reference(v3.14.0):option の timestep